

Когда команда впервые поднимает локальную языковую модель, первый вопрос почти всегда один — хватит ли видеопамяти. Ошибка в расчете на пару гигабайт оборачивается тем, что модель загружается, но падает на первом длинном запросе. Или работает, но медленно, потому что часть весов выгружается в оперативную память. В этой статье разберем, из чего складывается потребление VRAM, как считать память для Llama 3, Mistral и Qwen, и почему KV-cache часто становится главным сюрпризом.
Из чего складывается потребление VRAM при инференсе LLM
VRAM при инференсе расходуется на четыре независимые компоненты, и каждая занимает свой объем памяти. Если по одной из них не хватает, фреймворк уходит в offloading — и скорость падает кратно.
Веса модели
Это самая большая часть, и ее объем зависит от количества параметров модели и формата хранения чисел. Например, Llama 3 70B в FP16 занимает около 140 ГБ — то есть 70 миллиардов параметров на 2 байта каждый.
KV-cache
Это память под промежуточные вычисления для каждого токена, и чем больше токены копятся в контексте, тем сильнее съедает кэш. У Llama 3 70B при контексте 32K в FP16 и батче 1 он занимает около 10 ГБ, потому что модель использует Grouped Query Attention с восемью KV-головами. Без GQA тот же кэш занял бы около 80 ГБ, больше самих весов в Q4.
Activations
Сюда попадают промежуточные тензоры одного forward-прохода. Для inference это всего пара ГБ, а вот для тренировки — порядки выше.
Overhead
Сюда входят CUDA-runtime, буферы фреймворка (vLLM, llama.cpp или Ollama) и служебные структуры. Поэтому на любую конфигурацию закладывайте 1–2 ГБ сверху.
В итоге VRAM считают по сумме всех четырех компонентов, а не по одному размеру модели, как часто делают по привычке.
Квантизация LLM: сколько памяти экономит каждый формат
Квантизация — главный рычаг, которым модель ужимают под доступную карту. Идея в общем простая: заменить точные 16-битные числа на компактные 4–8-битные, потерять немного качества и сильно сэкономить память.
Базовые форматы и сколько они едят на параметр:
- FP16 / BF16 — 2 байта. Полная точность. Стандарт весов из Hugging Face и базовый формат для inference.
- INT8 — 1 байт. Размер вдвое меньше, потери качества около 1%.
- Q8_0 (GGUF) — ~1.06 байта. Практически без потерь, ~0.5%.
- Q6_K — ~0.81 байта. Потери 1–2%.
- Q5_K_M — ~0.7 байта. Потери 2–3%.
- Q4_K_M — ~0.6 байта. Потери 3–5%, но модель сжимается в 4 раза. Стандарт consumer-сценариев.
- Q3_K_M — ~0.43 байта. Уже заметно по качеству, использовать осторожно.
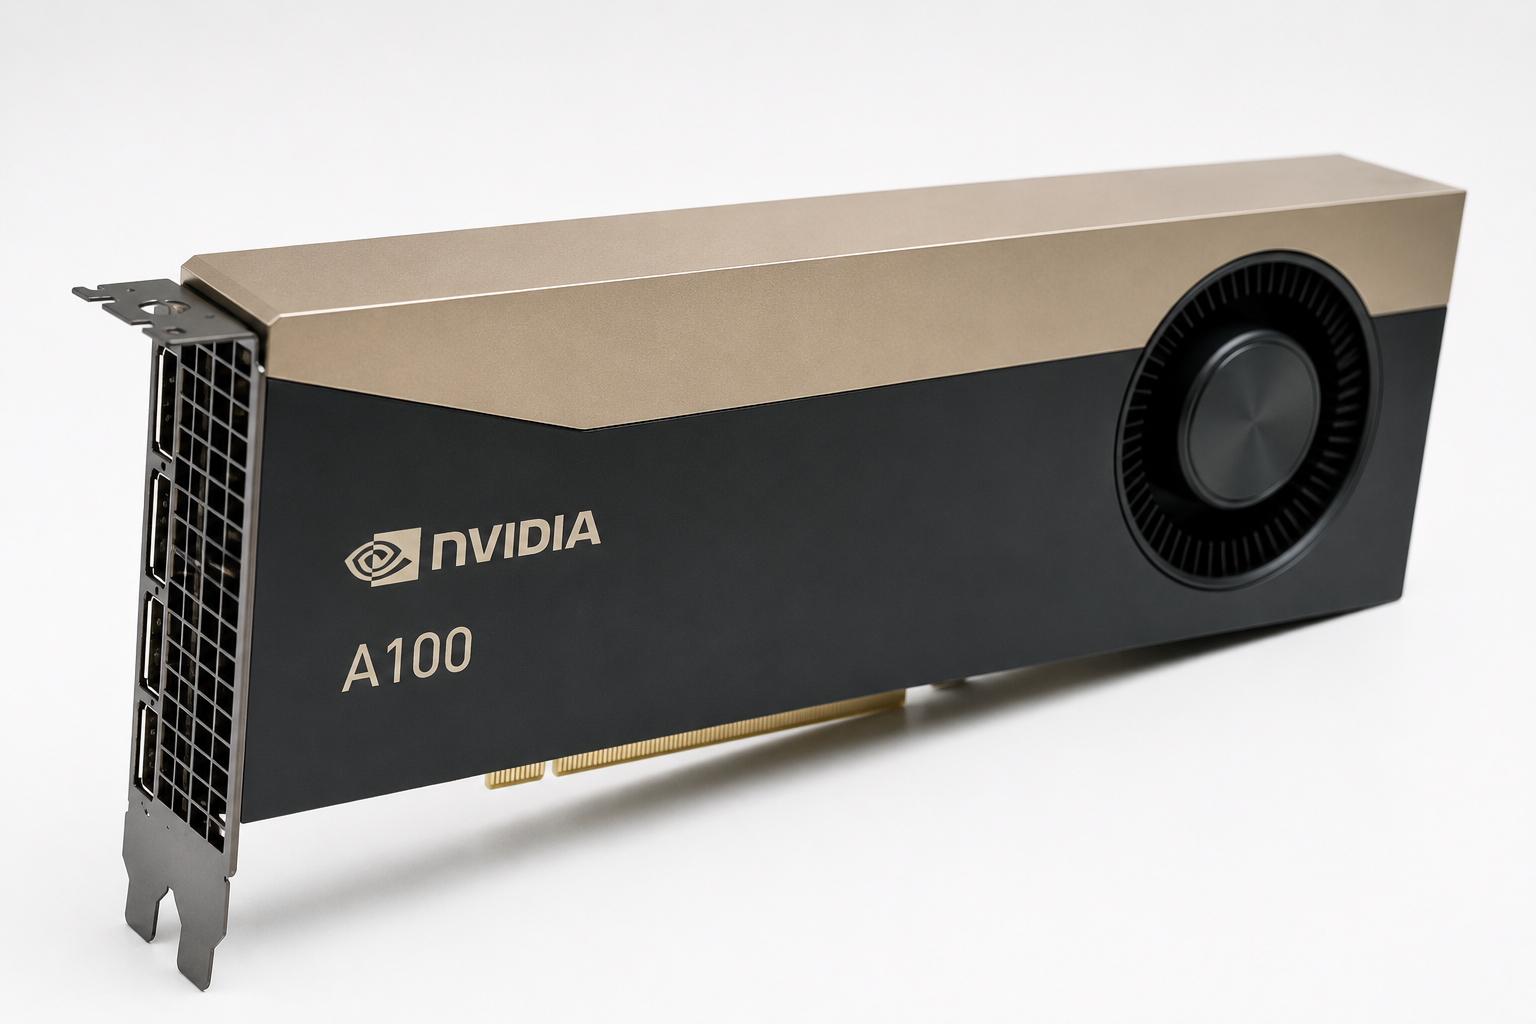
Чтобы было нагляднее, возьмем Llama 3 70B: в FP16 она весит 140 ГБ, а в Q4_K_M — уже 40–43 ГБ. Разница принципиальная: вторая помещается в одну A100 80GB, а под первую нужны уже две карты с NVLink.
Для быстрой оценки удобно правило: в Q4_K_M модель занимает около 0,6 ГБ на 1 млрд параметров, к этому добавляют KV-cache и 1–2 ГБ накладных расходов. По этому правилу модель на 8B занимает около 4,9 ГБ, на 20B около 12 ГБ, на 30B около 18–19 ГБ, а Llama 3 70B около 42,5 ГБ.
На практике Q4_K_M оказывается золотой серединой для большинства задач. Когда важна максимальная точность, разумно брать Q6 или Q8. А для исследований и сложных reasoning-сценариев — Q5_K_M, чтобы сохранить баланс между размером и качеством ответов.
Llama 3: требования к памяти для 8B, 70B и 405B
Требования Llama 3 к памяти зависят прежде всего от выбранного формата. В семействе Llama 3 сейчас три размера — 8B, 70B и 405B, и каждый рассчитан на свой класс железа.
Llama 3 8B
В FP16 ей хватит 14–16 ГБ, а в Q4_K_M — всего 5–6 ГБ. Поэтому она запускается на RTX 4060 Ti 16GB в Q4 или на RTX 4090 в FP16. По сути, любая современная карта тянет ее без напряжения.
Llama 3 70B
В FP16 это уже 140–145 ГБ, поэтому нужны две карты по 80 ГБ через NVLink. В Q4_K_M модель ужимается до 40–45 ГБ и помещается в одну A100 80GB или Hopper. На consumer-железе тоже есть вариант — связка из двух RTX 4090 24GB с offloading через llama.cpp, правда, скорость там заметно ниже. Если хочется компромисса по качеству, есть Q8_0 на 70–75 ГБ — он тоже укладывается в одну восьмидесятку.
Llama 3 405B
С самой большой версией все строго: в FP16 — около 810 ГБ, и без HGX-кластера на 8× H100 SXM5 не обойтись. Даже в Q4_K_M это 220–240 ГБ, то есть минимум 4× H100 80GB. На потребительском железе она не запустится никаким образом.
Поэтому если в проде планируется работать с Llama 3 70B или 405B, имеет смысл сразу подобрать сервер под локальный LLM — с расчетом VRAM не только на саму модель, но и на целевой контекст и concurrency.
Mistral и Mixtral: сколько видеопамяти нужно
Mistral 7B — самая популярная отправная точка для локального запуска LLM. Все семейство Mistral сейчас разбито на четыре главные линейки, и у каждой свой класс требований.
Mistral 7B
FP16 занимает 14 ГБ, а Q4_K_M — всего 4–5 ГБ. Этого хватает на любую карту от RTX 3060 12GB (в Q4) и выше. Поэтому Mistral 7B идеально заходит для прототипирования и небольшого продакшена.
Mixtral 8x7B
Здесь архитектура Mixture of Experts: 47B параметров суммарно, но активны только ~13B на токен. Это снижает compute, однако не VRAM — модель все равно должна загружаться в память целиком. В FP16 получается 93–95 ГБ, и нужны две A100 80GB. В Q4_K_M это уже 26–30 ГБ, и модель помещается в одну A100 40GB либо в RTX 4090 при условии квантизации KV-cache.
Mistral Small (22B)
В FP16 это 44 ГБ, а в Q4_K_M — 13–14 ГБ. Получается удобный середняк, который одна RTX 4090 24GB закрывает в Q4 без проблем.
Mistral Large 2 (123B)
В FP16 это уже около 246 ГБ, и для запуска нужны 4 карты по 80 ГБ. В Q4_K_M модель ужимается до 65–70 ГБ и помещается в одну H100 80GB.
Qwen 3: 8B, 14B, 32B и MoE-варианты
Видеопамять для Qwen считают отдельно, потому что у Qwen 3 особенно широкая линейка размеров плюс есть MoE-модели. Здесь мы пройдемся по dense-вариантам — MoE считается по другой формуле и требует отдельного разговора. Для примера расчёта под MoE-семейство рассмотрите, какой сервер нужен для DeepSeek.
Qwen 3 8B
В FP16 — около 16 ГБ, в Q4_K_M — около 5 ГБ. Это тот же класс, что Llama 3 8B и Mistral 7B, поэтому и железо подходит то же.
Qwen 3 14B
В FP16 модель занимает 28 ГБ, а в Q4_K_M — 8–9 ГБ. Поэтому в полной точности нужна A100 40GB. В Q4 ситуация мягче: модель помещается в RTX 4070 12GB с небольшим контекстом, а с запасом работает на RTX 4060 Ti 16GB или RTX 4090.
Qwen 3 32B
В FP16 это 64 ГБ, в Q4_K_M — 19–20 ГБ. На RTX 4090 24GB в Q4 получается впритык, но рабочий вариант. В FP16 без A100 80GB уже не обойтись.
Qwen 2.5 72B
Dense-модели на 72B в Qwen 3 нет, она осталась в предыдущем поколении Qwen 2.5. В FP16 она занимает около 145 ГБ, в Q4_K_M около 47 ГБ, то есть по требованиям близка к Llama 3 70B. Одна A100 80GB справится в Q4, а под FP16 нужны уже две 80-гигабайтных карты.
Кроме dense-моделей у Qwen 3 есть MoE-версии — Qwen 3 235B-A22B и 30B-A3B. Их VRAM считают по полному числу параметров, а не только по активным: модель все равно грузится в память целиком. На картах с HBM2e и HBM3 (A100, H100) MoE работает комфортнее за счет высокой пропускной способности памяти.
Контекст и KV-cache: как длина промпта влияет на VRAM
KV-cache VRAM часто игнорируют — и это самая дорогая ошибка при сборке стенда. Контекстное окно — длина промпта плюс ответ в токенах — напрямую определяет размер кэша. У 70B-моделей с длинным контекстом он не просто увеличивается, а становится больше самих весов. Если часть данных приходится размещать в оперативной памяти, оцените запуск LLM через llama.cpp: CPU, офлоад и подбор железа.
Формула расчета такая: KV-cache = 2 × n_layers × n_heads × head_dim × seq_len × dtype × batch. Здесь n_layers — число слоев трансформера, n_heads — число KV-голов модели (именно KV-голов, а не голов внимания, в архитектурах с Grouped Query Attention это разные величины), head_dim — размерность каждой головы, seq_len — длина контекста в токенах, dtype — размер типа данных в байтах, batch — размер батча. Двойка в начале — потому что отдельно хранятся ключи и отдельно значения.
Чтобы не зарываться в формулы, посмотрим на цифрах. Llama 3 70B построена на Grouped Query Attention с восемью KV-головами. Это принципиально меняет расчет: считать кэш через все 64 головы внимания, как для моделей старого поколения, — значит получить завышенные цифры в 8 раз.
Реальный KV-cache Llama 3 70B в FP16 при контексте 4K и батче 1 — около 1,25 ГБ. При 32K — около 10 ГБ. При 128K — около 40 ГБ. Если квантовать сам кэш в Q8, цифры еще вдвое ниже. И это все при том, что сама модель в Q4 занимает 40 ГБ.
Что с этим делать:
- Квантовать KV-cache в INT8. Снижает его в 2 раза практически без потерь качества. Поддерживается в vLLM и llama.cpp.
- Использовать PagedAttention в vLLM. Память выделяется страницами по требованию, фрагментация уходит — экономия 20–40% на KV-cache.
- Включить Flash Attention. Сам по себе VRAM не уменьшает, но снижает overhead на attention-операциях и ускоряет inference.
- Offloading. KV-cache можно частично выгружать в системную RAM. Скорость падает, но модель работает.
Если все способы экономии исчерпаны, можно разгрузить часть KV-cache в системную память. Но тогда сразу важно подобрать RAM для AI-сервера с запасом по объему и скорости, потому что без этого offloading быстро превращается в узкое горлышко.
Возьмем для примера Llama 3 70B в Q4 на одной A100 80GB при 32K контексте и батче 1: около 42,5 ГБ модель плюс 10 ГБ FP16 KV-cache (с учетом GQA) дают около 53 ГБ, и карта вмещает это с запасом под batch и activations. При батче 4 KV-cache вырастет примерно до 40 ГБ, в сумме около 83 ГБ, и тогда уже нужна либо INT8-квантизация кэша, либо вторая карта.
Формула расчета VRAM: модель плюс KV-cache плюс overhead
Формула расчета VRAM в сумме сводится к одной короткой строке:
VRAM = (P × b) + KV + A + O
Здесь параметры модели — это P, число обучаемых весов в миллиардах. b — это байт на параметр: для FP16 — 2, для INT8 — 1, для Q8_0 — около 1.06, для Q5_K_M — 0.7, для Q4_K_M — около 0.6. KV — это KV-cache по формуле выше. A — activations, обычно 1–3 ГБ на inference. И O — overhead фреймворка, еще 1–2 ГБ.
Пример 1. Llama 3 8B в Q4_K_M с контекстом 8K
Сама модель — 8 × 0.6 ≈ 4.9 ГБ, KV-cache в FP16 — около 1 ГБ (у Llama 3 8B он занимает около 0,125 МБ на токен), activations и overhead — еще 1.5 ГБ. В сумме получается около 7,5 ГБ. Это значит, что в RTX 4060 8GB модель помещается впритык, а в RTX 4070 12GB работает с приличным запасом.
Пример 2. Mixtral 8x7B в Q4_K_M с контекстом 16K
Модель — 47 × 0.6 ≈ 28 ГБ, KV-cache в FP16 — около 2 ГБ, overhead — еще 2 ГБ. Итого около 32 ГБ, и под такую конфигурацию минимум нужна A100 40GB.
Пример 3. Llama 3 70B в Q4_K_M с контекстом 8K
Модель — 70 × 0.6 ≈ 42 ГБ, KV-cache с учетом GQA — около 2,5 ГБ, overhead — 2 ГБ. В сумме около 46–47 ГБ, что свободно помещается в одну A100 80GB.
Эта формула работает под любую модель: подставляете параметры — и сразу получаете требование к карте. При батче 4 на том же контексте 8K KV-cache по той же формуле вырастет примерно до 10 ГБ, и сумма составит около 54 ГБ, что тоже помещается в одну карту на 80 ГБ.
Как подобрать GPU под целевую LLM-модель и сценарий
GPU для LLM всегда выбирают исходя из суммы VRAM и сценария использования, причем логика идет от модели к карте, а не наоборот. То есть сначала считаете нужную память по формуле, и только потом ищете ускоритель, который ее закрывает.
Прототипирование, R&D и модели до 14B
Для ПК с видеокартой на 8 ГБ золотая середина — модели 7–8B в Q4_K_M, на картах 12–16 ГБ комфортно работают модели до 14B, а для 20–30B нужна карта на 24 ГБ (модель на 20B в Q4_K_M помещается и в 16 ГБ, но впритык). На этих сценариях достаточно RTX 4090 24GB: она закрывает все вплоть до Qwen 3 14B в Q8_0 и Mistral Small в Q4. В качестве бюджетного варианта подойдет RTX 3090 24GB с поддержкой NVLink. А для Q4-моделей 7–8B хватит даже RTX 4060 Ti 16GB (у RTX 4060 всего 8 ГБ).
Локальный продакшен с моделями 22–32B Q4_K_M
Тут уже подойдет RTX 4090, либо связка из двух RTX 3090, либо A100 40GB. Когда дополнительно нужна высокая concurrent-нагрузка с десятками одновременных запросов, разумнее брать A100 с MIG — эта функция превращает одну карту в семь изолированных экземпляров с собственной памятью и compute.
Inference Llama 3 70B, Qwen 2.5 72B и Mistral Large в Q4
Здесь минимум — A100 80GB или Hopper 80GB. На consumer-железе тоже работает связка из двух RTX 4090 через llama.cpp, правда, скорость и стабильность ощутимо хуже серверных карт. Если же нужна полноценная четырехкартовая сборка на десктопных GPU, то есть готовые решения с приличным охлаждением — например, сборку на 4× RTX 4090 берут под inference-стенды и LoRA-fine-tuning.
FP16, тяжелый concurrent или контекст от 32K
В этих сценариях нужны две карты по 80 ГБ через NVLink или сразу HGX-шасси. Здесь без интерконнекта никак — обмен через PCIe в 5–10 раз медленнее, и token rate проседает кратно. Поэтому под такие конфигурации обычно собирают сервер с NVLink.
Llama 3 405B и сопоставимые гиганты
Это уже область HGX с 8× H100 SXM5 и NVSwitch. Других рабочих вариантов сегодня просто нет.
Сравнительная таблица: модель × квантизация × минимальная GPU
Таблица VRAM моделей LLM под разные форматы — самый быстрый способ сориентироваться по железу. Цифры в ней приблизительные, без учета KV-cache на длинном контексте.
| Модель | FP16, ГБ | Q8_0, ГБ | Q4_K_M, ГБ | Минимальная GPU (Q4) |
|---|---|---|---|---|
| Llama 3 8B | 14–16 | 9 | 5–6 | RTX 4060 8GB |
| Модель на 20B | 40 | 21 | ≈12 | 16 ГБ впритык, 24 ГБ с запасом |
| Модель на 30B | 60 | 32 | 18–19 | RTX 4090 24GB |
| Llama 3 70B | 140–145 | 70–75 | 40–45 | A100 80GB |
| Llama 3 405B | 810 | 410 | 220–240 | 4× H100 80GB |
| Mistral 7B | 14 | 7.5 | 4–5 | RTX 3060 12GB |
| Mixtral 8x7B | 93–95 | 50 | 26–30 | A100 40GB |
| Mistral Large 2 | 246 | 130 | 65–70 | H100 80GB |
| Qwen 3 14B | 28 | 15 | 8–9 | RTX 4070 12GB |
| Qwen 3 32B | 64 | 34 | 19–20 | RTX 4090 24GB |
| Qwen 2.5 72B | 145 | 77 | ≈47 | A100 80GB |
Главный вывод из таблицы: Q4_K_M снижает требование к VRAM в 4 раза против FP16. На 70B-классе это разница между кластером из четырех H100 и одной A100.
Заключение
VRAM для LLM = веса + KV-cache + activations + overhead. Считать нужно все четыре компонента, и особенно KV-cache на длинном контексте — у моделей старого поколения без GQA он становится больше самой модели. У современных моделей вроде Llama 3 70B, Qwen 3 и Mistral картина мягче: благодаря Grouped Query Attention кэш сжимается в 4–8 раз, и реальные требования куда ближе к самим весам, чем кажется по старым формулам.
Квантизация Q4_K_M снижает требование к памяти в 4 раза с приемлемыми потерями качества: Llama 3 8B и Mistral 7B в этом формате запускаются на любой карте от RTX 3060 12GB, а Llama 3 70B и Qwen 2.5 72B уже требуют A100 80GB или Hopper.
Поэтому алгоритм на каждый день простой: посчитайте требование по формуле, накиньте 20% запаса на KV-cache при росте контекста, заложите 1–2 ГБ overhead. И после того как с моделью и квантизацией определились, остается собрать конкретный GPU-сервер с правильным числом карт, охлаждением и сетевой подсистемой под целевую нагрузку.
Часто задаваемые вопросы (FAQ) о VRAM для LLM
Можно ли запустить Llama 3 70B на RTX 4090 24GB?
Только в Q4 и с offloading через llama.cpp. Целиком 40+ ГБ Q4-весов в 24 ГБ VRAM просто не влезут, поэтому часть слоев крутится на CPU, и скорость падает до 5–15 токенов/сек. Для прода это тесновато, а для эксперимента вполне сойдет. А вот на двух RTX 4090 модель уже работает уверенно.
Две RTX 3090 или одна A100 40GB — что выбрать?
Зависит от задачи. Если речь про inference small-mid моделей в Q4, то две RTX 3090 24GB с NVLink выходят дешевле и почти не уступают по скорости. А вот fine-tuning, MIG, ECC-память и серверное охлаждение — все это уже на стороне A100. Поэтому для R&D-стенда чаще берут пару 3090, а для продакшена и облака — A100.
Какая квантизация дает минимальную потерю качества?
По бенчмаркам Q8_0 теряет около 0.5%, Q6_K — 1–2%, Q5_K_M — 2–3%, Q4_K_M — 3–5%, но именно последний остается разумным компромиссом для большинства задач. А вот ниже Q4 у моделей уже падает осмысленность ответов на сложных запросах.
Сколько VRAM нужно дополнительно для длинного контекста (32K, 128K)?
Заметно. У Llama 3 70B KV-cache в FP16 при батче 1 занимает около 0,31 МБ на токен: 1,25 ГБ на контексте 4K, 10 ГБ на 32K и 40 ГБ на 128K. При батче 4 и контексте 32K кэш вырастает примерно до 40 ГБ и вместе с весами в Q4 уже не помещается в одну A100 80GB. Поэтому здесь выручают PagedAttention в vLLM и квантизация KV-cache в INT8: вместе они снижают требование в 2–4 раза. Возможности управления памятью зависят и от движка — Ollama, vLLM или LM Studio.
Можно ли запустить LLM на CPU без GPU?
Да, через llama.cpp с Q4_K_M. Скорость на современных Xeon или EPYC — 2–10 токенов/сек. Для сравнения, на GPU это 50–200 токенов/сек. Поэтому такой режим подходит для прототипирования и редкого использования, но не для серьезного прода.
Как считать VRAM для fine-tuning, а не только для inference?
Full fine-tuning требует памяти в 4–5 раз больше, чем inference, потому что к весам добавляются градиенты, состояния оптимизатора Adam и activations. А вот LoRA и QLoRA снижают нагрузку до 1.5–2× от inference — именно поэтому 70B-модели дотренировывают на одной A100 80GB.
Подойдет ли видеокарта без поддержки FP8 для LLM?
Да, подойдет. FP8 на Hopper и выше действительно дает прирост скорости 1.5–2× на трансформерах, но не обязателен. На A100 и RTX 4090 любые модели спокойно крутятся через FP16 и Q4 — просто чуть медленнее.
Влияет ли формат GGUF на потребление VRAM?
Нет, не влияет. GGUF — это просто контейнер для квантованных моделей в llama.cpp и Ollama. На потребление VRAM влияет уровень квантизации внутри контейнера — Q4_K_M, Q5_K_M или Q6_K. А сам формат GGUF на расход памяти не влияет.