

Распределение нагрузки
Распределение мощности видеокарты для параллельной обработки запросов и обеспечения минимального времени до первого токена (TTFT)
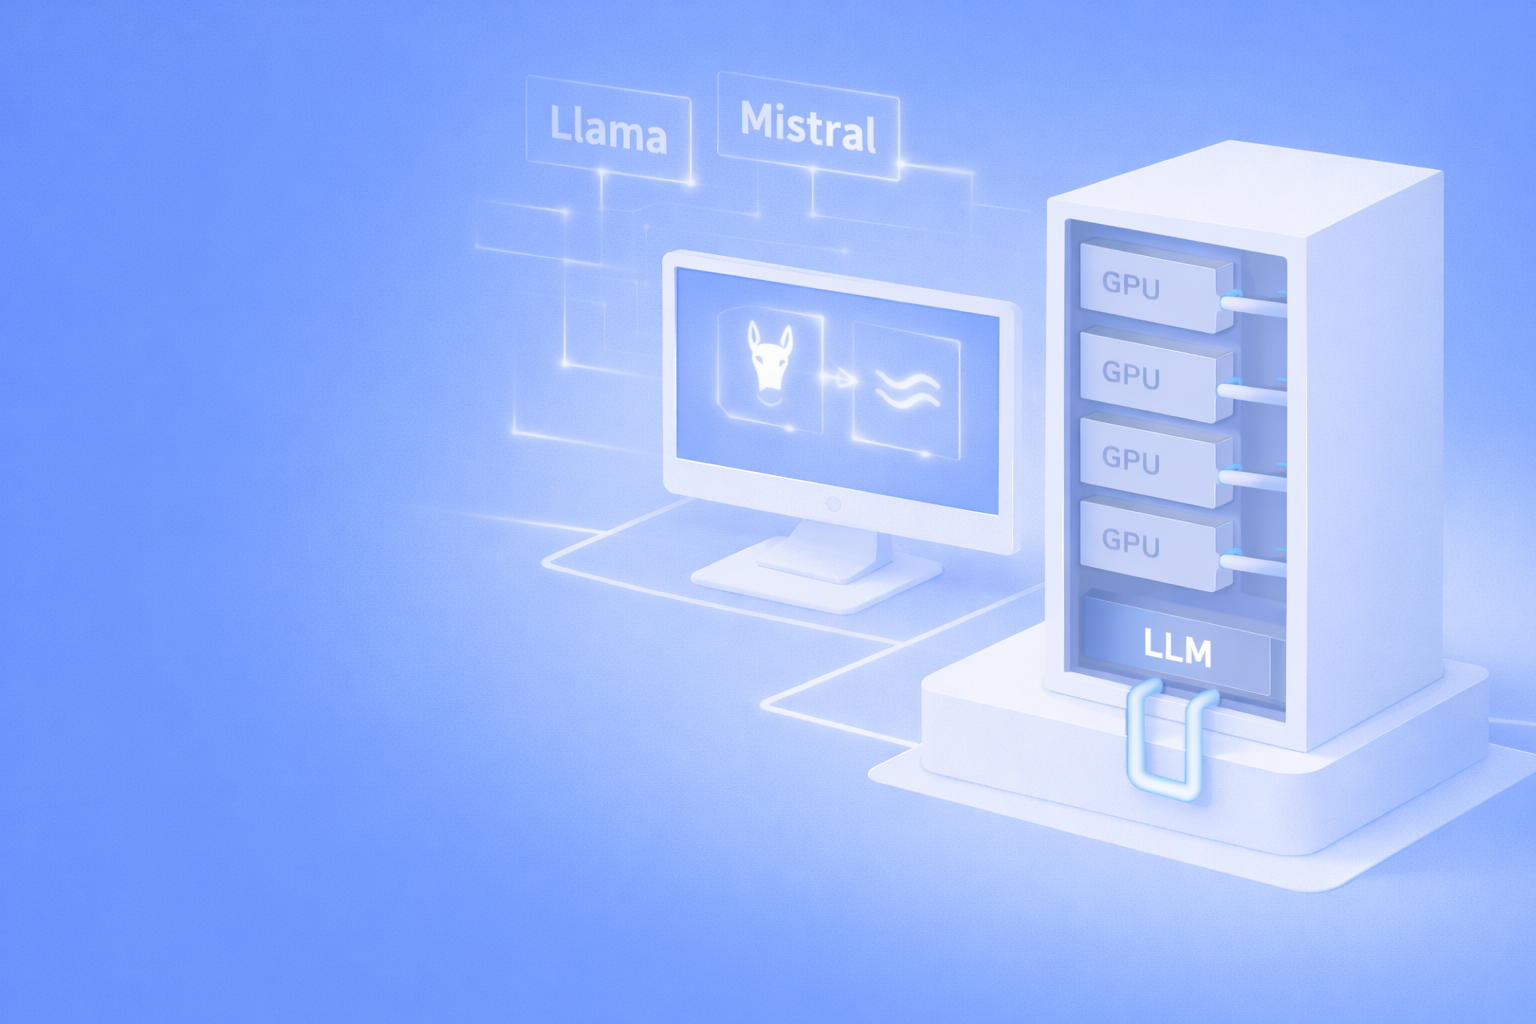
Правильный выбор аппаратной платформы позволит вашей команде сократить цикл разработки моделей, не сталкиваясь с ограничениями пропускной способности облачных API. Мы внедрим производительное решение, которое превратит обычный сервер в мощный вычислительный узел для безопасного и быстрого исполнения больших языковых моделей (LLM) в локальном контуре вашей компании
 В реестре

Рейтинг компании


Графический процессор определяет скорость генерации текста и возможность работы с длинными контекстными окнами при обработке больших баз данных. Наша команда поможет построить архитектуру, оптимизированную под запуск семейств Llama, Mistral и других открытых архитектур искусственного интеллекта
Распределение нагрузки
Распределение мощности видеокарты для параллельной обработки запросов и обеспечения минимального времени до первого токена (TTFT)
Высокая пропускная способность
Обеспечение высокой пропускной способности видеопамяти для работы с весами моделей без потери скорости инференса
Оптимизация видеопамяти
Реализация оптимального использования видеопамяти через методы квантования (INT8, FP8, 4-bit), позволяя запускать тяжелые модели на доступном железе
Надежная дисковая подсистема
Создание надежной дисковой подсистемы, способной мгновенно загружать чекпоинты нейросетей объемом в сотни гигабайт
Оптимизация расходов
Оптимизация расходов сервера, который обеспечит запуск конкретной версии LLM с максимальной эффективностью и без переплат за избыточные ресурсы
Масштабируемая вычислительная мощность и поддержка CUDA
Высокоскоростная память и оптимизация инференса моделей
Отказоустойчивость и настройка программного окружения
Оставьте заявку, и мы свяжемся с вами в ближайшее время

Оптимальный сервер для быстрых моделей (7B - 14B параметров)

Мощная станция для тяжелых моделей (30B - 70B параметров)

Серверные узлы для корпоративных кластеров и RAG-систем


Тщательный анализ требований конкретных семейств моделей (Llama 3, Mistral, Qwen) к объему VRAM

Точный расчет необходимой мощности блоков питания для обеспечения пиковых нагрузок при генерации

Оценка производительности центрального процессора для быстрой токенизации и препроцессинга текстов

Выбор оптимального типа охлаждения для поддержания акустического комфорта и температурных режимов
Проверка совместимости версий библиотек квантования с аппаратными возможностями видеокарты
Проектирование внутренней топологии сети для ускорения работы распределенных моделей

Создание регламентов обновления весов моделей для защиты процесса эксплуатации системы
Профессиональная инсталляция и настройка ИИ-стека
Масштабируемость и перенос вычислений в локальный контур
Регулярный аудит и мониторинг вычислительных ресурсов
Оставьте заявку, и наши инженеры подготовят проект, который будет полностью соответствовать вашим задачам по производительности и бюджету
При локальном запуске ваши данные (документы, переписка, код) не покидают периметр компании. Это гарантирует полную конфиденциальность и исключает возможность использования вашей интеллектуальной собственности для обучения сторонних моделей искусственного интеллекта.
Объем VRAM напрямую определяет максимальный размер модели и длину контекста, которые может обработать сервер. Мы поможем выбрать видеокарты nvidia с достаточным запасом памяти, чтобы вы могли использовать актуальные версии нейросетей без потери качества генерации.
Для небольших команд и тестов это допустимое решение, обеспечивающее отличную производительность. Однако для корпоративного использования мы рекомендуем профессиональные линейки, которые рассчитаны на работу 24/7 и обладают расширенной поддержкой в серверных ОС.
Первичный выбор конфигурации занимает 1-2 дня. После согласования параметров и поставки, наши специалисты проводят полную настройку системы «под ключ», включая развертывание выбранных вами моделей, что позволяет приступить к работе в кратчайшие сроки.
Заполните форму, и мы проведём бесплатный аудит: проверим серверы, сети и системы безопасности, определим риски и предложим план перехода на отечественное оборудование.