

Распределение мощности
Распределение мощности видеокарты между несколькими ускорителями для реализации технологий параллельных вычислений
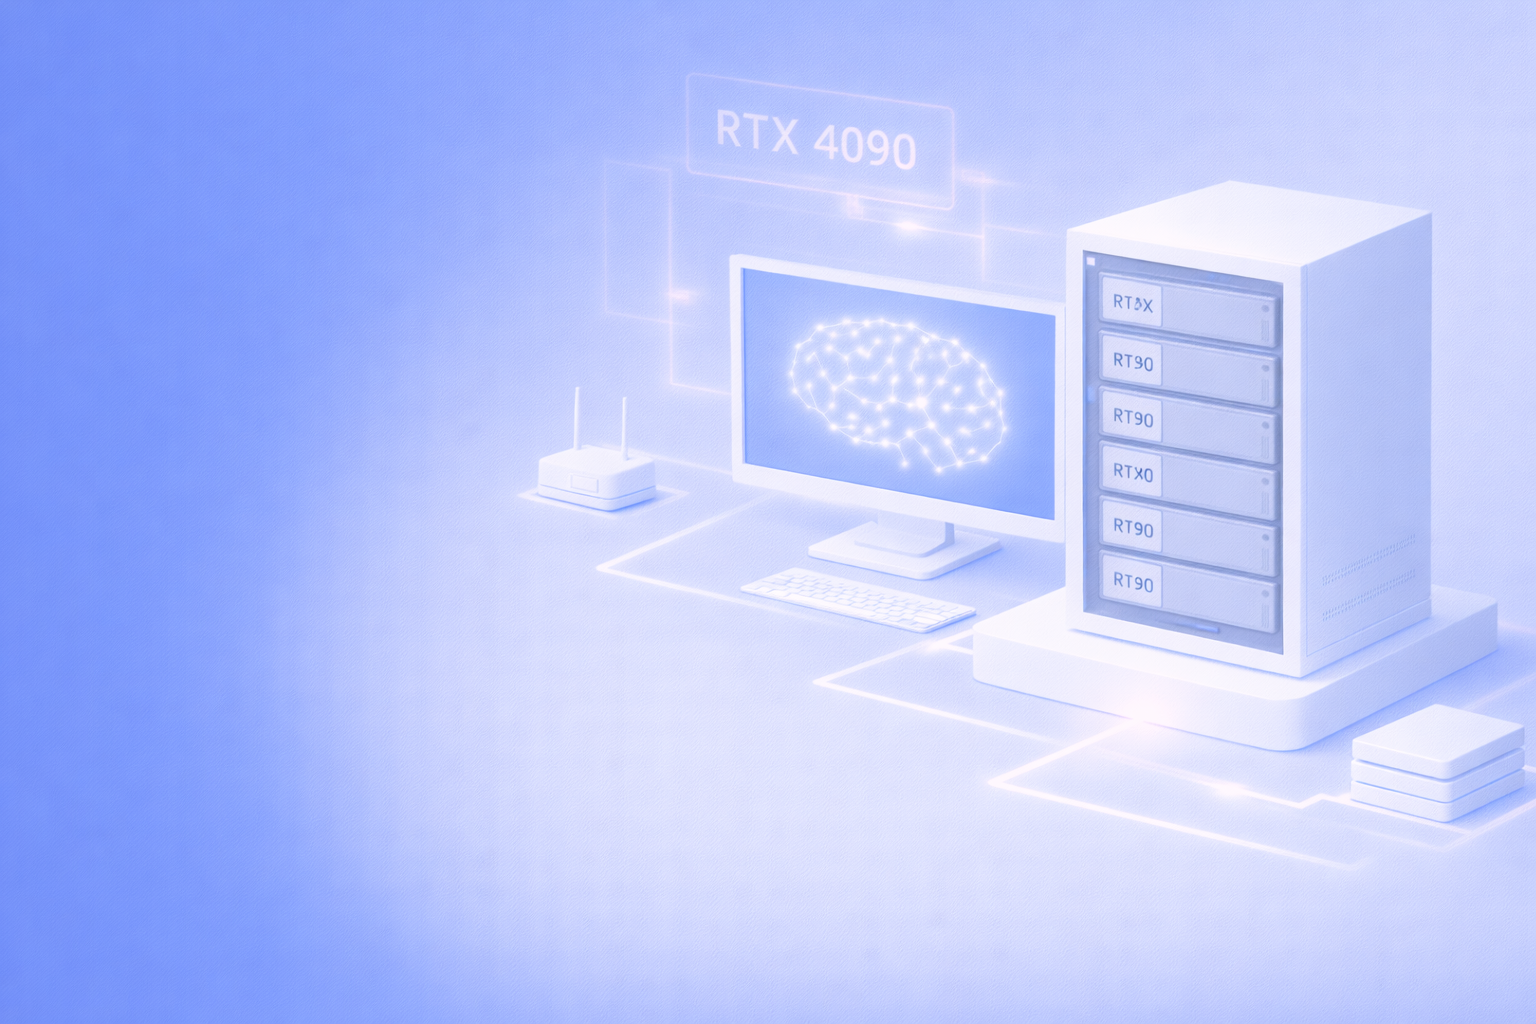
Правильный выбор ускорителей позволит вашей команде сократить цикл разработки моделей, не сталкиваясь с ограничениями пропускной способности памяти. Мы внедрим производительное решение, которое превратит обычный сервер в мощный вычислительный узел для решения сложнейших задач машинного обучения в локальном контуре предприятия
 В реестре

Рейтинг компании


Графический процессор определяет скорость сходимости нейросетей при обработке больших баз данных. Наша команда поможет построить архитектуру, оптимизированную под ваши специфические требования и задачи локального обучения
Распределение мощности
Распределение мощности видеокарты между несколькими ускорителями для реализации технологий параллельных вычислений
Высокая пропускная способность
Обеспечение высокой пропускной способности шины для быстрой синхронизации градиентов между картами geforce
Оптимизация видеопамяти
Реализация оптимального использования видеопамяти для работы с современными архитектурами моделей
Обучение ИИ
Создание надежной дисковой подсистемы, способной мгновенно подавать данные для обучения искусственного интеллекта
Оптимизация расходов
Серверы, которые обеспечат максимальный показатель производительности на ватт при обучении моделей
Система охлаждения: турбинные версии vs кастомное охлаждение в корпусе
Расположение слотов PCIe и пропускная способность шин
Блок питания и кабели 12VHPWR: безопасность и стабильность под нагрузкой
Оставьте заявку, и мы свяжемся с вами в ближайшее время

Запуск больших языковых моделей (LLM) с объемом VRAM 192 ГБ

Дообучение моделей (Fine-tuning) и генерация контента

3D-рендеринг и визуализация в реальном времени


Тщательный анализ требований конкретных архитектур нейросетей к объему видеопамяти

Точный расчет необходимой мощности блоков питания для работы карт в режиме максимального потребления

Оценка производительности CPU для эффективной работы загрузчиков данных

Выбор оптимального типа охлаждения для обеспечения стабильных температурных режимов
Проверка совместимости версий драйверов с актуальными релизами фреймворков
Проектирование внутренней топологии сети для ускорения распределенного обучения

Создание регламентов сохранения промежуточных результатов для защиты процесса обучения
Профессиональная инсталляция и настройка ML-стека
Масштабируемость и перенос локальных вычислений
Регулярный аудит и мониторинг вычислительных ресурсов
Оставьте заявку, и наши инженеры проведут детальный расчет ресурсов, подберут оптимальные ускорители и настроят систему под ключ. Мы подготовим проект, который полностью соответствует вашим научным и бизнес-задачам
Экосистема Nvidia предоставляет наиболее развитый стек программного обеспечения и библиотек CUDA. Это гарантирует максимальную производительность нейронных сетей и доступ ко всем современным методам оптимизации вычислений при локальной разработке.
CPU отвечает за препроцессинг данных и передачу их в видеопамять. Если процессор слишком слаб, мощные графические чипы будут простаивать. Мы поможем выбрать сервер с балансом между мощностью центрального процессора и количеством видеокарт.
Да, модель RTX 4090 обладает достаточным объемом памяти и производительностью для большинства задач. При правильном охлаждении и питании такие сборки показывают отличные результаты в 24/7 режиме, оставаясь доступнее по цене.
Минимальный рекомендуемый объем для комфортной работы начинается от 16–24 ГБ. Наличие четырех карт по 24 ГБ в одном узле позволяет работать с тяжелыми трансформерами и большими объемами входных данных.
Заполните форму, и мы проведём бесплатный аудит: проверим серверы, сети и системы безопасности, определим риски и предложим план перехода на отечественное оборудование.