


Команда запускает обучение языковой модели на сервере с восемью GPU. Ожидаемый прирост — восьмикратный. Реальный скейлинг выходит 4–5×: ускорители простаивают, пока данные перемещаются по перегруженной шине. Узкое место не вычислительная мощность GPU, а межсоединение между ними.
NVLink и NVSwitch — это инженерный ответ NVIDIA на ограничения PCIe при плотном GPU-to-GPU обмене. В этой статье разбираем, что собой представляют обе технологии, в каких сценариях за них стоит платить и где переплата не оправдана.
Что такое NVLink и NVSwitch и чем отличаются от PCIe
NVLink — прямая высокоскоростная шина между GPU NVIDIA в обход PCIe. NVSwitch — коммутатор NVLink: он соединяет все GPU сервера (например, 8 в HGX) по схеме «каждый с каждым» на полной скорости.
Поколения NVLink различаются скоростью: NVLink 3.0 даёт до 600 ГБ/с на GPU в платформах A100, NVLink 4.0 до 900 ГБ/с в H100 и H200, NVLink 5.0 до 1 800 ГБ/с в B200. Для сравнения: PCIe Gen5 x16 обеспечивает около 128 ГБ/с суммарно в обе стороны (около 64 ГБ/с в каждую), то есть в 4,7–14 раз меньше NVLink 3.0–5.0, и с заметно более высокой латентностью.
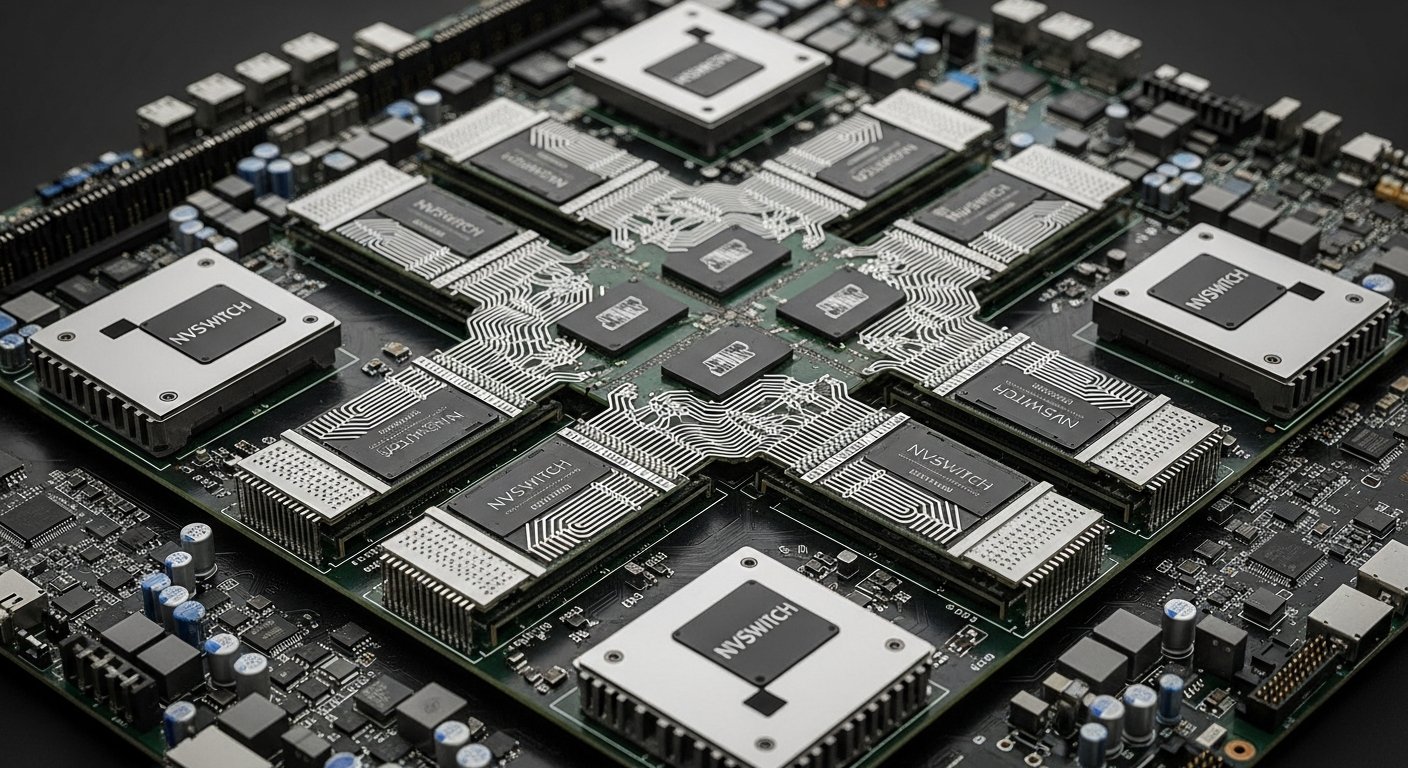
Технически NVSwitch объединяет несколько NVLink-каналов в полносвязную фабрику. Без него GPU соединены попарно, и обмен между несоседними ускорителями идёт через посредников. С NVSwitch каждый GPU напрямую общается с каждым на полной скорости. Это критично для тензорного параллелизма: операции над весами и активациями разбиваются между GPU и требуют синхронного обмена на каждой итерации.
Принципиальное отличие NVLink от PCIe — архитектурное: PCIe всегда проходит через хост-контроллер CPU, NVLink создаёт прямой путь между ускорителями.
| Шина | Пропускная способность | Характер обмена | Типичная роль |
|---|---|---|---|
| PCIe Gen 5 x16 | ~128 ГБ/с в обе стороны | Через хост-контроллер CPU, высокая латентность | Универсальное межсоединение |
| NVLink 3.0 (A100) | 600 ГБ/с | Прямой GPU–GPU, низкая латентность | Фабрика внутри сервера |
| NVLink 4.0 (H100/H200) | 900 ГБ/с | Прямой GPU–GPU, низкая латентность | Обучение LLM |
| NVLink 5.0 (B200) | 1 800 ГБ/с | Прямой GPU–GPU, минимальная латентность | Масштабный AI-инференс |
Различия самих ускорителей и доступных связей раскрывает сравнение A100, H100 и RTX 4090.
Какие задачи реально упираются в скорость GPU-to-GPU
Обучение больших моделей
При распределённом обучении применяются тензорный и пайплайн-параллелизм: веса и активации модели разбиваются между GPU, ускорители обмениваются градиентами на каждой итерации. Для моделей от 7B параметров пропускная способность шины между GPU напрямую определяет эффективность скейлинга. На NVSwitch-платформе скейлинг с одного GPU на восемь достигает 85–90% теоретического максимума. На PCIe-сборке с теми же GPU этот показатель падает до 50–60%, потому что ускорители большую часть времени ждут данных.
Если задача — обучение языковых, диффузионных или мультимодальных моделей от 7B параметров, переплата за NVSwitch-платформу отбивается за счёт того, что обучение не растягивается в полтора-два раза по времени.
Инференс больших моделей и MoE
Инференс крупных моделей часто требует распределять веса по нескольким GPU. Для архитектур mixture-of-experts (DeepSeek-MoE и аналогов) каждый запрос активирует разные блоки весов на разных ускорителях, которые должны синхронно обменяться промежуточными состояниями. На NVLink-фабрике латентность ответа сокращается на 30–50% по сравнению с PCIe-сборкой на том же наборе GPU. При продуктовом инференсе с SLA по времени отклика это прямой бизнес-эффект.
Чем крупнее модель и плотнее GPU-to-GPU обмен, тем сильнее оправдан выбор платформы с NVLink и NVSwitch. Для классических ML-задач (компьютерного зрения, малых трансформеров до 1B параметров, табличных моделей) узкое место обычно не шина, а объём памяти и производительность самих ускорителей. Пропускной способности PCIe Gen 4–5 здесь, как правило, хватает с запасом. Ориентир при выборе — размер целевой модели и тип параллелизма при её обучении или обслуживании.
Архитектура GPU-серверов с NVSwitch
NVIDIA HGX — базовая вычислительная плата с четырьмя или восемью GPU и встроенными NVSwitch-коммутаторами. Именно HGX обеспечивает полносвязную NVLink-фабрику: коммутаторы размещены прямо на плате и связывают все GPU без посредников. Актуальные конфигурации: HGX H100 8-GPU, HGX H200 и HGX B200. NVIDIA DGX — готовый сервер от NVIDIA на базе HGX-платы с фирменным программным стеком и контрактом поддержки. HGX и DGX — разные вещи: первое — вычислительная плата, второе — законченный сервер. При выборе конкретной HGX-платформы отдельно проверьте её требования к отводу тепла — жидкостное охлаждение GPU-сервера.
OEM-производители (Supermicro, Gigabyte, российские партнёры) используют те же HGX-платы в собственных корпусах, отличаясь питанием, охлаждением и сервисными контрактами. GPU-серверы для AI-нагрузок на базе HGX различаются именно обвязкой, а не внутренней фабрикой.
NVSwitch не является отдельным компонентом, который можно добавить апгрейдом. Это встроенная часть HGX-платы. Если сервер изначально собран на PCIe-райзерах с дискретными GPU, добавить NVSwitch-фабрику постфактум невозможно. Выбор архитектуры делается на этапе спецификации. Если в перспективе двух-трёх лет предполагаются модели от 70B параметров или собственные LLM, HGX-платформа с самого начала обойдётся дешевле, чем замена парка серверов через год.
Экономика: когда переплата окупается, а когда нет
Сравнение стоимости и эффекта
HGX-платформа с восемью H100 и NVSwitch обычно обходится в 1,5–2 раза дороже PCIe-сборки на тех же GPU при сопоставимых CPU, памяти и хранилище. Источник переплаты — сама HGX-плата, NVSwitch-чипы и более сложное охлаждение с высокой тепловой плотностью.
Для команд, обучающих языковые модели, разница окупается за счёт сокращения времени обучения. Если цикл на PCIe-сборке занимает 30 дней, а на HGX-платформе — 18, экономия машинного времени и зарплат команды покрывает разницу в CapEx за один-два цикла. Для продуктового инференса малых моделей или CV-задач переплата не оправдана: ускорители не простаивают из-за шины, нагрузка не требует плотного обмена. Для исследовательских команд с переменной нагрузкой разумный компромисс — 4-GPU HGX-платформа для постоянных задач плюс аренда облачных HGX-узлов под разовые большие обучения. Чистый CapEx-сценарий с 8-GPU HGX оправдан только при стабильной высокой загрузке.
Альтернативы и подводные камни
PCIe Gen 5 в связке с CXL подходит для задач без доминирующего GPU-to-GPU обмена: инференс малых моделей, CV-пайплайны, рендеринг. AMD Instinct MI300X использует собственную шину Infinity Fabric: это самостоятельная экосистема со своим ПО и драйверами, а не прямая замена NVLink в готовой инфраструктуре. Для распределённого обучения через несколько серверов используется InfiniBand NDR или HDR между узлами. Важно не смешивать уровни: NVLink — фабрика внутри одного сервера, InfiniBand — фабрика между серверами в кластере. Межузловой уровень подробнее разбирает материал «InfiniBand: сеть между GPU-серверами».
Подводные камни: NVLink — это NVIDIA-only, универсальной совместимости с оборудованием других производителей нет. NVSwitch не доустанавливается постфактум. Программный стек (PyTorch, NCCL, vLLM) должен поддерживать конкретное поколение NVLink-фабрики и быть собран с соответствующими бэкендами: несоответствие версий — частая причина того, что производительность платформы не выходит на ожидаемый уровень. Подобрать конкретные GPU под задачу и платформу удобно через GPU для серверных платформ.
Что проверить до подписания спецификации
Перед фиксацией конфигурации стоит провести тест на референсной нагрузке с той моделью и фреймворком, которые будут в продуктиве. Ключевые метрики: скейлинг с одного GPU до восьми на реальном датасете, латентность инференса при разных длинах промпта, потребление мощности и поведение охлаждения при длительной работе.
Вопросы поставщику до подписания: какое поколение NVLink в предлагаемой HGX-плате, включена ли диагностика NVSwitch-коммутаторов в контракт поддержки, какие версии NCCL и драйверов протестированы на этой конфигурации, есть ли готовые образы для развёртывания vLLM или PyTorch.
Готовность программной части к конкретному поколению оборудования сокращает время ввода платформы в эксплуатацию на недели. Отдельно нужно проверить пропускную способность сети между серверами: HGX-платформы с высокой вычислительной плотностью требуют соответствующего InfiniBand или Ethernet на уровне кластера, иначе узкое место переместится туда.
Заключение
Начните с целевой нагрузки. Если в продуктиве обучение моделей от 7B параметров или распределённый инференс архитектур от 70B, плотный GPU-to-GPU обмен гарантирован и NVLink с NVSwitch будут работать на вас каждый день эксплуатации. Если основная нагрузка — компьютерное зрение, малые трансформеры или инференс на одиночных ускорителях, PCIe-сборка решает задачу без переплаты.
Оцените горизонт планирования: платформа подбирается на три-пять лет, а заменить HGX-плату в уже собранном сервере нельзя. Если вы не уверены в масштабе будущих задач, разумнее начать с 4-GPU HGX-конфигурации и арендовать NVSwitch-узлы в облаке под пиковые обучения, чем переплатить за 8-GPU платформу с низкой загрузкой.
NVLink и NVSwitch — инженерное решение под конкретный класс задач. Если ваши модели требуют плотного обмена между GPU, эта технология убирает узкое место, которое не видно в спецификации, но отнимает треть реальной производительности.