

Что такое InfiniBand, обычно выясняют тогда, когда одного мощного GPU-сервера уже недостаточно и вычисления нужно распределить между несколькими узлами. Это специализированная сетевая технология для передачи больших объемов данных с высокой пропускной способностью и предсказуемой малой задержкой. В GPU-кластере она связывает серверы так, чтобы обмен результатами вычислений не превращался в длительное ожидание сети. Поэтому InfiniBand — это отдельная часть оборудования для ИИ-инфраструктуры, которую проектируют вместе с вычислительными узлами, а не ускоренная версия офисной сети.
Что такое InfiniBand и из каких компонентов состоит такая сеть
InfiniBand — это технология межсоединения вычислительных систем, рассчитанная на среды, где большое число узлов постоянно обменивается данными. В ее основе находится сетевая фабрика: каждый сервер подключен к ней через адаптер, а трафик проходит через специализированные коммутаторы. Фабрика управляется как единая система и знает доступные маршруты между конечными устройствами. За счет этого обмен не зависит от логики обычной корпоративной сети, где один и тот же транспорт обслуживает пользовательские запросы и служебный трафик. Именно это имеют в виду, когда спрашивают, что такое InfiniBand и что это за технология для дата-центра.
Термин «InfiniBand сеть» описывает не один кабель или отдельный коммутатор. Это согласованный комплекс, в котором должны совпадать несколько параметров:
- Поколение интерфейсов;
- Параметры соединений;
- Схема коммутации;
- Программная настройка.
Если один компонент работает на меньшей скорости, он ограничивает соответствующий путь, даже когда остальная часть фабрики поддерживает более широкую полосу.
Для сервера подключение выглядит как высокоскоростной канал к другим вычислительным узлам. Для приложения это среда, через которую библиотеки коллективных операций передают данные между GPU. В результате сеть становится частью вычислительного конвейера, а не внешним сервисом, который можно оценивать только по скорости загрузки файла.
Из чего строится InfiniBand-фабрика: от адаптера до оптики
На стороне вычислительного узла устанавливается InfiniBand-адаптер. Он принимает данные из памяти сервера или GPU и отправляет их в фабрику. При проектировании ИИ-систем используют серверные сетевые карты для InfiniBand-подключения, поскольку обычный сетевой интерфейс не обеспечивает тот же путь передачи и ту же предсказуемость задержки.
Коммутатор соединяет адаптеры и направляет пакеты по фабрике. В небольшом кластере все узлы могут подключаться к одному устройству. При росте системы коммутаторы объединяют в многоуровневую схему, чтобы сохранить доступную полосу между любыми парами серверов. Подробный выбор портовой емкости относится уже к проектированию конкретной конфигурации, но на базовом уровне роль коммутатора проста: он не выполняет вычисления, однако определяет, насколько свободно узлы обмениваются результатами.
Тип передающей среды выбирают по длине трассы и поддерживаемой скорости:
Типы передающей среды в InfiniBand
| Тип среды | Применение |
|---|---|
| Медная кабельная сборка | Короткие соединения внутри стойки |
| Оптический трансивер и волокно | Соединения между удаленными стойками |
Кабель нельзя считать второстепенным расходным материалом: неподходящая сборка может снизить доступный режим порта или привести к нестабильности канала.
Почему обычной сети не хватает GPU-серверам при обучении нейросетей
Один GPU обрабатывает собственную часть данных, после чего участники распределенного задания должны согласовать результаты. При обучении модели это повторяется на множестве шагов. Чем дольше идет синхронизация, тем больше времени дорогие ускорители не считают, а ждут завершения обмена. Поэтому важна не только пиковая пропускная способность, но и латентность каждого цикла.
Внутри одного сервера ускорители обмениваются данными через NVLink или NVSwitch — это быстро, потому что карты стоят рядом на одной плате. Как только вычисление выходит за пределы одного узла (а с несколькими GPU в стойке это происходит почти всегда), обмену нужен транспорт между серверами, и обычная сеть здесь становится узким местом быстрее, чем сами вычисления.
Программный стек тоже влияет на трафик:
- Драйверы NVIDIA и CUDA — предоставляют среду вычислений;
- NCCL — организует обмен данными между GPU;
- PyTorch и TensorFlow — используют эти механизмы при распределенном запуске;
- Docker — упрощает воспроизводимость окружения, но не устраняет сетевые задержки.
Если фабрика не успевает обслуживать синхронизацию, программная оптимизация не вернет потерянное время ускорителей.
Как RDMA связан с InfiniBand и почему это разные понятия
RDMA — механизм прямого доступа к памяти удаленного узла с минимальным участием центрального процессора и ядра операционной системы. InfiniBand — транспорт и сетевая среда, поверх которой такой механизм работает. Из-за этого термины связаны, но не взаимозаменяемы. RDMA может использовать и Ethernet в варианте RDMA over Converged Ethernet, тогда как InfiniBand изначально проектировался как фабрика для высокопроизводительного обмена.
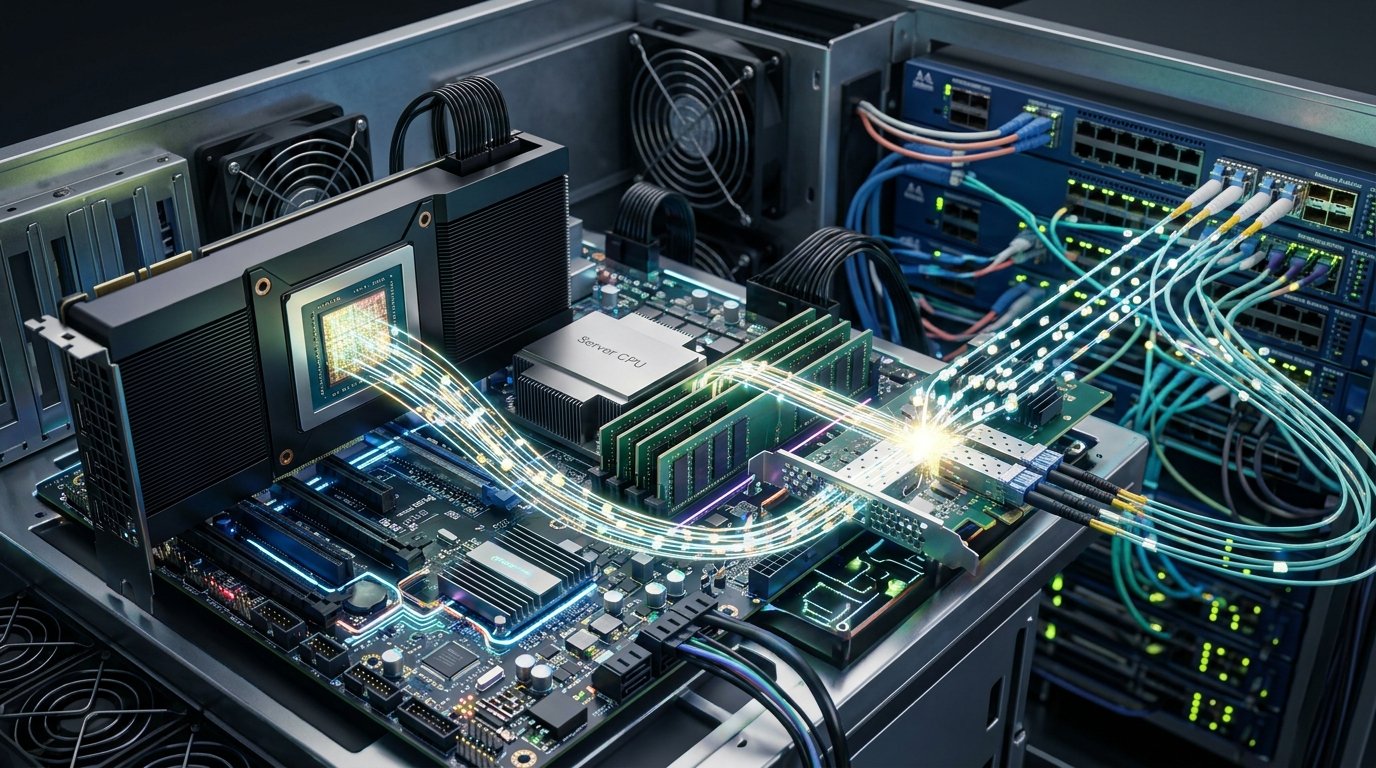
Для GPU-кластера эта связь важна потому, что сокращение промежуточных копирований уменьшает задержку. Технология GPUDirect RDMA позволяет сетевому адаптеру обращаться к памяти GPU без обязательного переноса данных через оперативную память CPU. Детальная механика RDMA требует отдельного разбора. Здесь достаточно зафиксировать границу понятий: InfiniBand отвечает за транспорт, а RDMA — за способ доступа к памяти и передачу данных.
Какую пропускную способность обеспечивает InfiniBand сегодня
Поколения InfiniBand различаются доступной скоростью порта:
Поколения InfiniBand и скорости портов
| Поколение | Скорость порта |
|---|---|
| HDR | до 200 Гбит/с |
| NDR | до 400 Гбит/с |
Это значения физического соединения, а не обещанная скорость отдельного приложения. Реальный результат зависит от числа параллельных потоков и топологии фабрики. На него также влияет эффективность программного стека.
При выборе поколения учитывают не только текущую нагрузку, но и то, сколько узлов появится позже и какие аплинки потребуются между уровнями сети. Смешение скоростей возможно, но медленное звено ограничит соответствующий маршрут. Поэтому пропускную способность фабрики оценивают по сетевым коммутаторам для InfiniBand вместе с адаптерами и кабельной системой, а не как изолированную позицию в спецификации.
Высокая полоса особенно заметна при all-reduce, когда все узлы одновременно обмениваются промежуточными результатами и ждут завершения обмена у всех участников. Эта операция генерирует большой объем трафика за короткое время. Если каналы заняты или имеют неодинаковую пропускную способность, часть GPU завершает обмен раньше и ожидает более медленные направления.
Где InfiniBand применяется в реальных проектах с GPU-серверами
GPU-серверы с InfiniBand решают три группы задач:
- Обучение больших нейросетей на нескольких серверах. Данные и параметры распределяются между GPU, а NCCL выполняет коллективные операции. Сеть используется непрерывно, поэтому даже небольшая задержка повторяется тысячи раз и накапливается в продолжительности задания.
- Высокопроизводительные вычисления, где узлы обмениваются промежуточными результатами моделирования. Схожие требования возникают в научных центрах и инженерных подразделениях. Для высоконагруженных проектов применяются платформы класса HGX или DGX, а коммутация настраивается как часть единой системы.
- Распределенный инференс — используется, если модель не помещается в память одного узла. Однако не каждый сервис генерации ответов нуждается в такой фабрике.
Для организаций, закупающих такую инфраструктуру по 44-ФЗ или 223-ФЗ, у Serverzilla есть соответствующая аккредитация.
Когда InfiniBand оправдан, а когда достаточно обычной сети
InfiniBand оправдан, когда производительность задания зависит от частого обмена между узлами. Признаки такого сценария — распределенное обучение и параллельная работа десятков GPU. Дополнительным аргументом становится требование к предсказуемой задержке: средняя скорость канала мало помогает, если отдельные пики латентности регулярно останавливают синхронизацию.
Обычной сети может быть достаточно для управления серверами и загрузки данных перед запуском задания. Она подходит и для вычислений, которые почти не обмениваются результатами во время работы. Если модель работает на одном сервере и межузлового обмена нет, основную роль играют объем видеопамяти и локальная связь между картами.
Разделение управляющего и вычислительного трафика часто делает архитектуру понятнее:
Распределение сетевых функций
| Сеть | Роль |
|---|---|
| Ethernet | Доступ и мониторинг серверов |
| InfiniBand | Межузловые операции GPU |
Перед следующим этапом проектирования полезно зафиксировать два ответа. Первый — сколько данных узлы передают на каждом шаге вычислений. Второй — какой простой допустим для GPU во время синхронизации. Если оба показателя существенны, отдельно рассчитайте фабрику и число портов. Затем добавьте запас под рост. Если обмен эпизодический, сложная специализированная сеть может не дать соразмерного эффекта. Если задача требует точного сравнения с Ethernet по задержке и стоимости порта, это отдельный вопрос для следующего этапа изучения.