


Служба безопасности просит распознавать лица на проходных и считать людей в зале, а в ИТ-отделе вопрос: одной RTX 4090 хватит или нужен сервер с тремя картами? Без расчёта по числу камер и моделям выбор GPU превращается в гадание, а счёт в смете - в несогласованную позицию. Видеоаналитика на базе ИИ за последние два-три года перешла от детекции движения и подсчёта людей к распознаванию лиц, ре-идентификации между камерами и поведенческой аналитике - это разные классы нагрузки на железо: одни сценарии тянет L4, другим нужна L40S или несколько карт.
Дальше - как считать нагрузку на GPU по числу камер и типу моделей, какой класс ускорителей подходит под детекцию объектов, распознавание лиц и поведенческую аналитику, и куда разумнее ставить обработку: централизованно, на edge или гибридом.
Что такое современная видеоаналитика на ИИ
Классические VMS отличали движение в кадре по пикселям и давали тысячи ложных срабатываний от листвы, теней и засветок. Нейросетевые модели работают иначе: они понимают сцену. Детекция отвечает на вопрос «кто или что в кадре» - человек, автомобиль, животное. Классификация уточняет тип: легковая, грузовик, мотоцикл. Трекинг отслеживает объект между кадрами одной камеры. Ре-идентификация (Re-ID) узнаёт того же человека на разных камерах объекта.
Распознавание лиц стоит отдельным классом: детекция лица, выделение вектора признаков, сверка с базой. По нагрузке на GPU это тяжелее обычной детекции. Применения - корпоративная безопасность с контролем зон, ретейл-аналитика с подсчётом посетителей, дорожный трафик с распознаванием номеров, промышленная безопасность с контролем СИЗ и опасных зон.
Какие задачи и сколько мощности они требуют
Базовая детекция и классификация
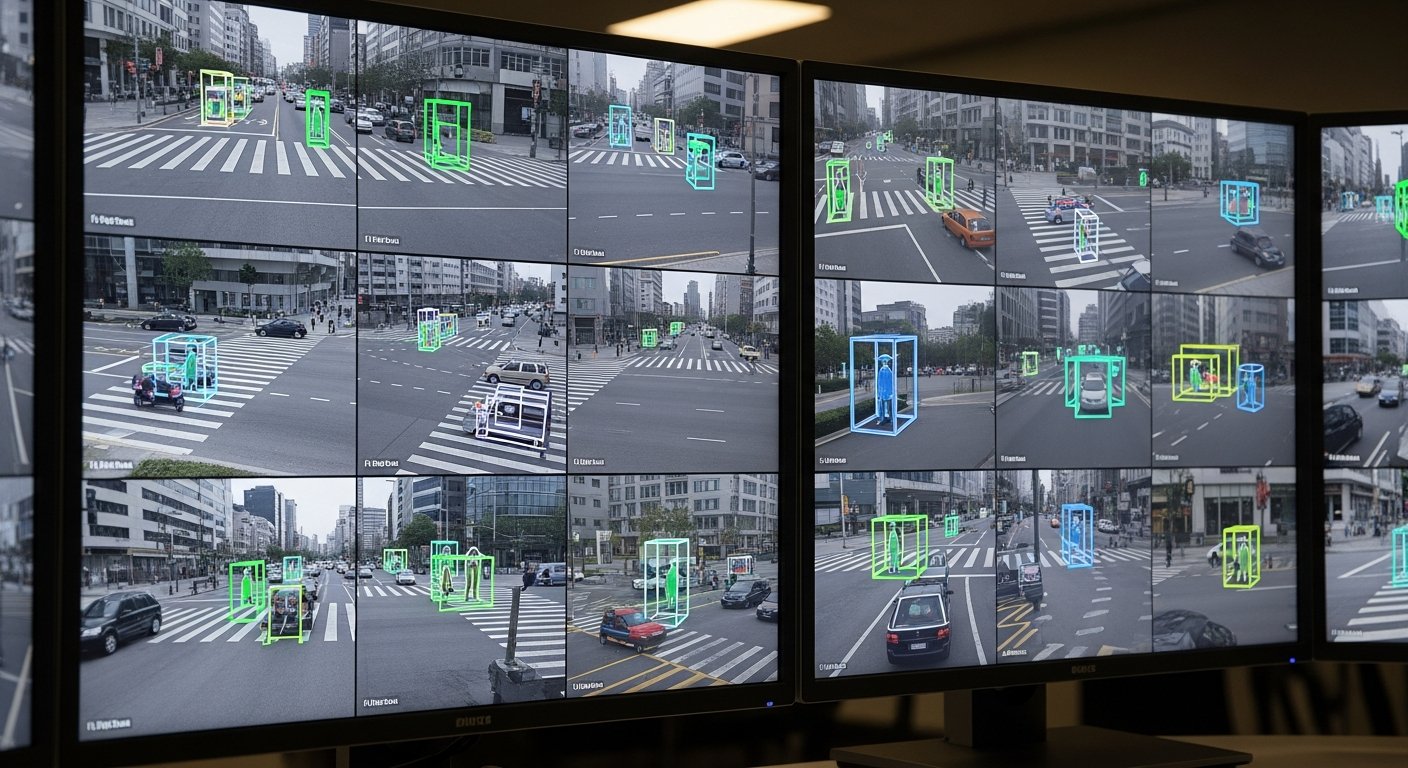
Детекция объектов на YOLO-семействе моделей (YOLOv8, YOLOv11) - самый массовый класс задач. Модели лёгкие: на потоке 1080p одна RTX 4060 с 8 ГБ VRAM (архитектура Ada Lovelace) ведет базовую детекцию на десятках камер при анализе 10 кадр/с, а при непрерывных 25 кадр/с каналов примерно в 2,5 раза меньше. Но 8 ГБ VRAM - реальный потолок для базовой детекции: как только в пайплайне появляются классификация плюс распознавание лиц, либо YOLOv11x вместо облегчённой YOLOv11n, память заканчивается, и приходится переходить на L4 с 24 ГБ или RTX 4070 Ti SUPER с 16 ГБ. RTX 4060 подходит для пилотов и проверки концепции, для продакшена с несколькими моделями одновременно нужна карта с большим VRAM.
Классификация типа объекта добавляет 10–20% к нагрузке от детекции - запас на той же карте уменьшается, но карта продолжает справляться. Подсчёт людей и трекинг по одной камере - лёгкая задача: на детекции людей и машин серверная L4 с 24 ГБ VRAM и TDP 72 Вт обрабатывает 80–120 каналов (1080p, анализ 10 кадр/с).
Чтение автомобильных номеров (ANPR/LPR) - пайплайн «детекция номера, выделение, OCR». Одна L4 обрабатывает 60–80 каналов, RTX 4060 30–40 (1080p, анализ 10 кадр/с), при непрерывном анализе 25 кадр/с цифры делят на 2,5. Они ориентировочные и зависят от видеосистемы, модели и разрешения. Как собрать под эту задачу весь комплекс, разбирает статья про сервер для распознавания автомобильных номеров.
Сложные сценарии: лица, ре-идентификация, поведение
Распознавание лиц с поиском по базе - тяжёлый пайплайн: детекция лица, выделение embedding, поиск по базе. На распознавании лиц RTX A2000 и RTX 4060 обрабатывают 15–20 каналов, RTX A4000 25–35, L4 40–60, L40S 100–120 (1080p, анализ 10 кадр/с). Ре-идентификация требует попарного сравнения embedding-векторов каждого нового объекта со всеми ранее зафиксированными по сети камер: при N активных объектах число сравнений растёт как N², отсюда и квадратичная нагрузка. На 200 камерах с десятками человек в кадре это уже задача под несколько L40S. Поведенческая аналитика (падение, драка, оставленный предмет, проход против потока) работает с временными последовательностями и тяжелее статической детекции в 2–3 раза. Совмещение нескольких задач на одной камере суммирует нагрузку, критичен запас VRAM, чтобы модели одновременно помещались в память GPU.
| Задача | VRAM на поток | FPS на 1 камеру 1080p | Камер на одну L40S 48 ГБ |
|---|---|---|---|
| Детекция объектов (YOLOv8/v11) | 0,3–0,5 ГБ | до 25 | Больше, чем на L4 (80–120) |
| Классификация типа объекта | 0,4–0,6 ГБ | до 25 | Немного меньше, чем на детекции |
| Распознавание лиц с базой 10–50 тыс. | 1,5–2 ГБ | 10–15 | 100–120 |
| Ре-идентификация (Re-ID) | 2–4 ГБ | 5–10 | 8–15 |
Цифры ориентировочные, для 1080p и анализа 10 кадр/с: при непрерывных 25 кадр/с их делят на 2,5, а точные значения зависят от видеосистемы и моделей.
Сервер для видеоаналитики: какое железо нужно
Сервер для видеоаналитики собирается под четыре компонента, и на каждом есть характерные узкие места.
CPU. На декодирование потоков уходит заметная часть нагрузки: для 32 камер 1080p 25 FPS на программном декодировании нужно 16+ ядер Xeon Scalable или AMD EPYC. На GPU NVIDIA есть аппаратный декодер NVDEC, он разгружает CPU, но имеет лимит потоков на карту.
GPU. Главный компонент: подбор зависит от задач и числа камер, об этом отдельный раздел ниже. В сервер ставится от 1 до 8 GPU. Когда понятно число камер, разрешение и тип аналитики, удобнее отталкиваться от готовых конфигураций - сервер для нейросетей в реальном времени уже сбалансирован под обработку видеопотоков: достаточная пропускная способность сети, NVMe под модели, питание и охлаждение под несколько L40S.
RAM. Объем памяти считают от видеокарт: не меньше двойного объема памяти всех GPU, поэтому серверу с четырьмя L40S нужно от 384 ГБ ECC, а под нагруженные сценарии с базами лиц и Re-ID до 512 ГБ. Ориентиры для меньших объектов приведены в таблице ниже. Меньше - узкое место при загрузке моделей и буферизации. Диски. ОС и модели на NVMe SSD от 1 ТБ, если сервер пишет видеоархив (совмещённый VMS плюс аналитика) - отдельный том на HDD 8–16 ТБ в RAID.
Сеть. 32 камеры 2 Мпикс дают около 50–80 Мбит/с - 1 Гбит/с справится без запаса, на 64+ камер уже нужно 10 Гбит/с.
Питание. Сервер с четырьмя RTX 4090 - около 2 кВт пиковой нагрузки: ИБП с запасом и прецизионное охлаждение в серверной.
Сколько оперативной памяти нужно для видеоаналитики
Объем памяти зависит от числа камер и от того, есть ли поиск по базе лиц.
| Сценарий | Оперативная память |
|---|---|
| Пилот на 4–8 камер | 16 ГБ |
| 16 камер | 32 ГБ |
| 64 камеры | 64–128 ГБ |
| Поиск по базе лиц | Не меньше 64 ГБ |
Общее правило: оперативной памяти сервера должно быть не меньше двойного объема памяти всех видеокарт, она нужна под буферы декодирования и очереди кадров. Для сервера с несколькими картами правило дает больше, чем таблица: например, четыре L40S по 48 ГБ требуют не меньше 384 ГБ. Чем сервер с видеокартами отличается от обычного по питанию, охлаждению и компоновке, объясняет статья о том, что такое GPU-сервер.
Подбор GPU под задачу видеоаналитики
От L4 и RTX 4060 до A100: где какая нужна
GPU для видеоаналитики делятся на три класса по тепловому пакету и объёму VRAM.
Entry-level. NVIDIA L4 - серверная карта малой мощности с активным NVENC/NVDEC, 24 ГБ VRAM, TDP 72 Вт. На детекции людей и машин одна L4 обрабатывает 80–120 каналов, на распознавании номеров 60–80, на распознавании лиц 40–60 (1080p, анализ 10 кадр/с), при непрерывных 25 кадр/с цифры делят на 2,5. Карта устанавливается в 1U-серверы без жидкостного охлаждения. RTX 4060 и 4070 - потребительские аналоги для пилотов и тестовых стендов.
Средний сегмент. NVIDIA L40S, 48 ГБ VRAM, TDP 350 Вт — карта для тяжелых сценариев: на распознавании лиц она обрабатывает 100–120 каналов (1080p, анализ 10 кадр/с), а большой объем памяти позволяет держать на ней одновременно несколько моделей. RTX 4090 - потребительский аналог с меньшим VRAM и ограничениями NVIDIA EULA на использование в дата-центрах.
Серверный класс. A100 и H100 — ускорители для обучения моделей и больших вычислений, для типовой видеоаналитики они избыточны: профильная карта для видео — L4, также применяют L40S и RTX A-серии.
Российские альтернативы. На момент публикации готовых серверных GPU класса L40S или A100 российского производства в открытой продаже нет. Edge-NPU есть, но они рассчитаны на одну-две камеры на устройство.
Что выбирать при анализе 10 кадр/с: детекция до 80–120 камер, распознавание номеров до 60–80 и распознавание лиц до 40–60 камер укладываются в одну L4, распознавание лиц на 100–120 камерах в одну L40S. Дальше добавляют карты в сервер или ставят дополнительные серверы.
Архитектура: куда ставить видеоаналитику
Когда GPU подобран, остаётся вопрос размещения обработки. Вариантов четыре, и они сосуществуют в реальных проектах. Сначала сопоставьте возможности записи и обработки на двух платформах — NVR или сервер видеонаблюдения.
- Централизованный сервер. Все потоки приходят на один сервер с GPU. Плюс - единое управление, минус - нагрузка на сеть и узкое место при отказе сервера.
- Edge-аналитика. Обработка на самой камере или на компактном устройстве рядом. Современные IP-камеры уже несут NPU на борту (Hikvision Acusense, Dahua WizMind, российские аналоги). Главное ограничение в эксплуатации: набор моделей закрытый и обновляется только прошивкой вендора. Свои алгоритмы - обученную под конкретный объект модель детекции спецодежды или классификации товаров на складе, загрузить нельзя: SDK проприетарный, без доступа к нейросетевому слою. Камера выдаёт только те события, которые вендор предусмотрел в прошивке: пересечение линии, оставленный предмет, подсчёт людей, иногда распознавание лиц по локальной базе. Кастомные сценарии - это уже центральный сервер.
- Гибрид. Базовая детекция - на камере, сложная аналитика (лица, Re-ID) - на центральном сервере по событиям. Часто оптимальная схема на крупных объектах с разнородной аналитикой.
- Облачная аналитика. Внешний провайдер обрабатывает поток. Подходит для пилотов, не подходит для объектов с требованиями по локальному хранению видеоданных - 152-ФЗ, КИИ.
Что выбрать под конкретный объект
- Малый объект до 16 камер с базовой детекцией. Сервер 2U с одной L4 или RTX 4060/4070, 64 ГБ RAM, NVMe SSD 1 ТБ. Этого хватает на типовую охранную задачу.
- Средний объект 16–64 камеры с детекцией и распознаванием лиц на проходных. Сервер 2U–4U с одной L40S или двумя L4, 128 ГБ RAM. Под Re-ID между этажами - сразу две L40S.
- Крупный объект от 64 камер с разнородной аналитикой. Сервер 4U с двумя-четырьмя L40S, 256+ ГБ RAM, 10 Гбит/с сеть. Для кампусов и логистики - кластер из нескольких таких узлов.
- Объект с требованиями КИИ или биометрией. Раздельная архитектура: отдельные серверы под видеоаналитику и под СКУД, видеоархив - на сертифицированной СХД.
Чего не делать
- Не выбирать GPU «с запасом 5×». Лишняя мощность не даёт ускорения, но добавляет к счёту и энергопотреблению.
- Не игнорировать стоимость лицензий ПО. Алгоритмы распознавания лиц и Re-ID лицензируются вендором отдельно, часто по числу камер или embedding в базе.
- Не путать FPS обработки и FPS записи. Запись - 25–30 FPS, аналитика обычно работает на 5–10 FPS, этого достаточно для большинства задач.
- Не размещать RTX 4090 в дата-центре для коммерческой ИИ-задачи без понимания EULA NVIDIA. Для дата-центра берут профильные карты: L4, L40S или RTX A-серии.
Ответы на частые вопросы
Какой минимальный объем RAM нужен для видеоаналитики?
Для пилота на 4–8 камер хватит 16 ГБ, для 16 камер нужно 32 ГБ. Дальше объем считают от видеокарт: оперативной памяти сервера должно быть не меньше двойного объема памяти всех GPU.
Подойдет ли RTX 4090 для видеоаналитики?
По вычислительной мощности да, но лицензионное соглашение NVIDIA для видеокарт GeForce ограничивает их установку в дата-центрах. Для сервера в стойке берут профильные карты: L4 или RTX A-серии.
Можно ли обойтись без видеокарты?
Для пилота можно: детекция объектов и распознавание номеров работают и на процессоре с поддержкой AVX, но только на небольшом числе каналов, точное число зависит от видеосистемы и модели процессора. Для рабочей системы с десятками камер и распознаванием лиц нужен GPU.
Что лучше: камеры с аналитикой или сервер?
На камере с NPU хорошо работает простая детекция: пересечение линии, оставленный предмет, подсчет людей. Распознавание лиц с поиском по базе, ре-идентификация и собственные модели работают только на сервере, поэтому на крупных объектах эти подходы совмещают.
Сколько камер тянет одна NVIDIA L4?
При анализе 10 кадр/с в разрешении 1080p: распознавание номеров на 60–80 камерах, распознавание лиц на 40–60, детекция людей и машин на 80–120. При непрерывном анализе 25 кадр/с эти цифры делят на 2,5, а точные значения зависят от видеосистемы.
Заключение
Подбор железа под видеоаналитику - это расчёт по числу камер, разрешению и сложности моделей, а не выбор «самой мощной карты в каталоге». Малый объект - L4 или RTX 4060/4070, средний - L40S, крупный - связка из нескольких L40S. Архитектура - централизованная для большинства задач, гибрид с edge для крупных объектов с разнородной аналитикой, лицензии ПО считать вместе с железом. Когда сценарий выбран и понятно, какие модели и сколько камер будут работать, дальше это вопрос комплектации: готовые AI-серверы под задачу видеоаналитики, ML-обучения или инференса подбираются по балансу GPU, CPU, RAM и сети, а не собираются из отдельных позиций.