

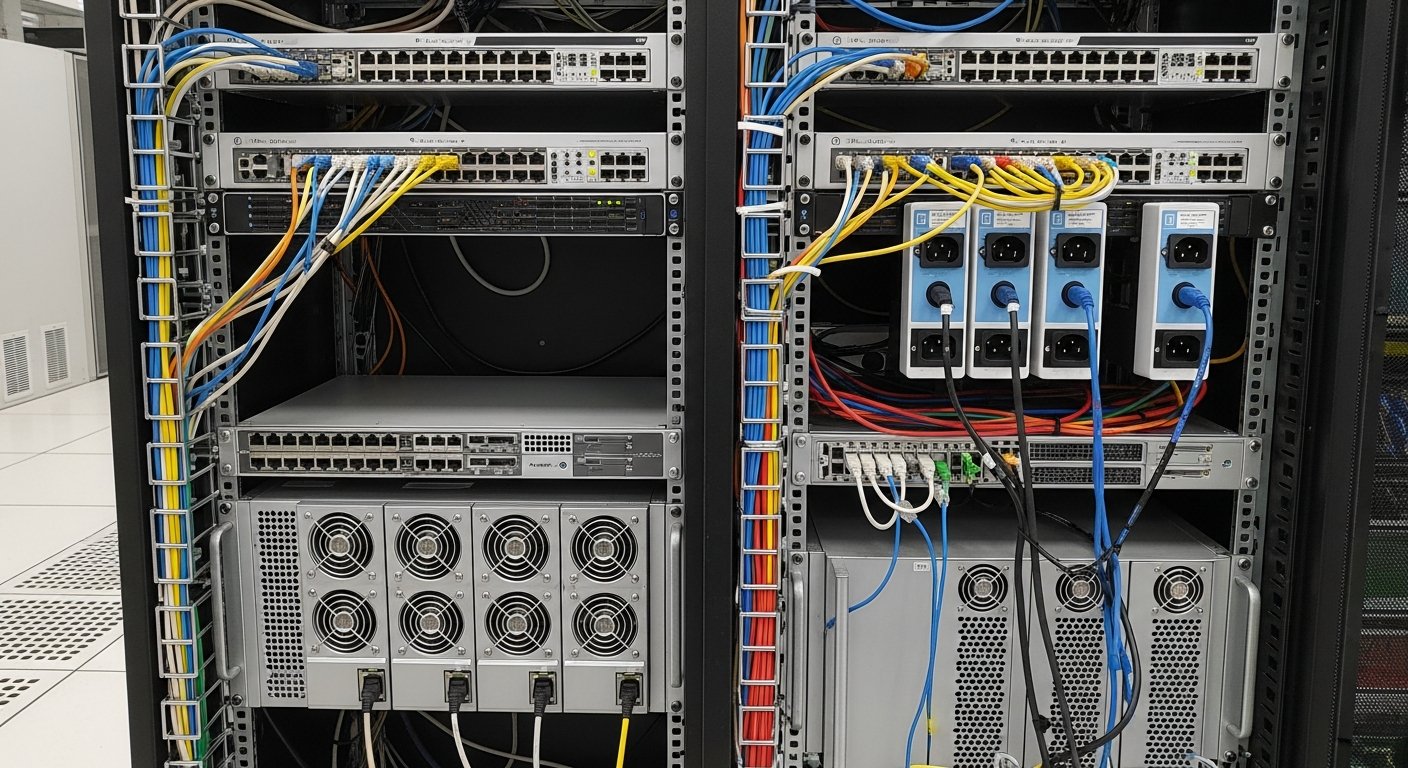
Единственный core-коммутатор без резерва — это RTO в несколько часов при его отказе. Один провайдер — простой при любой аварии на последней миле, которую не контролирует ни вы, ни провайдер. Отказоустойчивая сеть устроена иначе: каждая критичная точка дублирована, и при отказе любого компонента трафик перетекает на резерв за миллисекунды или секунды, без участия администратора. Резервирование коммутаторов строят на MLAG или стеке, каналов — на LACP, шлюза по умолчанию — на VRRP. В статье разберем, как правильно строить резервирование на каждом уровне модели OSI — от физических кабелей до BGP с двумя провайдерами, какие протоколы (LACP, MLAG, STP, VRRP, BGP) что решают, и как выбрать российские коммутаторы Eltex, QTECH или Bulat под кластерный аплинк.
Что такое отказоустойчивая сеть
Если коротко — это сеть, в которой нет единой точки отказа на критичных направлениях. Любое отдельное устройство, кабель или линк может выйти из строя, и инфраструктура продолжит работать.
Резервирование убирает единые точки отказа
Резервирование строится на уровнях: физические линки, коммутаторы, маршрутизаторы, каналы провайдеров. Если в стойке один коммутатор — он сам становится точкой отказа. Два коммутатора с правильно настроенным MLAG и кросс-кабелями — это уже резерв: один умер, второй забрал нагрузку. То же самое с провайдерами интернета, линками между ЦОД, блоками питания, кабельными трассами.
Отказоустойчивость vs пропускная способность: не одно и то же
Часто путают: «у меня два аплинка по гигабиту, значит сеть отказоустойчивая». На деле два линка в LAG только удваивают пропускную способность, а если оба идут в один коммутатор — это все еще одна точка отказа. Резервирование подразумевает: при отказе любого ОДНОГО устройства трафик идет другим путем. Пропускная способность — это про производительность и SLA, отказоустойчивость — про доступность.
Уровни L1, L2, L3 и где резервировать каждый
На физическом уровне (L1) дублируются кабели, оптика, медь, блоки питания. На канальном (L2) — коммутаторы через LACP, link aggregation, MLAG, stack и протоколы STP/RSTP. В дата-центрах вместо классического STP сейчас строят фабрики leaf-spine с маршрутизацией до коммутатора доступа и EVPN-VXLAN поверх нее. Протоколы SPB (Shortest Path Bridging) и TRILL тоже дают активные параллельные пути без блокировок, но встречаются заметно реже. На сетевом (L3) — маршрутизаторы и шлюзы через VRRP, HSRP, GLBP, BGP. Грамотная архитектура резервирует все три уровня, иначе одна слабая точка ломает всю схему.
Резервирование на уровне физики (L1)
Здесь начинается самое скучное и одновременно самое надежное — физические компоненты сети.
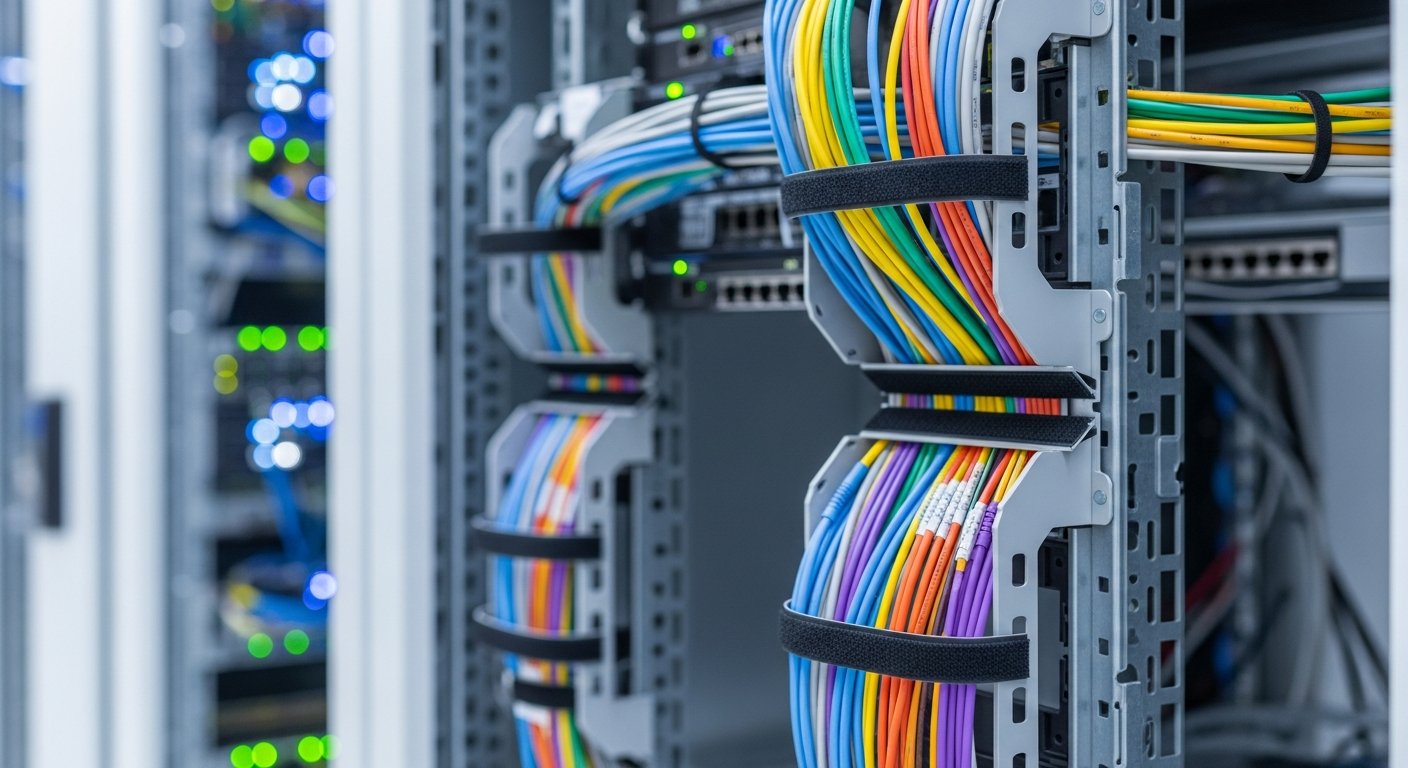
Два кабеля от сервера к двум разным коммутаторам
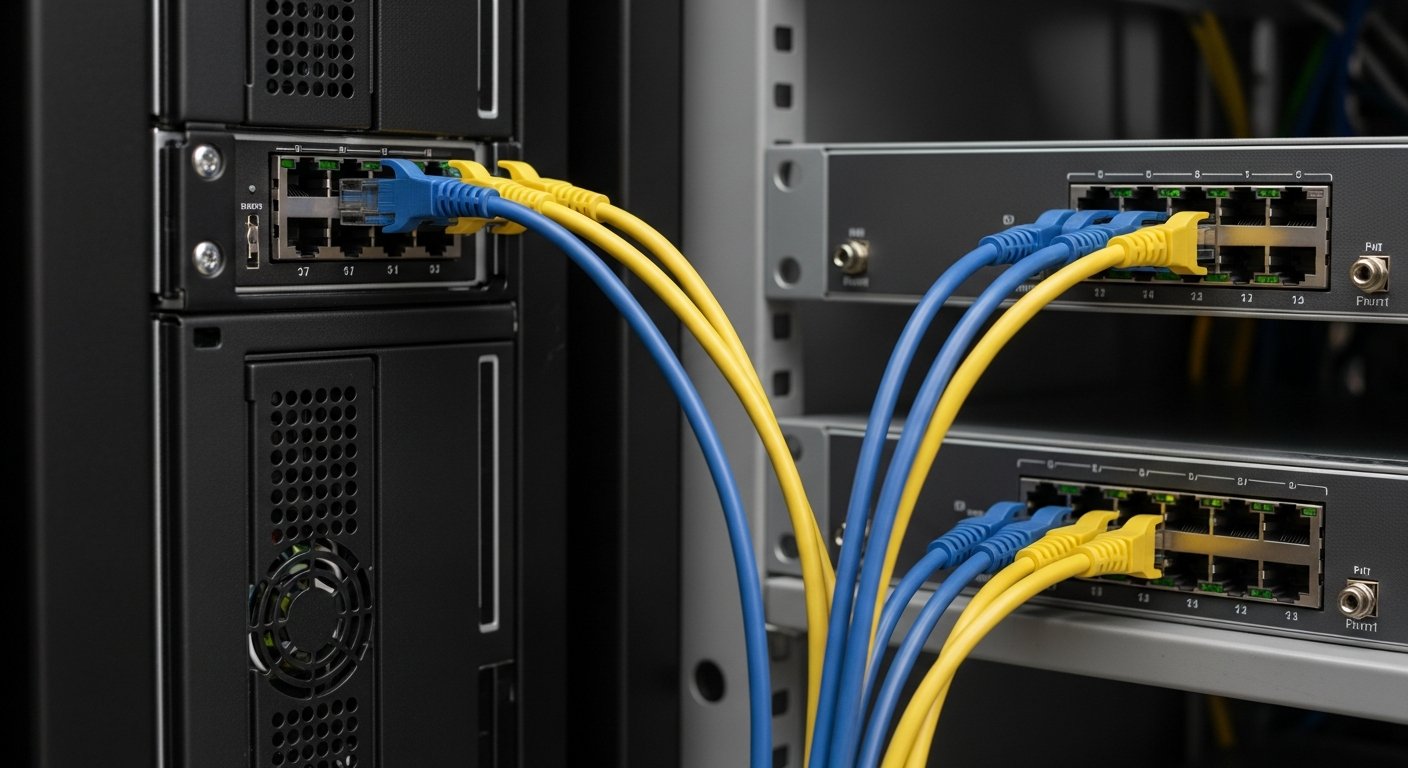
Базовый принцип: каждый сервер подключается двумя кабелями к двум разным коммутаторам. Если умер один коммутатор или порвался один кабель — связь сохраняется через второй путь. На стороне сервера используется bonding (Linux) или team (Windows) в режиме active-backup или 802.3ad. На стороне коммутаторов — MLAG, который видит оба порта как один логический.
Дублированные SFP/SFP+, оптика и медь
Трансиверы тоже отказывают, поэтому дублируются. Оптические SFP-модули, медные RJ45-патчи, DAC-кабели — все берется парами. Не имеет смысла дублировать линк, если оба SFP куплены из одной партии и могут отказать одновременно от заводского дефекта. Поэтому при ответственной инфраструктуре трансиверы берутся от разных партий или производителей.
Раздельные кабельные трассы и патч-панели
Очень частая ошибка — два резервных кабеля идут по одному кабельному лотку. Лоток упал, потолок протек, грызун перегрыз — оба линка умерли одновременно. Правильно: основной и резервный пути по разным кабельным трассам, через разные кросс-щиты, желательно по разным этажам или хотя бы по разным сторонам стойки. Подобрать сетевое оборудование с парой коммутаторов разной комплектации — отдельная задача, которую стоит решать одновременно с подбором кабельной системы.
Два независимых блока питания у каждого устройства
Серверы, коммутаторы, маршрутизаторы — все ставятся с двумя БП. Питание подается с двух разных PDU, которые в идеале запитаны от разных UPS и разных вводов. Если один ввод просел, второй БП устройства автоматически берет на себя нагрузку. На крупных объектах используют схему 2N — две полностью независимых ветки питания.
Резервирование на L2: LACP, MLAG и stack
На канальном уровне резервирование строится через агрегацию линков и кластеризацию коммутаторов. Разберем главные механизмы.
LACP (802.3ad): агрегация линков к одному коммутатору
LACP (Link Aggregation Control Protocol) по стандарту IEEE 802.3ad объединяет до 8 физических линков в одну логическую группу. Все линки идут на один коммутатор и работают параллельно, балансируя нагрузку по hash от MAC, IP или портов. Если один линк падает, остальные продолжают работать без потери сессий. Минус — все линки в одном коммутаторе, и если умирает он сам, LACP не спасает.
Stack: пара коммутаторов как единое управление
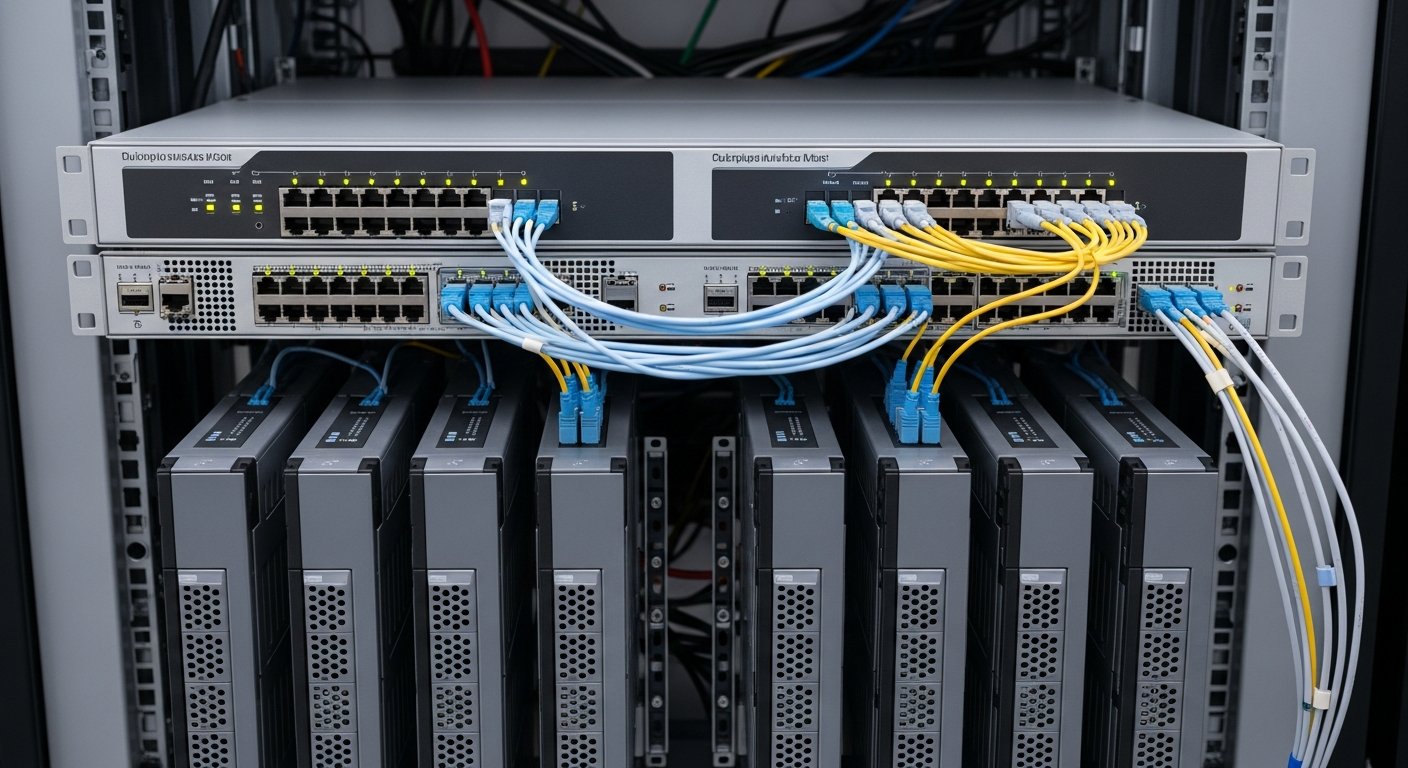
Stack — еще один способ объединить пару коммутаторов в одно логическое устройство. В отличие от MLAG, тут не только данные, но и плоскость управления одна: вы заходите по одному IP, настраиваете одну конфигурацию, видите все порты как у одной машины. Подходит для филиалов и небольших площадок, где администратор не хочет иметь два отдельных коммутатора.
STP/RSTP/MSTP: защита от петель и пересчет топологии
Когда в сети есть резервные пути, появляется риск петель — кадры начинают бесконечно кружить и кладут всю сеть за секунды. От этого защищает Spanning Tree Protocol. Классический STP (802.1D) считал топологию 30–50 секунд — это много. RSTP (802.1w) сократил время до 1–3 секунд, MSTP (802.1s) добавил поддержку разных деревьев для разных VLAN. На современной сети обязательны RSTP/MSTP плюс BPDU guard, root guard, loop guard на портах доступа.
Bonding на серверах: active-backup, 802.3ad, balance-tlb
На стороне сервера агрегация линков делается через Linux bonding или Windows NIC teaming. Режим active-backup — один линк активен, второй ждет, переключение за 100–500 мс. Режим 802.3ad — полноценный LACP с балансировкой и активным резервом. Balance-tlb — без поддержки на коммутаторе, балансировка по передаче только. Под продакшен обычно берется 802.3ad плюс MLAG на коммутаторах. Конкретные шаги конфигурации описывает настройка NIC Teaming и LACP на сервере.
Что такое MLAG и как он работает
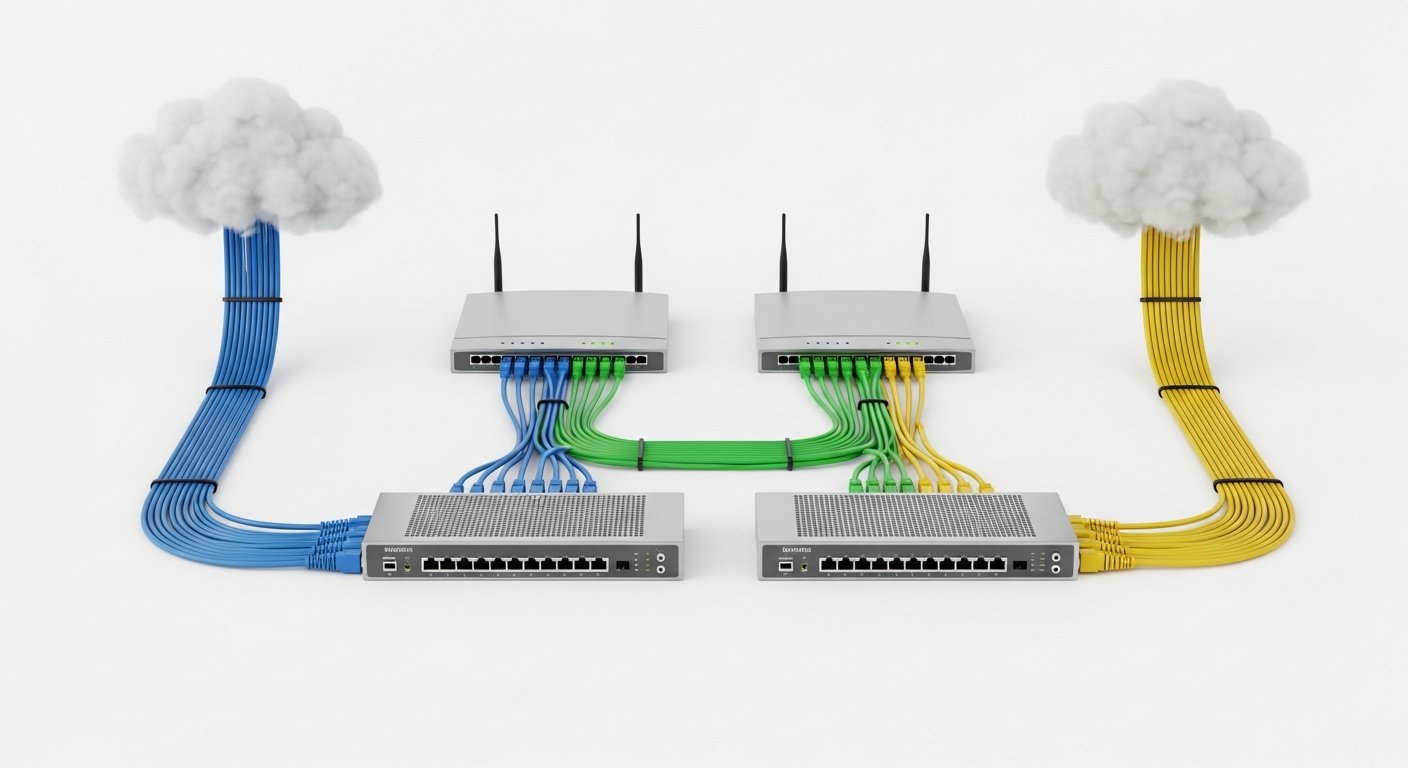
MLAG (Multi-chassis Link Aggregation) — агрегация портов сервера или коммутатора доступа к двум физическим коммутаторам, которые для LACP-партнера выглядят одним устройством. Так решается главная проблема LACP: линки больше не сходятся в один коммутатор, и его отказ не обрывает связь. Трафик переходит на второй коммутатор за доли секунды, и для большинства приложений это незаметно.
Коммутаторы MLAG-пары связаны peer-link, выделенным агрегированным каналом, по которому они синхронизируют MAC-таблицы и состояние портов. Через него же идет трафик, если у одного из коммутаторов отказал линк к серверу. Отдельно между коммутаторами держат keepalive-канал, обычно через сеть управления: по нему пара проверяет, жив ли сосед. Если peer-link разорвался, а keepalive отвечает, вторичный коммутатор гасит свои MLAG-порты, и пара не превращается в два независимых устройства с одинаковыми адресами, то есть не возникает split-brain.
Со стороны сервера настраивается обычный LACP-bond (802.3ad), и сервер не знает, что его линки приходят на разные коммутаторы. У вендоров технология называется по-разному: у Cisco это vPC, у Huawei M-LAG, у Arista, Eltex и QTECH MLAG. Логика везде одна, но MLAG-пару собирают из коммутаторов одного производителя и одной линейки.
Чем MLAG отличается от стека и обычного LACP, удобно видеть в одной таблице.
| Параметр | MLAG | Stack | LACP |
|---|---|---|---|
| Число коммутаторов | 2 | Несколько, предел зависит от вендора и модели | 1 |
| Плоскость управления | Раздельная | Общая | Не применяется |
| Обновление без простоя | Да, поочередно | Обычно нет, стек перезагружают целиком | Не применяется |
| Защита от отказа коммутатора | Да | Да | Нет |
Резервирование на L3: VRRP, HSRP, BGP
На сетевом уровне резервируются шлюзы по умолчанию, маршрутизаторы и внешние подключения.
VRRP/HSRP: виртуальный шлюз для пользователей
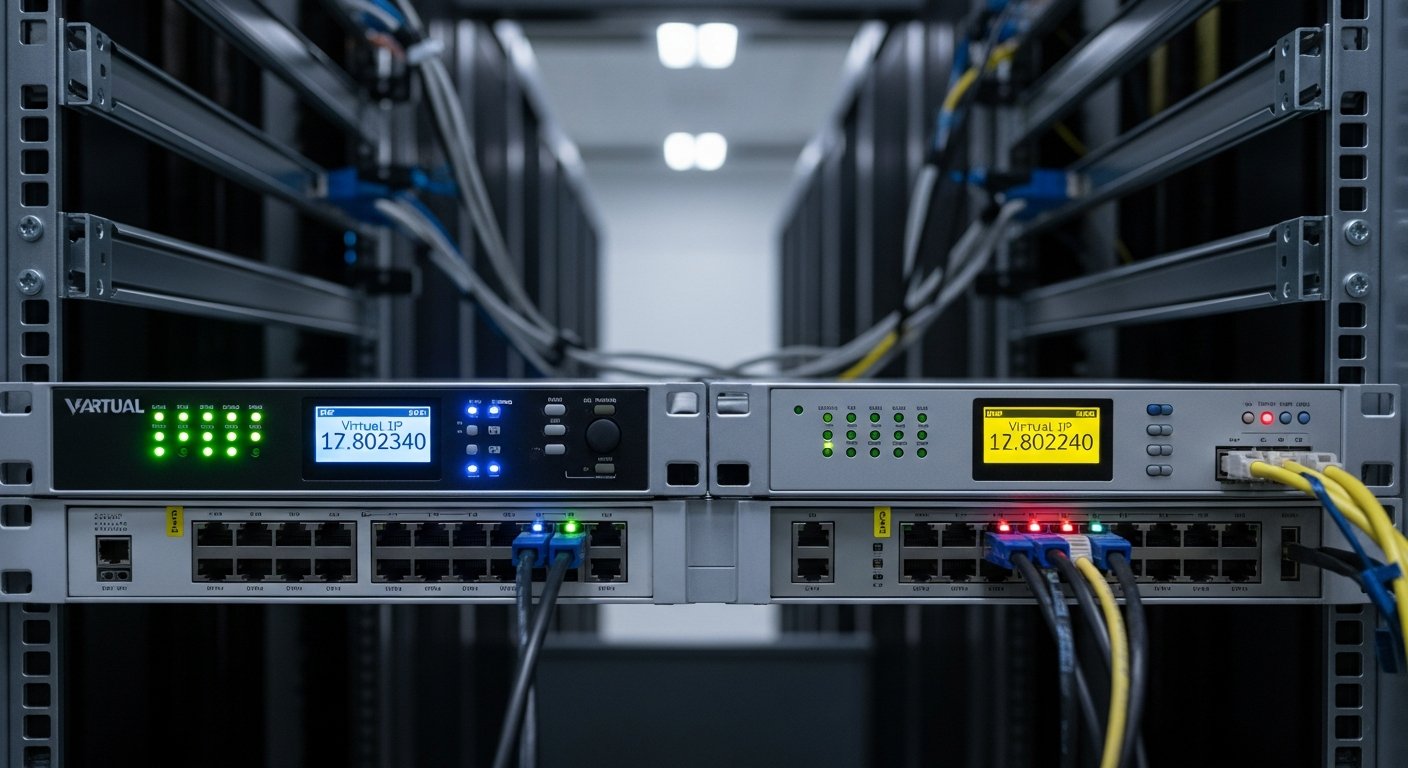
Пользователи и серверы знают только один шлюз по умолчанию. За ним стоит пара маршрутизаторов с протоколом VRRP (RFC 5798) или HSRP (проприетарный протокол американских вендоров). Они договариваются, кто из них активный, и держат виртуальный IP. При отказе активного резервный забирает виртуальный IP за 1–3 секунды при стандартных таймерах. С millisecond-таймерами время сокращается до 100 мс. GLBP добавляет балансировку нагрузки между маршрутизаторами.
Динамическая маршрутизация OSPF и ECMP
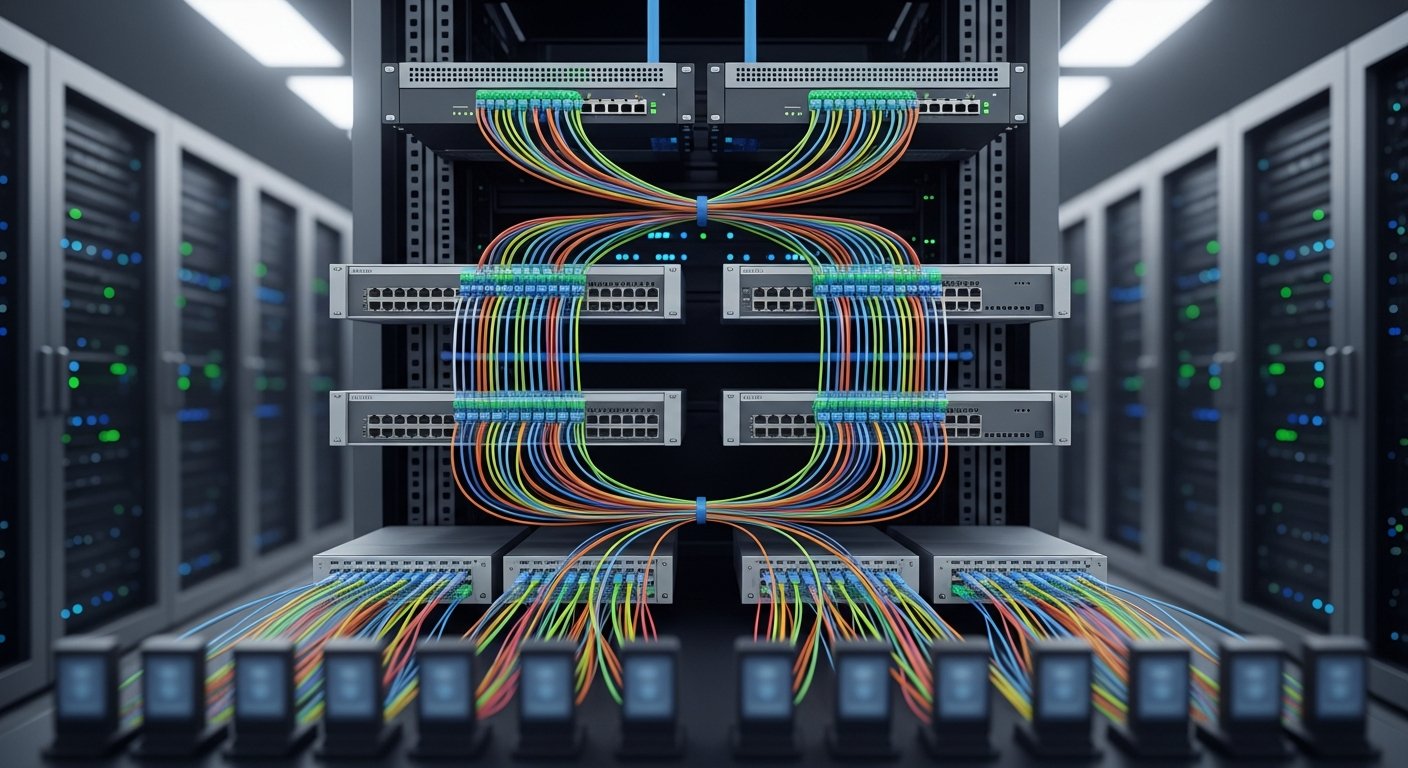
Внутри сети для построения отказоустойчивых маршрутов используется OSPF — Open Shortest Path First. Он автоматически пересчитывает кратчайшие пути при изменении топологии. ECMP (Equal-Cost Multi-Path) позволяет балансировать трафик по нескольким путям одинаковой стоимости — это работает и как резервирование, и как увеличение полосы. BFD ускоряет обнаружение отказов до 50–150 мс.
BGP с двумя провайдерами: автономная система клиента
Самый солидный сценарий резервирования внешнего подключения — собственная автономная система (AS) клиента с BGP-маршрутизацией к двум провайдерам. Клиент анонсирует свой IP-блок в обе AS, при отказе одного провайдера трафик автоматически идет через второго. Время переключения BGP с дефолтными таймерами — 30–180 секунд, с BFD сокращается до 1–3 секунд.
Failover без потери сессий: stateful firewall в HA
Если в сети стоит firewall с инспекцией трафика, простое переключение IP не спасает: сессии TCP теряются, пользователи получают разрыв. Решение — два firewall в HA-режиме (active-passive или active-active) с синхронизацией таблицы сессий. Российские UserGate, Континент, Идеко поддерживают такой режим со временем переключения 5–30 секунд. Сам механизм обнаружения отказа и передачи роли раскрывает разбор «как работает failover-кластер».
Архитектуры для разных размеров инфраструктуры
Под разные масштабы инфраструктуры подходят разные схемы. Разберем четыре типовых.
SMB: 2 коммутатора + bonding на серверах
Для малого офиса достаточно пары коммутаторов с MLAG и серверов с bonding в режиме 802.3ad. Если есть один-два маршрутизатора с VRRP — закрыт и L3-уровень. Бюджет минимальный, эксплуатация простая, отказоустойчивость на достаточном уровне.
Средний бизнес: core-distribution-access с MLAG
Для среднего бизнеса с парой стоек строится трехуровневая архитектура: пара core-коммутаторов 10/25 Gb, distribution-уровень с MLAG, access-коммутаторы в каждой стойке. Серверы подключаются двумя линками к двум access-коммутаторам. Под такие архитектуры разумно сразу планировать серверы с двойными сетевыми картами 10/25 Gb и SFP-парами разных партий.
Дата-центр: spine-leaf фабрика с EVPN-VXLAN
В крупном ЦОД с десятками стоек применяется фабрика spine-leaf. Spine-коммутаторы (2–8 шт) подключены ко всем leaf-коммутаторам (по числу стоек) через 100/400 Gb линки. Маршрутизация — BGP-EVPN, инкапсуляция — VXLAN. Любой leaf видит любой leaf через 2 хопа, отказоустойчивость обеспечивается ECMP между spine. Масштабируется горизонтально без перепроектирования.
Геораспределение: два ЦОД и DCI-линки
Между двумя ЦОД прокладывается DCI-канал — пара темной оптики или MPLS-каналов через разных провайдеров. Логически это L2 или L3 stretch через EVPN-VXLAN или MPLS-VPLS. При отказе одного ЦОД сервисы перевозятся на второй, для пользователей это прозрачно благодаря anycast-IP или DNS-балансировке.
Резервирование внешнего канала и провайдеров
Внутренняя сеть отказоустойчива, а внешний канал один — типовая ошибка. Разберем, как ее избежать.
Два провайдера с разными вводами
Два кабеля от разных провайдеров должны заходить в здание разными путями — через разные колодцы и разные вводы, желательно с разных сторон здания. Иначе экскаватор у соседнего дома порвет оба кабеля одновременно. Перед сдачей объекта полезно сделать аудит безопасности с проверкой реальных кабельных трасс — на бумаге часто все красиво, а в реальности два кабеля идут в одном лотке.
BGP-маршрутизация и SLA провайдеров
Если у компании серьезный трафик, имеет смысл получить собственную автономную систему и PI-блок IP. С AS-номером можно подключаться по BGP к нескольким провайдерам, и при отказе одного трафик автоматически идет через другого. В SLA провайдера обращайте внимание не только на гарантированную доступность (обычно 99.9%), но и на компенсацию при простоях, время реакции на инциденты и параметры RTO/RPO — за какое время канал должен восстановиться и какие потери данных допустимы при аварии.
Резервный LTE/5G канал для критичных сервисов
Для критичных сервисов помимо двух проводных провайдеров часто ставят резервный LTE или 5G модем. Это страховка на случай отказа сразу двух кабельных провайдеров — например, при крупной аварии в районе. Пропускная способность ниже, но базовая работа критичных сервисов (мониторинг, удаленный доступ, ключевые транзакции) поддерживается.
Что выбирать из российских вендоров
После 2022 года парк сетевого оборудования в РФ массово мигрирует на отечественных производителей. Разберем основных.
Eltex, QTECH, Bulat: коммутаторы L2/L3 с MLAG и стэками
Eltex (серии MES, ESR) — один из крупнейших российских производителей коммутаторов и маршрутизаторов. MES5500-32 — топовая модель агрегации с 32 портами 100G, поддерживает MLAG, RSTP, MSTP, CLI в индустриальном стиле. QTECH (QSW-серии) — конкурент с акцентом на BGP-EVPN и VXLAN. Bulat (BS-серии) и Аквариус активно развивают свои линейки коммутаторов под госзаказ. Под полноценный план миграции хорошо подходит импортозамещение серверов и сетевого оборудования вместе. Возможности линейки MES и варианты применения подробнее разбирает обзор коммутаторов Eltex с поддержкой MLAG.
UserGate, Континент, Идеко: межсетевые экраны в HA
В сегменте NGFW и UTM лидеры — UserGate, Континент (Код Безопасности) и Идеко. Все три поддерживают HA-режим active-passive с синхронизацией сессий. UserGate работает на собственной ОС, Континент имеет сертификацию ФСБ по классу КС3, Идеко делает упор на удобство управления. Под значимые объекты КИИ обычно ставится Континент.
Открытые решения: pfSense/OPNsense с CARP
Для не критичных задач есть открытые решения — pfSense и OPNsense с протоколом CARP (Common Address Redundancy Protocol). CARP — это open-source аналог VRRP/HSRP, дает виртуальный IP, который мигрирует между парой firewall за секунды. Подходит для малого бизнеса с ограниченным бюджетом, но без сертификации регулятора.
Эксплуатация и проверки
Развернуть отказоустойчивую сеть — половина работы. Дальше начинается каждодневная эксплуатация.
Регулярный тест переключения: отключить один аплинк
Раз в квартал в окно обслуживания проводится drill-тест: физически отключается один аплинк, один коммутатор, один блок питания. Цель — проверить, что резерв действительно работает и MLAG/VRRP/BGP отрабатывают штатно. Без таких тестов «резерв» превращается в декоративный — он есть, но в момент реального инцидента не срабатывает.
Мониторинг каналов и сессий BGP/OSPF
Все каналы, BGP-сессии, OSPF-соседства, статус MLAG-пар — на мониторинге в Zabbix или PRTG. Алерты на разрывы, флаппинг, изменение количества активных линков. Без мониторинга админ узнает об отказе резервного канала только тогда, когда умрет основной — и резерва уже не будет.
Конфигурации в Git и регламент изменений
Конфигурации всех коммутаторов и маршрутизаторов хранятся в Git с историей изменений. Любая правка проходит через ревью, тестируется на стенде, накатывается через Ansible или вендорские инструменты. Без этого один неудачный change на core-коммутаторе может положить всю сеть.
Типовые ошибки
Опыт показывает, какие промахи делают команды при первой настройке резервирования.
«Резерв» сводится к одному коммутатору в стойке
Самая частая ошибка — поставить «резервный» коммутатор в ту же стойку рядом с основным, на тот же PDU, в тот же лоток. При локальной аварии (пожар, потоп, отказ стойки) оба коммутатора умирают одновременно. Правильно: резервные устройства разносить минимум по разным стойкам, а в идеале — по разным помещениям с разными вводами питания.
STP/RSTP не настроен, петля кладет все за секунды
Вторая частая ошибка — забыть включить RSTP/MSTP и BPDU guard. Любой пользователь, который случайно воткнул два конца патч-корда в один свитч под столом, создает петлю. За пару секунд весь L2-сегмент уходит в шторм и сеть умирает. RSTP с правильными настройками гарантирует, что петля будет автоматически заблокирована.
Два аплинка идут по одному кабельному лотку
Третья типовая ошибка — два резервных кабеля от двух разных коммутаторов прокладываются вплотную друг к другу через один лоток. Лоток упал, потолок протек, мыши прогрызли — обе линии умерли одновременно. Резервные пути должны идти физически разными маршрутами через разные кросс-щиты.
Хотите построить отказоустойчивую сеть для офиса, ЦОД или геораспределенной инфраструктуры? Наши инженеры спроектируют дублированные коммутаторы, MLAG, BGP-маршрутизацию с двумя провайдерами и подберут российское оборудование. Закажите аудит ИТ-инфраструктуры — на выходе будет готовая схема, спецификация и регламент тестирования.
Сравнительная таблица: типы резервирования
| Уровень | Технология | Время переключения | Сценарий |
|---|---|---|---|
| L1 | Bonding active-backup | 100–500 мс | Сервер к двум коммутаторам |
| L2 | LACP (802.3ad) | <100 мс | Агрегация к одному коммутатору |
| L2 | MLAG / vPC | 50–200 мс | Агрегация к двум коммутаторам |
| L2 | Stack | 1–5 секунд | Пара коммутаторов как одно устройство |
| L2 | RSTP (802.1w) | 1–3 секунды | Защита от петель |
| L3 | VRRP / HSRP | 1–3 секунды | Виртуальный шлюз |
| L3 | OSPF + ECMP | 1–10 секунд | Внутренняя маршрутизация |
| L3 | BGP с двумя провайдерами | 30–180 секунд | Внешний канал |
| L3 | BGP + BFD | 1–3 секунды | Внешний канал с быстрой детекцией |
Часто задаваемые вопросы (FAQ)
Что такое MLAG и зачем он нужен?
MLAG (Multi-chassis Link Aggregation) — технология, при которой пара физических коммутаторов работает как одно логическое устройство, а сервер подключается к ней обычным LACP. При отказе одного коммутатора трафик за доли секунды уходит через второй.
Чем VRRP отличается от HSRP?
VRRP — открытый стандарт (RFC 5798), работает на коммутаторах и маршрутизаторах любых вендоров. HSRP — проприетарный протокол американских вендоров. Функционально оба делают одно: дают виртуальный IP, который мигрирует между парой устройств. Российские коммутаторы Eltex, QTECH поддерживают только VRRP, поэтому в современной импортозамещенной инфраструктуре HSRP практически не встречается.
Сколько коммутаторов минимум для отказоустойчивой сети?
Минимум два на каждом уровне. Пара access-коммутаторов в стойке, пара distribution-коммутаторов на этаж, пара core-коммутаторов в ядре. Один коммутатор — это всегда единая точка отказа, какую бы дорогую модель вы ни взяли. Конфигурации с одним устройством применяются только в dev-стендах и некритичных сегментах.
Можно ли подключиться к одному коммутатору двумя кабелями для резерва?
Это резерв только от обрыва кабеля, но не от отказа коммутатора. Если умирает сам коммутатор — оба кабеля бесполезны. Правильное резервирование — два кабеля к двум разным коммутаторам в режиме MLAG или bonding active-backup.
Зачем второй провайдер интернета бизнесу?
Без второго провайдера бизнес зависит от одного канала: авария у провайдера — простой всего бизнеса. Для интернет-магазина это означает потерю заказов, для банка — проблемы с эквайрингом, для офиса — невозможность работать. Стоимость второго провайдера обычно окупается за 1–2 крупных инцидента в год.
Что выбрать: stack или MLAG?
Stack удобнее в эксплуатации (одна точка управления, одна конфигурация), но менее устойчив к ошибкам — баг в прошивке роняет оба коммутатора одновременно. MLAG сложнее в настройке (две отдельные конфигурации), зато надежнее: каждый коммутатор живет своей жизнью, отказ одного никак не влияет на второй. Для критичных продакшен-задач выбирают MLAG.
Какие российские коммутаторы поддерживают MLAG?
Eltex MES5500/MES7000, QTECH QSW-6800/7000-серии, Bulat BS-series. Все они поддерживают MLAG со временем переключения 50–200 мс, RSTP/MSTP, VRRP, BGP-EVPN. Под госзаказ и значимые объекты КИИ берется конкретная сертифицированная модель из реестра Минпромторга.
Как протестировать отказоустойчивость без останова работы?
В окно обслуживания (обычно ночное) последовательно физически отключаются: один аплинк, один блок питания, один коммутатор, одна BGP-сессия. После каждого отключения проверяется работа сервисов, фиксируется время переключения, анализируются журналы. Если все работает штатно — резерв реально отказоустойчив. Полный drill-тест проводится раз в квартал.