


Failover (фейловер) — автоматическое переключение сервиса на резервный сервер или узел кластера при отказе основного. Работает он как запасной пилот в кабине самолета: пока все штатно, наблюдает, при падении командира берет штурвал за секунды, а пассажиры даже не замечают. Цель одна — отказоустойчивость на уровне сервиса, без участия администратора.
Зачем это нужно, объясняет цена простоя: без авторезерва остановка 1С стопорит продажи и работу сотрудников, банковский шлюз с downtime в 5 минут попадает в новости, а видеоархив с разрывом записи теряет инцидент. Как перевести простой своей системы в рубли, показывает формула стоимости часа простоя в блоке о метриках. В статье разберем по порядку: чем failover отличается от простого бэкап-сервера, как технически реализовано автоматическое восстановление, какие архитектуры бывают (active passive, active active, N+1) и кому это действительно нужно. Все — с реальными временами переключения, инструментами (Pacemaker, Keepalived, Patroni, WSFC) и сценариями на 1С, ERP, веб-фронт и видеонаблюдение.
Что такое failover-сервер простым языком
Если кратко — это бэкап-нода, которая автоматически принимает на себя нагрузку основного при его отказе. Без администратора, без ручной смены IP, без рестарта приложения с нуля. А теперь подробнее по терминам.
Failover vs failback vs switchover
Эти три понятия путают чаще всего. Failover — автоматическое переключение с основной машины на резервную при отказе. Failback — обратное переключение, когда основная нода вернулась в строй (часто делается вручную в окно обслуживания). Switchover — плановый переезд по решению администратора (например, на обновлениях или тестах). Все три используют один и тот же механизм срабатывания, разница только в инициаторе и направлении.
Чем failover отличается от резервного бэкап-сервера
Сравним по шагам. Резервный бэкап-сервер хранит копию данных на случай восстановления. Чтобы запустить с него работу, нужно восстановить базу, поднять приложение, переключить DNS, проверить — это часы или сутки в зависимости от объема данных. Failover-сервер устроен иначе: он уже подготовлен к работе и держит копию через репликацию (синхронную или с минимальной задержкой) — это и есть базовая отказоустойчивость на уровне данных. При падении основного переключение занимает 5–60 секунд и проходит без ручных операций.
Авторезерв на уровне приложения, СУБД, сети, гипервизора
Стоит уточнить: failover не один — он бывает разной глубины. Сетевой (VRRP, VIP, балансировщик) переключает трафик между двумя серверами с одинаковыми ролями. Приложений (Pacemaker resources, Keepalived check) мониторит сервис и поднимает его на резервном узле. СУБД (MS SQL AlwaysOn AG, PostgreSQL Patroni, Galera Cluster) реплицирует данные и переключает primary при отказе. Гипервизора (VMware HA, Hyper-V Failover Cluster, oVirt HA) перезапускает упавшие виртуальные машины на другом хосте кластера. И на большом проекте обычно работает несколько уровней одновременно.
Кластер и балансировка нагрузки: в чём разница
Эту схему регулярно смешивают с балансировкой нагрузки, хотя решают они разное. Балансировщик раскидывает запросы между серверами ради скорости и имеет дело с сервисами без состояния. Отказоустойчивая связка, наоборот, страхует сервисы с состоянием — базы данных, бизнес-приложения — и переносит их целиком при сбое. Балансировка отвечает за «быстрее силами многих», а резервирование — за «не упасть, когда один узел отвалится».
Как технически работает автоматическое переключение
За кулисами HA-кластера крутятся несколько механизмов, и каждый отвечает за свою часть. Разберем их по очереди.
Heartbeat — узлы постоянно сверяют статус друг друга
Начинается все с heartbeat. Ноды кластера обмениваются служебными пакетами каждую секунду или чаще. Если три-десять пакетов подряд не приходят — бэкап делает вывод, что основной мертв, и инициирует переезд. Цифры выглядят так: типовое время реакции в Pacemaker — heartbeat 1 секунда, token timeout 1000–3000 мс, итоговое автоматическое восстановление за 3–10 секунд. Чтобы все это работало надежно, heartbeat-канал обычно идет через выделенный сетевой интерфейс или VLAN — это снижает риск ложных срабатываний из-за загруженной основной сети.
VIP (Virtual IP) и переключение трафика
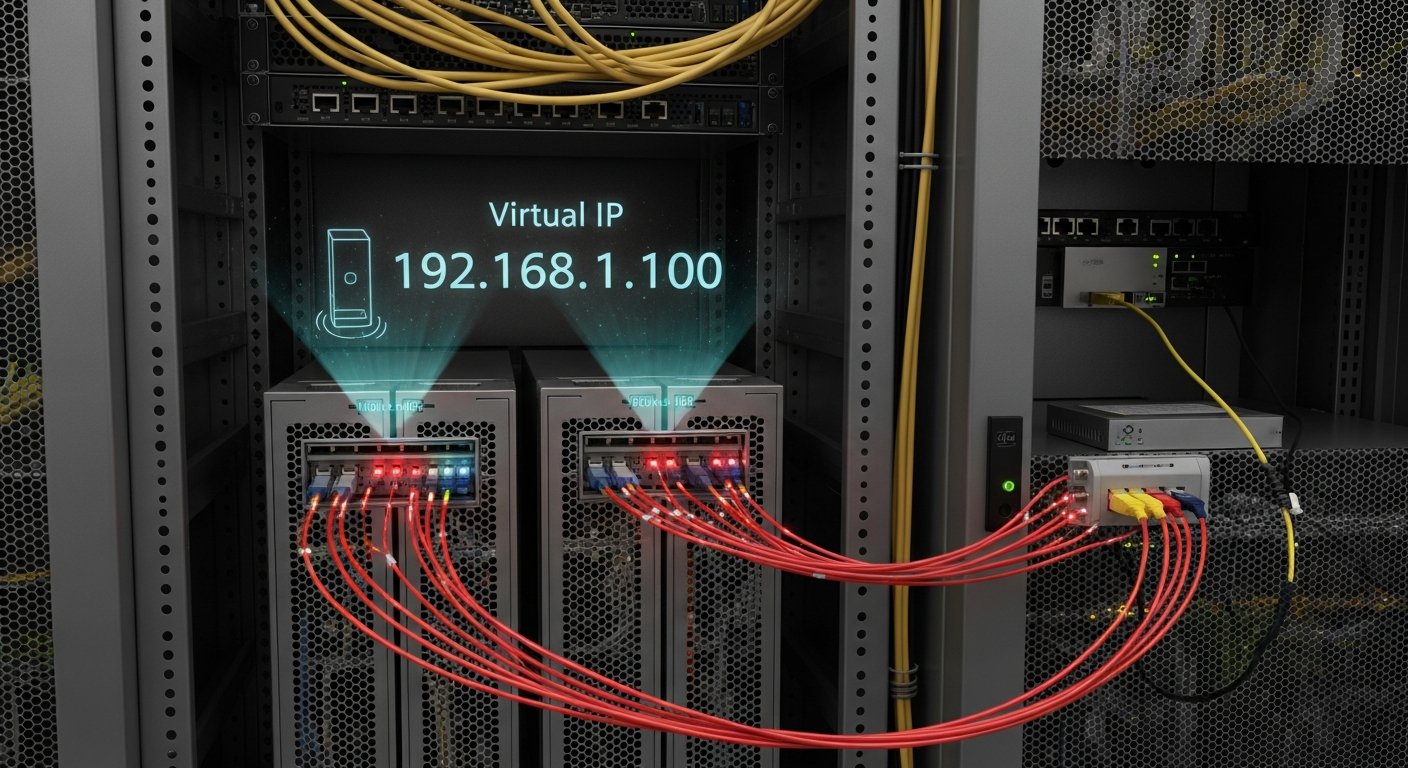
Дальше — куда направить клиентов после переезда. Чтобы они не замечали смены сервера, кластер использует виртуальный IP (VIP). Адрес «плавает» между узлами: пока работает основной — VIP на нем, а когда тот падает, адрес автоматически поднимается на резервной ноде через gratuitous ARP (сообщение в локальную сеть «теперь этот IP мой»). Клиенты при этом продолжают ходить по тому же адресу. Стандартизированный протокол для этого — VRRP (Virtual Router Redundancy Protocol), реализованный в Keepalived. Часто перед VIP ставят load balancer, который распределяет трафик и проверяет здоровье узлов независимо.
Witness / quorum — защита от split-brain
С трафиком разобрались, но возникает следующая проблема. Главная опасность двухузлового кластера — split-brain: оба узла одновременно считают себя живыми (например, когда heartbeat-канал между ними рвется) и начинают обслуживать клиентов параллельно. А это приводит к расхождению, которое потом не свести. Защита — кворум через witness: третий узел или диск-witness в общем хранилище. Решение принимается большинством: если у ноды нет связи с большинством, она добровольно уходит в standby и не принимает запись. Минимальная конфигурация — 2 рабочих узла + 1 witness.
STONITH — «выстрел в голову» зависшему узлу
Иногда узел не отвечает на heartbeat, но при этом физически живет и держит блокировки на хранилище. Чтобы исключить такой сценарий, кластер использует STONITH (Shoot The Other Node In The Head): принудительное отключение зависшей машины через IPMI, выключение порта на коммутаторе или команду гипервизору. Только после этого бэкап берет на себя ресурсы. STONITH — обязательный компонент enterprise-failover, иначе риск порчи данных слишком высок.
Архитектуры HA-кластеров
С механикой переключения разобрались — переходим к схемам. Конфигураций несколько, и выбор зависит от профиля нагрузки и бюджета.
| Архитектура | Утилизация | Сценарий | Сложность |
|---|---|---|---|
| Active/Passive (2 узла) | 50% | СУБД, файловые серверы, AD-роли | Низкая |
| Active/Active (2 узла) | до 50% на узел в штатном режиме, до 100% на оставшемся узле после отказа | Веб-фронт, stateless API, кэши | Средняя |
| N+1 (3–5 узлов + 1 резерв) | 80%+ | ВМ-кластер VMware HA, виртуализация | Средняя |
| N+M (несколько резервов) | 80%+ | Крупные распределенные системы | Высокая |
| Geo-failover (между ЦОД) | 50%/50% | Банки, e-commerce, ERP в HA | Очень высокая |
Active/Passive — один работает, второй ждет
Основная нода обслуживает клиентов, а резервная держит синхронную реплику данных и при отказе принимает нагрузку за секунды, но половина железа при этом простаивает. Схема подходит сервисам с состоянием, которые не масштабируются горизонтально: СУБД (PostgreSQL с Patroni, MS SQL Server Always On Availability Groups), файловым серверам, контроллерам домена с FSMO-ролями.
Active/Active — оба работают и страхуют друг друга
Оба узла одновременно обслуживают трафик через балансировщик, и каждый должен в одиночку тянуть 100% нагрузки, поэтому в штатном режиме он загружен не выше 50%. Схема подходит для веб-фронта, stateless API и кэшей (Redis Cluster, Memcached). Как выбрать между двумя схемами по утилизации, RTO и сложности эксплуатации, показывает подробное сравнение active/passive и active/active.
N+1 и N+M — один или несколько горячих резервов
Шаг дальше — больше узлов.
Связка из нескольких рабочих нод и одного-двух резервных. Если падает любая рабочая машина, бэкап-сервер берет ее нагрузку. Утилизация заметно выше, чем у active/passive: например, при N+1 на 5 узлах простаивает только 20% мощности. Применяется для виртуализации (VMware HA с несколькими хостами и одним резервом), Kubernetes (поды переезжают на свободный узел), распределенных приложений. У серьезных проектов разумно сразу планировать кластер из 3 нод и больше — это базовое требование для нормального quorum.
Geo-failover — между двумя ЦОД
Высшая ступень — географическое разнесение. Резервная связка живет в географически удаленном дата-центре (50+ км) и защищает от полной аварии основного ЦОД: пожара, потопа, аварии электропитания. RTO составляет 30–120 секунд при стабильном канале, а RPO зависит от типа репликации (синхронная — 0, асинхронная — до 15 минут). Главная сложность тут — стоимость канала между ЦОД и латентность, которая ограничивает синхронную репликацию. Одного географического резервирования недостаточно для согласованного восстановления сервисов: нужен план Disaster Recovery при потере площадки.
Когда HA критически нужен бизнесу
Не каждой системе нужен HA. Но есть сценарии, где обойтись без него просто нельзя. Разберем основные.
Интернет-магазин — каждая минута простоя теряет заказы
У интернет-магазина простой в пиковый день бьет сразу по выручке: заказы уходят к конкурентам, а часть покупателей не возвращается. Стоимость часа простоя считают по формуле из блока о метриках отдельно для пиковых дней, и если она превышает стоимость двухузловой связки веб-фронта и БД, кластер окупается за один предотвращенный инцидент.
Банковский фронт и платежные шлюзы
В этом сегменте вопрос даже не в деньгах, а в лицензии. Банк России предъявляет к кредитным организациям обязательные требования к операционной надежности: целевые показатели, включая допустимое время простоя критичных процессов, банк устанавливает сам и обязан их выдерживать. Без кластерной защиты на каждом критичном слое жесткие показатели недостижимы, поэтому платежные шлюзы обычно строят по схеме active/active с переключением за секунды.
ERP и 1С в продакшене с круглосуточной работой
Производственное предприятие с тремя сменами, склад с 24/7 отгрузкой, логистическая компания — все они теряют процесс при простое 1С в час. Стандарт для таких задач — active/passive под PostgreSQL/MS SQL и кластерная виртуализация под сервер 1С приложений. Подобрать сетевое оборудование с поддержкой LACP и дублированием каналов — отдельная задача того же уровня важности.
Системы видеонаблюдения и видеоархив
Разрыв записи в момент инцидента — главный ночной кошмар безопасника. Поэтому резервирование серверов видеонаблюдения строится по схеме N+1: несколько активных узлов записывают потоки, а если падает один, его камеры мгновенно переключаются на резервный. На критичных объектах (банки, режимные предприятия, госучреждения) это обязательная конфигурация.
Когда HA избыточен
С другой стороны, не любая система требует автоматического переключения. Иногда дешевле и проще обойтись без него.
Внутренние сервисы с допуском к простою в часы
Корпоративный портал, внутренняя wiki, dev/test-окружения — если простой 2–4 часа не убивает дело, проще иметь обычный бэкап и регламент восстановления, чем поддерживать HA-кластер. Экономия на железе и обслуживании при этом кратная.
Бэк-офис, который работает с 9 до 18
Если сотрудники сидят в системе только в рабочее время с 9 до 18, ночной отказ не критичен. Сервер можно поднять утром из ночного бэкапа, потеряв максимум 30 минут. У таких задач HA — это перерасход бюджета без бизнес-эффекта.
Тестовые и dev-среды
Здесь авторезерв откровенно избыточен. Если упало — разработчики поднимут заново, потерянное время — это часы, а не критичные минуты. Резервирование dev-серверов экономически не оправдано.
Метрики — RPO, RTO и реальная стоимость простоя
Прежде чем строить HA-кластер, нужно зафиксировать целевые метрики и реальную стоимость простоя. Без этих цифр невозможно обосновать бюджет: дорогостоящий active/active может быть избыточен там, где хватит active/passive.
RTO (recovery time objective) — как быстро поднимется сервис
RTO — максимальное допустимое время от момента отказа до возобновления работы. На разных инструментах оно разное: HA-кластер на Pacemaker дает RTO 5–30 секунд, VMware HA с перезапуском ВМ — 1–5 минут, восстановление из бэкапа без HA — часы. А вот SLA 99.99% (52 минуты простоя в год) физически требует RTO в десятки секунд, а не минут.
RPO (recovery point objective) — сколько данных можно потерять
RPO — допустимая потеря данных в случае отказа. У синхронной репликации RPO = 0 (ничего не теряется), у асинхронной — равно лагу репликации (секунды или минуты). У финансовых систем критичен RPO = 0, а для отчетных систем достаточно RPO 5–15 минут. Выбор архитектуры HA напрямую зависит от целевого RPO.
Расчет стоимости минуты простоя для бизнеса
Стоимость часа простоя считают по формуле: выручка за рабочий час × доля выручки, зависящей от системы + ФОТ простаивающих сотрудников за час + штрафы по SLA. Пример: компания с выручкой 600 млн ₽ в год и 2 000 рабочих часов зарабатывает 300 тыс. ₽ в час. Если отказ системы останавливает 50% отгрузок, прямые потери составят 150 тыс. ₽ в час, а вместе с 40 простаивающими сотрудниками по 1 000 ₽ в час получится 190 тыс. ₽ за час простоя. Для пиковых периодов расчет повторяют с выручкой пикового часа, а репутационный ущерб учитывают отдельно. Полученную сумму сравнивают со стоимостью кластера: если несколько часов простоя в год обходятся дороже, авторезерв окупается.
Инструменты для построения HA
Готовых open-source и коммерческих решений — десятки, и выбор зависит от стека и операционной системы. Разберем самые ходовые.
Pacemaker + Corosync на Linux-сервисах
Стандарт de-facto для Linux HA-кластеров. Pacemaker управляет ресурсами (виртуальные IP/сервисы/файловые системы), а Corosync обеспечивает heartbeat и кворум. Поддерживает active/passive, active/active, N+M-конфигурации. Из плюсов — богатая система constraints (правила размещения ресурсов) и STONITH-агенты под большинство серверного железа и гипервизоров.
Keepalived и VRRP
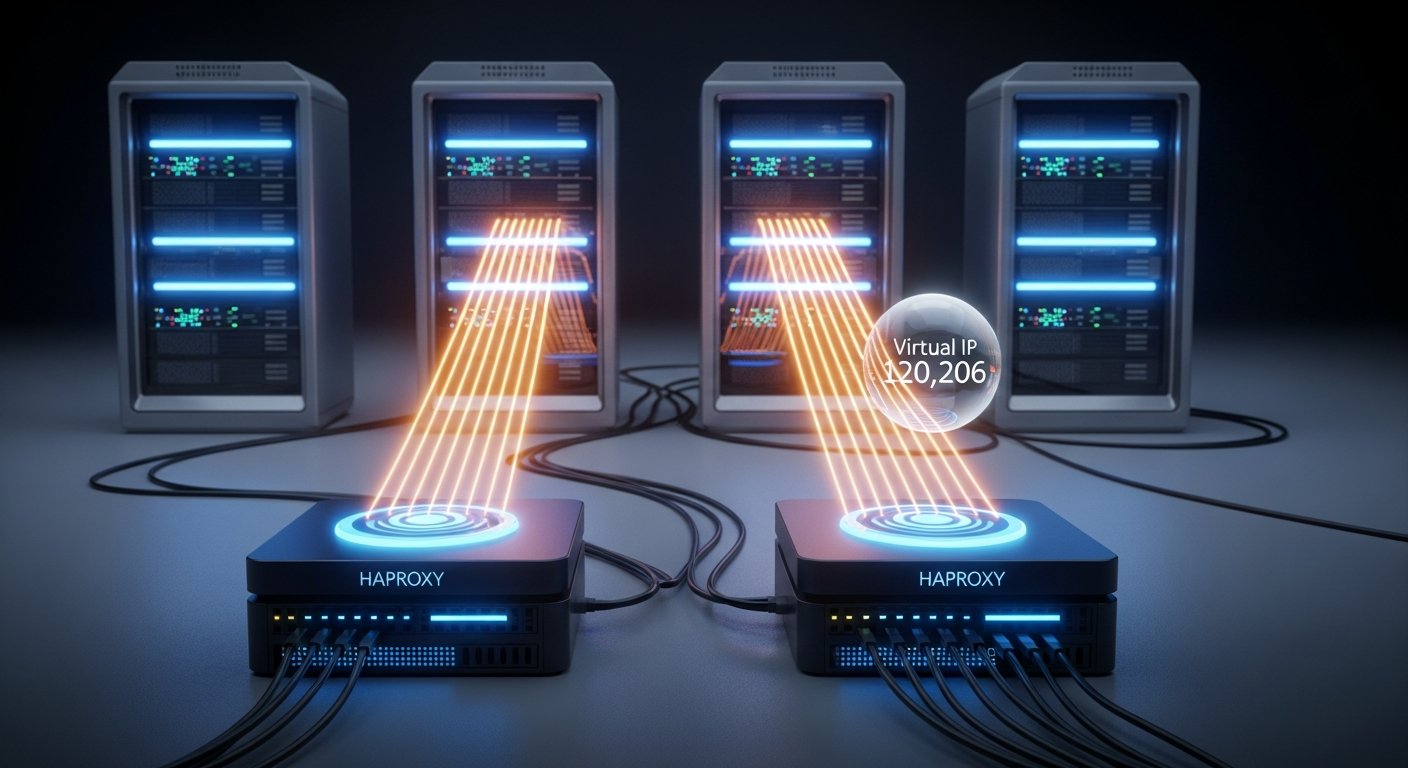
Простой инструмент под виртуальный IP с VRRP. Идеален для веб-серверов, балансировщиков и NAT-шлюзов. Время срабатывания VIP — 1–3 секунды. Обычно работает в паре с HAProxy: Keepalived держит VIP на активном HAProxy, а при его отказе VIP уходит на резервный. Минимальная конфигурация в проде — 2 узла с Keepalived + HAProxy.
Windows Server Failover Cluster (WSFC) в MS SQL и Exchange
Стандарт для Windows-стека. WSFC — основа у MS SQL AlwaysOn (как FCI, так и AG), Exchange DAG, Hyper-V Failover Clustering, файловых HA-кластеров. Использует Cluster Shared Volumes (CSV) для общего доступа к данным. Требует Windows Server Datacenter или Standard плюс соответствующие лицензии приложений. Подобрать готовый сервер баз данных с поддержкой WSFC проще на этапе проектирования, чем доукомплектовывать потом. Границы применения технологии раскрывает материал «Windows Server Failover Cluster: когда кластеризация оправдана».
Patroni + etcd в PostgreSQL
Современный стандарт автоматического failover для PostgreSQL. Patroni крутится на каждой ноде, а etcd (или Consul) хранит состояние кластера. Срабатывание за 5–30 секунд, поддержка synchronous и asynchronous репликации, REST API для управления. Работает на голом Linux без кластерной ФС.
HAProxy + Keepalived в веб-фронте
Классическая связка для веб-нагрузки. HAProxy балансирует трафик между двумя бэкендами (active/active), а Keepalived обеспечивает резерв самого HAProxy через VIP. Когда отказывает один веб-сервер, HAProxy исключает его из ротации; если падает один HAProxy, VIP переезжает на второй. Никакого downtime для клиентов.
Требования к железу у HA
Кластер — это не просто два сервера рядом. Есть базовые требования к конфигурации железа, без которых система не работает надежно.
Минимум 2 узла + witness для quorum
Две ноды без witness — потенциальный split-brain, когда heartbeat рвется. Поэтому третий компонент в роли арбитра обязателен: третий полноценный узел, witness-disk в общем хранилище, file share witness на отдельной машине или cloud witness в облаке. У критичных систем рекомендуется именно три полноценных сервера в кластере.
Идентичные конфигурации серверов
Ноды кластера должны быть максимально одинаковыми по CPU, RAM, дискам, сетевым картам. Это упрощает балансировку нагрузки, исключает «slow node» эффект (когда одна нода медленнее и тормозит весь кластер) и сокращает риски при failover — резерв должен потянуть полную нагрузку и без сюрпризов. Выбирать серверы в кластер разумно сразу парой или тройкой одинаковой комплектации.
Дублирование сетевых интерфейсов (bonding, MLAG)
Сетевой интерфейс — одна точка отказа. Решение — bonding (LACP) с двумя физическими портами в одном логическом интерфейсе. На стороне коммутаторов — MLAG (Multi-chassis Link Aggregation), чтобы каналы шли в два разных свича. Если отказывает любой компонент (порт, кабель, свитч), трафик идет по второму без потери.
Общее хранилище vs shared-nothing
Подходов к данным два, и выбор сильно влияет на архитектуру. Shared storage (общий SAN или iSCSI) — кластер крутится с одним массивом, и при failover второй узел просто получает доступ к тем же данным. Требует кластерной файловой системы (CSV в Windows, OCFS2 или GFS2 в Linux) и серьезного SAN. Shared-nothing — каждый узел держит свою копию данных, а синхронизация идет через репликацию на уровне приложения или СУБД. Здесь репликация и есть единственный способ синхронизировать состояние. Дешевле, проще, современнее — 80% новых проектов идет по shared-nothing.
Сколько стоит failover-кластер
Затраты делятся на капитальные и операционные. К CapEx относят дополнительный сервер, хранилище или диски под репликацию и лицензии на ПО резервирования, если оно платное. В OpEx ложатся электропитание удвоенного парка, обслуживание, поддержка и часы инженеров на более сложную эксплуатацию. Разница с одиночной машиной проявляется не только при покупке, но и весь срок сопровождения.
Честную картину дает расчет совокупной стоимости владения (TCO) на три-пять лет: суммируют CapEx и OpEx за период и сопоставляют с потерями от простоев за тот же срок, посчитанными по формуле стоимости часа простоя из блока о метриках. На сценариях с дорогим простоем вложение выходит в плюс быстро, на сценариях с дешевым может не окупиться никогда. Этот расчет стоит сделать до закупки, а не после.
Типовые ошибки при внедрении HA
Опыт показывает: HA-кластер с хорошими компонентами легко собрать неправильно, и тогда он не работает. Вот самые частые промахи.
Один сетевой коммутатор как единая точка отказа
Две машины в кластере подключены через один коммутатор. Коммутатор умирает — оба узла теряют связь, никакого failover нет. Решение очевидное: два независимых коммутатора с MLAG между собой, каждый сервер имеет линки в оба свича.
Один heartbeat-канал
Единственный канал служебной связи между узлами сам становится точкой отказа. Когда он рвется, узлы перестают видеть друг друга и либо встают, либо уходят в split-brain, когда оба считают себя главными. Heartbeat прокладывают минимум по двум независимым каналам, например через выделенный интерфейс и через основную сеть.
Witness без резервирования
Witness добавляет решающий голос в кворум, но если он завязан на одну точку, ее отказ парализует кворум вместе с ним. Witness размещают на компоненте, который не подвержен тем же отказам, что и основные узлы: на отдельной машине, в другом хранилище или в облаке.
Отсутствие тестов отказа (chaos engineering)
Авторезерв без проверки временем — это просто конфигурация. Инженеры не знают, как он ведет себя в реальном инциденте, какие сервисы не поднимаются, какие скрипты падают. Стандарт зрелых компаний — тест failover раз в квартал в окно обслуживания. Гасится одна машина, кластер должен среагировать, журналы анализируются.
Сложный «умный» скрипт переключения без отката
Команда пишет хитрый shell-скрипт, который проверяет десять условий перед срабатыванием. На бумаге работает. А в реальном инциденте зависает на одной проверке, и срабатывание не происходит. Принцип такой: чем проще логика срабатывания, тем надежнее. STONITH плюс базовые проверки доступности дают результат предсказуемее, чем избыток проверок.
Планируете построить кластер под 1С, PostgreSQL, веб-фронт или ERP-систему? Наши инженеры подберут серверы под active/passive или active/active, спроектируют heartbeat-сеть, witness-узел и регламент тестирования переключения. Закажите подбор сервера на задачу — после расчета будет понятна реальная стоимость и сроки внедрения.
Сценарии перехода
К отказоустойчивости приходят постепенно, и резкий скачок не обязателен. Первый шаг — от одного сервера к схеме active/passive: добавляют второй узел и witness, настраивают репликацию и автоматическое переключение, и система получает базовую отказоустойчивость. Это закрывает большинство потребностей среднего бизнеса.
Дальше масштабируют по мере роста требований: от active/passive к geo-кластеру между двумя ЦОД для защиты от отказа площадки. Распространен и гибрид — продуктив в кластере на своей площадке плюс аварийное восстановление (DR) в облаке. Такой подход дает географическое разнесение без второго собственного дата-центра. Каждый шаг добавляет устойчивости и стоимости, поэтому их проходят по мере реальной необходимости.
Заключение
Подведем итоги. Резервный узел — это проектное решение: он требует мониторинга, регулярного тестирования и идентичной конфигурации с основным. Главные принципы простые: минимум 2 узла + 1 witness для кворума, идентичная конфигурация, дублированная сеть, четкое разделение active/passive или active/active по характеру нагрузки. Время отклика зависит от инструмента: Pacemaker 3–10 секунд, Patroni 5–30 секунд, VMware HA 1–5 минут. RPO определяется типом репликации: синхронная даст 0, асинхронная — секунды или минуты.
Главные ошибки внедрения — один коммутатор как единая точка отказа, отсутствие регулярных тестов переключения и сложные «умные» скрипты вместо простой логики STONITH. Стоимость HA окупается через предотвращенные инциденты: если час простоя по формуле обходится дороже годовой стоимости кластера, он платит за себя за один сценарий в год. А вот внутренним сервисам с допуском к простою в часы авторезерв не нужен — достаточно регулярного бэкапа.
Короткий порядок принятия решения:
- Определить RTO и RPO, которые требует бизнес от конкретного сервиса;
- Посчитать стоимость часа простоя и сравнить ее с ценой кластера;
- Если простой дешев или допустим в часах, обойтись бэкапом и горячим резервом;
- Если счет на секунды и деньги, выбрать архитектуру active/passive или active/active;
- Заложить два heartbeat-канала, резервируемый witness и защиту от split-brain;
- Запланировать регулярный тест переключения, без которого кластер не считается рабочим.
Ответы на частые вопросы
Что такое failover-сервер простыми словами?
Это бэкап-нода, которая автоматически берет на себя нагрузку основного сервера при его отказе. Без участия администратора, без ручных переключений, без долгого восстановления из бэкапа. Время срабатывания — от нескольких секунд (Pacemaker, Keepalived) до пары минут (VMware HA).
Чем failover отличается от резервного бэкапа?
Бэкап — это копия данных «на полке», и для запуска работы с него нужно восстанавливать базу и приложение часами. Failover-сервер устроен иначе: он уже подготовлен к работе, держит синхронную копию и переключается автоматически за секунды. Бэкап нужен в любом случае (защита от логических ошибок и шифровальщиков), а failover — дополнительный слой защиты от технических отказов.
Сколько времени занимает автоматическое переключение?
Зависит от инструмента и архитектуры. Keepalived с VRRP — 1–3 секунды (только сетевой VIP). Pacemaker + Corosync — 5–30 секунд (с поднятием сервисов). Patroni для PostgreSQL — 5–30 секунд. WSFC для MS SQL AlwaysOn — 10–60 секунд. VMware HA с перезапуском ВМ — 1–5 минут.
Что такое split-brain и как от него защититься?
Split-brain — ситуация, когда два узла кластера одновременно считают себя active и принимают запись. Возникает при разрыве heartbeat-канала между ними. Защита — кворум через witness (третий узел или disk-witness в общем хранилище) и STONITH (принудительное отключение зависшего узла). Без обоих механизмов риск порчи данных в случае инцидента очень высок.
Сколько узлов минимум нужно для failover-кластера?
Технически — 2. Но с двумя узлами без witness любой разрыв heartbeat между ними приводит к риску split-brain. Минимальная безопасная конфигурация — 2 рабочих узла + 1 witness (третий полноценный сервер или disk-witness). У серьезных систем планируется сразу 3 одинаковых узла с равными правами.
Нужен ли отдельный witness-сервер?
В большинстве случаев — да. Альтернативы: disk-witness в общем SAN, file share witness на отдельной машине, cloud witness в облаке. Главное — чтобы это был независимый компонент, не подверженный тем же отказам, что и основные узлы кластера.
Подходит ли failover для 1С и MS SQL?
Да, это типовой сценарий. Для MS SQL — связка WSFC + AlwaysOn FCI или AG, RTO 10–60 секунд. Для сервера приложений 1С — обычно отказоустойчивость на уровне виртуализации (VMware HA, Hyper-V Failover Cluster) с автоматическим перезапуском ВМ. А для базы 1С на PostgreSQL — Patroni-кластер.
Как протестировать failover, не сломав продакшен?
Стандартная практика — тест в окне обслуживания раз в квартал. План такой: оповещение пользователей, физическое или программное гашение одной машины, фиксация времени срабатывания, проверка всех сервисов на резервном узле, возврат основного, тест failback. Параллельно — chaos engineering на тестовом стенде: random kills для отработки сценариев, которые в проде специально не воспроизводишь.
Из FAQ статьи «Отказоустойчивый кластер (failover)…» перенести вопрос (в ответе «минуты простоя» заменено на «часа простоя»). Оформление вопроса — как у остальных вопросов этого блока:
Окупается ли кластер для малого бизнеса?
Только если простой сервиса стоит ощутимых денег. Для внутренних систем с допустимым простоем в часы кластер избыточен — дешевле бэкап и горячий резерв. Решение принимают по расчету стоимости часа простоя, а не по размеру компании.