

InfiniBand или Ethernet для обучения моделей — вопрос, который встает перед инженером при переходе на распределенную тренировку сразу нескольких узлов. После каждого шага или группы шагов узлы синхронизируют градиенты с помощью операции all-reduce, и задержка сети в этот момент оставляет дорогостоящие GPU без полезной нагрузки. Библиотека NCCL задействует RDMA-сети, InfiniBand или RoCE, для коллективных операций, а на обычном Ethernet без RDMA синхронизация проходит через CPU и системную память. Рост числа узлов увеличивает вклад сетевого обмена в итоговое время тренировки.
Объем передаваемых градиентов растет вместе с моделью и уже для моделей на десятки миллиардов параметров может составлять десятки гигабайт за одну синхронизацию. Этот обмен повторяется на каждом шаге обучения, поэтому небольшая задержка на одной операции накапливается на протяжении всей эпохи.
Что происходит в сети при распределенном обучении: all-reduce и синхронизация градиентов
Распределенное обучение больших моделей делит вычисления между узлами кластера: каждый узел обрабатывает свою часть батча данных и считает градиенты локально. После каждого шага или группы шагов узлы должны привести градиенты к общему значению — эта операция называется all-reduce, и синхронизация происходит на каждой итерации обучения, а не время от времени.
Часть обмена градиентами можно перекрыть вычислениями обратного прохода, как это делает Distributed Data Parallel. Ожидание возникает, когда нужный обмен не завершен к моменту использования результата, поэтому оценивать следует неперекрытое время коммуникаций. Рост числа узлов и частоты синхронизации увеличивает долю ожидания сети в общем времени обучения.
Алгоритмов all-reduce несколько — ring all-reduce и tree all-reduce с их вариациями, но суть одна: каждый узел получает усредненное значение градиентов от всех остальных, прежде чем перейти к следующему шагу оптимизации. Пока обмен не завершен, следующий шаг начать нельзя.
GPU-серверы для обучения — обычно стоечные системы объемом 2U-8U на 8-10 видеокарт с поддержкой NVLink для связи внутри одного узла. NVLink и InfiniBand решают разные задачи: NVLink объединяет карты внутри сервера, а трафик синхронизации между серверами идет через отдельную InfiniBand или RoCE-фабрику — быстрая связь внутри узла не компенсирует медленную сеть между узлами.
Размер градиентного обмена зависит от числа параметров и формата представления данных. Для модели на десятки миллиардов параметров одна синхронизация может передавать десятки гигабайт, а для крупнейших моделей — сотни гигабайт. Операция повторяется на каждом шаге, поэтому за одну эпоху сеть обслуживает тысячи таких обменов.
Почему выбор сети критичен именно при обучении, а не при инференсе
Вопрос infiniband или ethernet стоит острее именно при обучении, потому что синхронизация между узлами происходит регулярно и предсказуемо — на каждом шаге градиентного спуска.
При инференсе на одном сервере или при простом горизонтальном масштабировании без частой межузловой синхронизации задержка сети почти не влияет на итоговый результат: запросы обрабатываются независимо друг от друга, а узлы кластера почти не общаются между собой в процессе обработки.
Обучение устроено принципиально иначе: без завершенной синхронизации нельзя перейти к следующему шагу, поэтому задержка сети становится частью критического пути вычислений, а не фоновым процессом.
Более широкое сравнение сетевых технологий приведено в статье «InfiniBand vs Ethernet: что выбрать для GPU-кластера». Здесь речь идет именно об обучении, где задержка на каждой синхронизации накапливает простой GPU. RoCE требует согласованной настройки адаптеров и сети. В режиме lossless применяют управление потоком по приоритетам PFC и уведомления о перегрузке ECN. Некоторые реализации поддерживают режим без PFC, поэтому нужную конфигурацию выбирают по документации оборудования и проверяют под нагрузкой.
Как RDMA и NCCL снижают задержку синхронизации
GPUDirect RDMA убирает CPU и оперативную память из пути данных между GPU разных узлов — карты обмениваются данными напрямую через сеть, минуя лишние копирования в системную память.
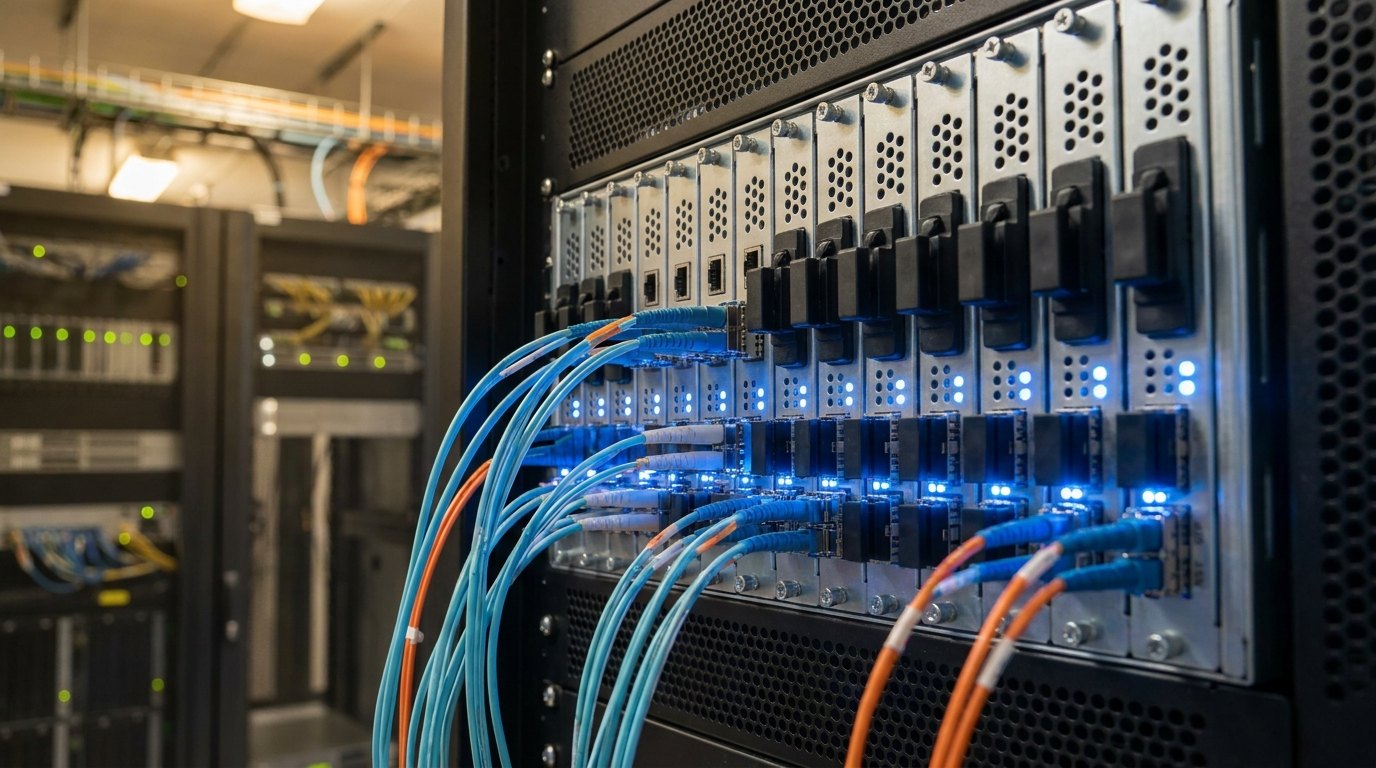
Сетевые адаптеры для ИИ-инфраструктуры с аппаратной поддержкой RDMA нужны здесь не для увеличения полосы как таковой, а для того, чтобы синхронизация вычислений при распределенном обучении не упиралась в задержку каждого перехода через процессор.
В GPU-кластере библиотека NCCL строит поверх RDMA-сети граф коллективных операций и распределяет трафик синхронизации так, чтобы сократить общее время all-reduce с учетом конкретной топологии.
Настройка NCCL под конкретную топологию — отдельная инженерная задача: библиотека выбирает между разными алгоритмами коллективных операций в зависимости от числа узлов и объема данных, но для этого ей нужна корректная информация о топологии и работающий RDMA-стек на каждом узле.
Rail-optimized дизайн: один адаптер на GPU для равномерной синхронизации
Rail-optimized дизайн сети — конфигурация, при которой каждый GPU в сервере получает собственный сетевой адаптер, а не делит один адаптер с соседними картами. Такая схема снижает конкуренцию за пропускную способность именно в момент коллективных операций синхронизации, когда все GPU одновременно передают данные соседним узлам.
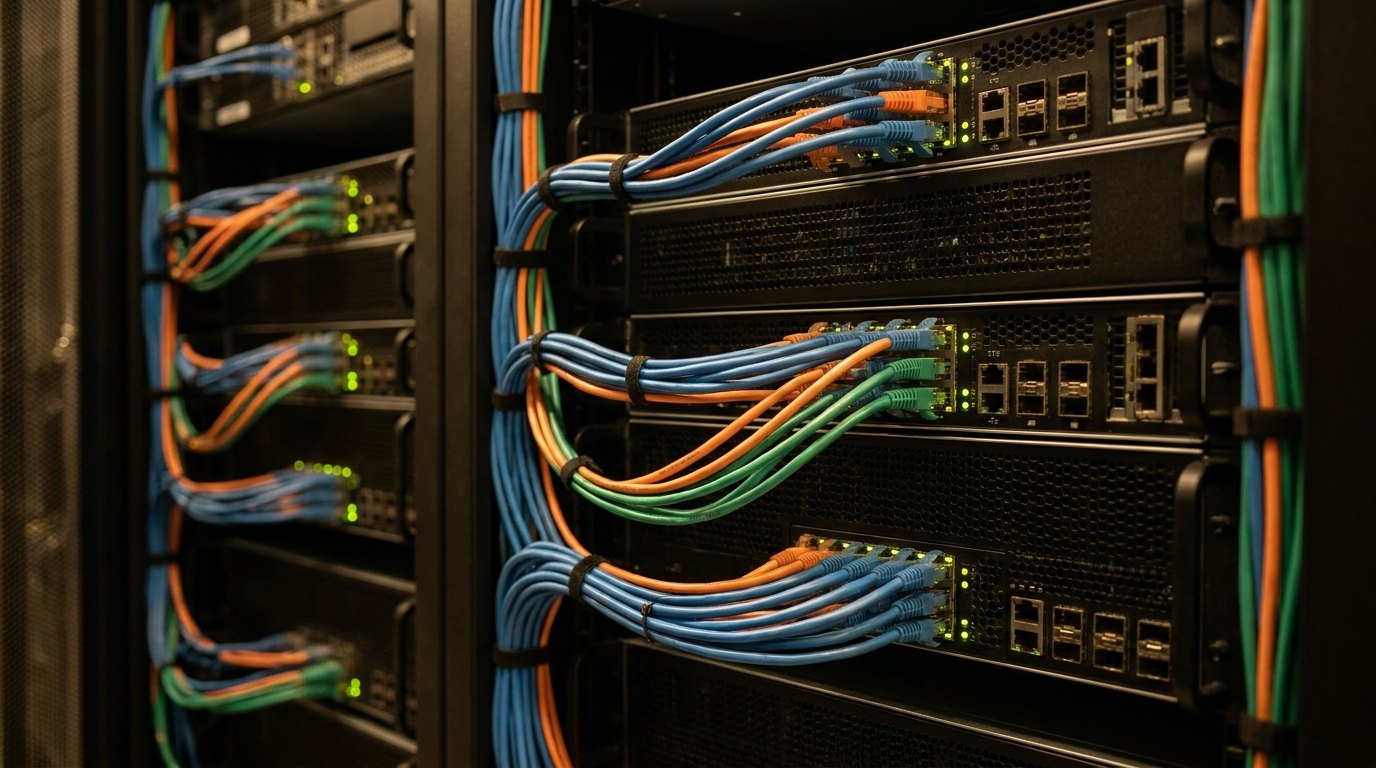
Без rail-optimized дизайна несколько GPU одного сервера конкурируют за полосу общего адаптера в момент синхронизации. Одновременный трафик от разных карт создает очередь, поэтому задержка может расти непропорционально увеличению числа ускорителей.
Готовая конфигурация сервера на восемь ускорителей для корпоративных задач ИИ собирается уже с учетом равномерного распределения адаптеров по картам, без узких мест в момент синхронизации.
При масштабировании на десятки узлов равномерность синхронизации напрямую сказывается на том, насколько линейно растет скорость обучения с добавлением новых серверов.
Что происходит при обучении на Ethernet без RDMA
На обычном Ethernet без RDMA операция all-reduce идет через стек CPU и оперативной памяти каждого узла: данные копируются из памяти GPU в системную память, обрабатываются процессором и только затем уходят в сеть. Каждая такая итерация добавляет задержку, которая на фоне единичной синхронизации кажется незначительной, но при тысячах шагов обучения складывается в заметную долю общего времени тренировки.
Дополнительная проблема Ethernet без RDMA — предсказуемость. Обработка через стек CPU зависит от текущей загрузки процессора другими задачами операционной системы, поэтому задержка синхронизации колеблется от итерации к итерации, и может увеличивать время ожидания. RDMA снижает часть накладных расходов, но не исключает колебаний задержки при перегрузке сети.
Сетевые коммутаторы для трафика кластера сами по себе не включают RDMA на серверах. Нужны совместимые адаптеры и настроенный программный стек, а пропускную способность сети оценивают вместе с задержками обработки данных внутри узлов.
Для небольших экспериментов и прототипирования такой путь может быть приемлем, но для продуктивного обучения на нескольких узлах он превращается в постоянный источник простоя GPU.
Как оценить, насколько сеть станет узким местом для вашей задачи
Чтобы понять влияние сети на скорость обучения, сравните время синхронизации со временем вычислений. Добавление узлов само по себе не меняет число синхронизаций на шаг: оно зависит от алгоритма обучения и накопления градиентов. При небольшом локальном батче вычислений между обменами может быть мало, поэтому долю ожидания измеряют при фиксированных настройках.
Практический способ проверки — сравнить время одного шага обучения на одном узле и на нескольких. Если время шага растет непропорционально числу добавленных узлов, разница чаще всего объясняется временем на синхронизацию, а не ростом вычислительной нагрузки. Отдельно стоит посмотреть на латентность синхронизации при разном количестве узлов: рост латентности быстрее числа узлов — верный признак того, что сетевая фабрика не справляется с текущей топологией.
Увеличение размера батча на каждом узле частично сглаживает проблему — синхронизация происходит реже относительно объема выполненных вычислений. Но у этого приема есть предел: слишком крупный батч меняет динамику обучения и может ухудшить итоговое качество модели.
Проверку сети стоит начать с трех признаков. Первое — линейность масштабирования падает: добавление новых серверов не дает пропорционального роста скорости обучения. Второе — в текущей схеме нет отдельного сетевого адаптера на каждый GPU, и карты одного узла конкурируют за общую полосу. Третье — RDMA-стек настроен не полностью, и NCCL откатывается на обработку через CPU вместо прямого пути между картами. Эти признаки не доказывают, что замена сети выгоднее добавления сервера. Решение принимают по профилю вычислений и замерам коллективных операций при одинаковых настройках модели и батча.