

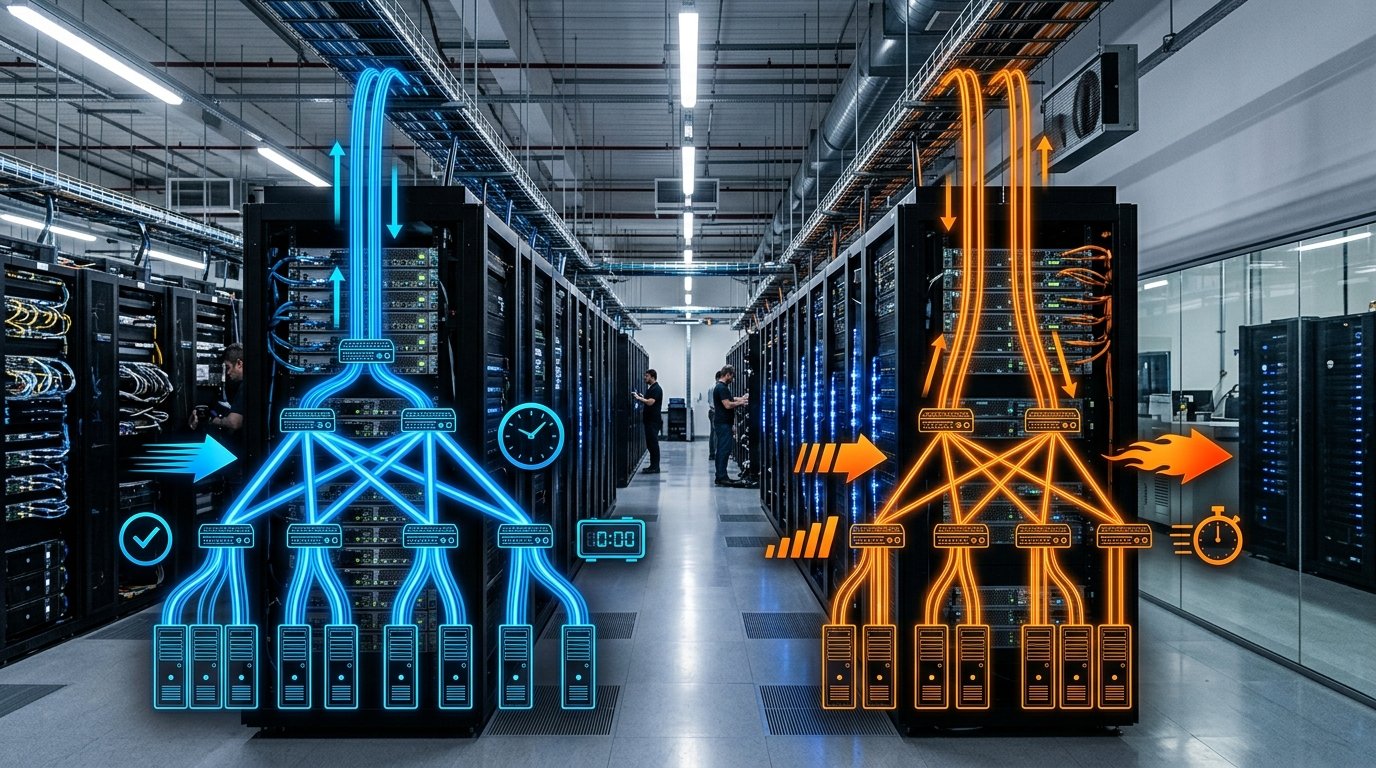
InfiniBand vs Ethernet — это выбор между двумя разными способами передавать данные между вычислительными узлами GPU-кластера, у каждого своя задержка и своя стоимость порта. Результат зависит от профиля обмена и масштаба кластера: для одних задач стандартный Ethernet обеспечивает нужную производительность, для других его стек становится ограничением. Поэтому сеть оценивают вместе с серверами и топологией кластера, а не как отдельную строку спецификации. Выбор подтверждают тестом на рабочем профиле, поскольку номинальная скорость порта не описывает поведение приложения.
При проектировании стоит разделять внутрисерверные и межсерверные соединения. NVLink или NVSwitch связывает GPU внутри одного узла, тогда как InfiniBand либо Ethernet формирует фабрику между узлами. Даже сервер с восемью-десятью ускорителями не превращает внутреннюю шину в кластерную сеть: для масштабирования за пределы корпуса нужны сетевые адаптеры и коммутаторы с согласованной пропускной способностью, а кабели подбираются под них отдельно.
Чем InfiniBand отличается от Ethernet технически
InfiniBand изначально разрабатывался как специализированная фабрика для дата-центров и высокопроизводительных вычислений. В его архитектуре RDMA является базовым механизмом: адаптер может передавать данные напрямую между областями памяти узлов, уменьшая участие процессора и число копирований. Это снижает накладные расходы и делает задержку предсказуемее. Освобождённый ресурс CPU достаётся прикладной нагрузке.
Классический Ethernet использует привычный сетевой стек операционной системы. Пакеты проходят обработку на CPU, а данные копируются через оперативную память. Такая схема универсальна и хорошо знакома администраторам. Она совместима с существующей инфраструктурой, но при частых межузловых обменах создает дополнительную задержку. Разрыв особенно заметен не в передаче одного большого файла, а при серии коротких операций, когда стоимость каждого перехода складывается.
Задержка и пропускная способность: сравнение показателей
В сравнении InfiniBand Ethernet важно различать скорость линии и полезную производительность приложения. Одинаковое значение Гбит/с на порту не гарантирует одинаковое время обмена: влияют протокол и число переходов, а также размер сообщения и загрузка очередей. Для InfiniBand задержка одного перехода через коммутатор может находиться на уровне сотен наносекунд. У обычного Ethernet без RDMA полный путь через программный стек дает задержку на порядок или два выше, хотя фактический результат определяется платформой и настройками.
Сравнение параметров InfiniBand и Ethernet
Параметр | InfiniBand | Обычный Ethernet | Ethernet с RoCE |
|---|---|---|---|
Механизм обмена | Аппаратный RDMA | Стек CPU и памяти | RDMA поверх Ethernet |
Задержка коммутации | Сотни наносекунд на переход | Выше из-за программной обработки | Близка к RDMA при корректной настройке |
Пропускная способность порта | HDR 200 Гбит/с, NDR 400 Гбит/с | Зависит от поколения Ethernet | Зависит от скорости Ethernet |
Потери пакетов | Фабрика рассчитана на контролируемый обмен | Допустимы и обрабатываются протоколами | Нужен режим без потерь для приоритетного трафика |
Относительная стоимость порта | Обычно выше сопоставимого Ethernet | Обычно ниже | Может приблизиться к InfiniBand с учетом DCB |
Совместимость с сетью | Отдельная фабрика | Работает в текущей IP-сети | Ethernet-коммутаторы с поддержкой DCB |
Зрелость экосистемы | Узкий круг вендоров | Широкая, зрелая | Растущая, нужны навыки |
Для раскрытия потенциала линии нужны соответствующие сетевые карты. Высокоскоростные адаптеры с поддержкой RDMA и InfiniBand сокращают путь данных между узлами и могут работать с GPUDirect RDMA, когда программный стек и платформа это поддерживают. Подбирать такие сетевые карты для ИИ следует с учетом числа портов и шины PCIe, а также целевой топологии кластера: быстрый порт не компенсирует узкое место внутри сервера.
RDMA поверх Ethernet (RoCE) как промежуточный вариант
RoCE переносит преимущества удаленного доступа к памяти в Ethernet-среду. Адаптер выполняет значительную часть операций аппаратно, поэтому CPU меньше участвует в передаче данных. Для организации, где уже есть компетенции по Ethernet и совместимые коммутаторы, этот вариант позволяет сохранить знакомую технологическую базу и получить задержку, близкую к RDMA-фабрике.
Однако RoCE — не обычный Ethernet с другой картой. Для стабильной работы на загруженной фабрике настраивают DCB и приоритизацию трафика, а также механизмы управления перегрузкой. Потери пакетов в приоритетном классе должны быть исключены, иначе повторные передачи и паузы ухудшат предсказуемость. Ошибка в одном участке может влиять на весь путь между серверами.
Стоимость порта и совокупная стоимость сети
Порт InfiniBand обычно дороже сопоставимого по скорости порта стандартного Ethernet. Но закупочная цена не отражает всю экономику. В расчет входят адаптеры и коммутаторы, а также кабели между ними. Отдельно оценивают проектирование и эксплуатацию: резервирование и сопровождение. Точные суммы зависят от поставщика и доступности оборудования, а также от размера фабрики, поэтому сравнение без актуального прайса корректно вести только в относительных величинах.
У RoCE начальная стоимость может выглядеть ниже, если часть Ethernet-инфраструктуры уже подходит по скорости. Разница тает именно на тех статьях, где RoCE требует тех же вложений, что и InfiniBand: сертифицированные lossless-коммутаторы и настройка DCB, а также постоянный мониторинг очередей. Чем ближе конфигурация RoCE к этому набору, тем меньше смысла в экономии на старте.
Когда достаточно Ethernet, а когда нужен InfiniBand
Выбор между Ethernet и InfiniBand начинается с профиля трафика, а не с сравнения паспортных скоростей порта. Стандартного Ethernet достаточно, когда задания слабо связаны, основная передача идет к хранилищу, а межузловые сообщения редки. Он также рационален для пилотного кластера, если текущая скорость подтверждена тестом и архитектура допускает последующее обновление фабрики.
InfiniBand нужен, когда производительность зависит от частых обменов между узлами и важна стабильная низкая задержка. Это характерно для плотно связанных вычислений и масштабирования одной задачи на несколько серверов, а также для сценариев, где каждый этап ждет данные от соседних узлов. Чем больше размер кластера, тем сильнее влияют топология и число переходов.
При выборе коммутаторов для сетевой фабрики кластера проверяют скорость порта и неблокирующую коммутацию, а отдельно закладывают запас портов для расширения. Коммутаторы следует рассматривать вместе с кабелями и адаптерами: несовпадение скоростей или переподписка аплинков меняют результат сильнее, чем название технологии в спецификации.
Между этими крайностями RoCE стоит выбирать, если у команды уже есть опыт эксплуатации DCB и мониторинга сети без потерь — иначе выигрыш в задержке съедается рисками при настройке. Если сеть обслуживает смешанный трафик, классы обслуживания проектируют так, чтобы поток данных GPU не блокировал управление и доступ к хранилищам.
Обучение и инференс: разные требования к сети
При обучении gpu кластер часто выполняет одну задачу сразу на множестве ускорителей. При распределенной обработке узлы регулярно обмениваются результатами, поэтому задержка и пропускная способность сети влияют на масштабирование. Здесь InfiniBand или корректно построенный RoCE снижает время ожидания и помогает приблизить прирост производительности к добавленному числу GPU. Детальная механика коллективных операций остается отдельной темой. Для выбора технологии достаточно измерить долю межузлового обмена и чувствительность задания к задержке.
Инференс устроен иначе. Если запросы распределяются между независимыми репликами модели, узлы могут почти не обмениваться данными во время расчета. Тогда Ethernet часто закрывает требования, а приоритет получают пропускная способность входного потока и доступ к хранилищу. Если модель разбита между серверами или контекст передается по конвейеру, требования приближаются к обучению: задержка каждого межузлового шага входит во время ответа.
Как выбрать сеть под конкретный кластер
- Зафиксировать сценарий: одна задача занимает несколько узлов или каждый сервер работает независимо. Оценить размер сообщений и частоту обмена, а также допустимое время ожидания — по профилированию приложения или тесту на близкой конфигурации, а не по общей характеристике фреймворка.
- Построить модель роста: для небольшого стенда подходят прямые связи или простая фабрика, но расширение меняет число портов и путей трафика. Заранее определяют целевой масштаб и отказоустойчивость, а также запас пропускной способности. Для Fat-Tree расчет ведят по каждому уровню, чтобы аплинки не стали точкой перегрузки.
- Сравнить три варианта на одинаковой базе: обычный Ethernet, RoCE и InfiniBand. Для каждого фиксируют полезную скорость и задержку под нагрузкой, а также стоимость полного контура, включая трудозатраты команды и доступность специалистов. Так видно, где дорогой порт сокращает время вычислений, а где останется резервом.
Выбор сети имеет смысл только вместе с проверкой самих серверов: если адаптеров на узел или пропускной способности PCIe не хватает, даже быстрая InfiniBand-фабрика упрётся в узкое место внутри сервера, а не между ними.
Перед утверждением проекта — пять вопросов:
- Какова доля времени, которую приложение тратит на обмен между узлами?
- Нужна ли предсказуемая задержка при одновременной работе нескольких задач?
- Есть ли у команды опыт сопровождения DCB и сети без потерь?
- До какого числа серверов вырастет кластер в расчетный период?
- Окупит ли сокращение простоя GPU разницу в стоимости фабрики?
Если межузловые обмены редки и задания выполняются независимо, оправданным выбором остаётся Ethernet с запасом на модернизацию. Если одна задача регулярно использует несколько серверов, сравнивайте InfiniBand и RoCE на рабочем профиле нагрузки. Без опыта DCB и сети без потерь закладывайте в RoCE бюджет на обучение команды или подрядчика — иначе экономия на порту уйдёт на устранение ошибок. До закупки зафиксируйте число узлов и допустимую задержку, затем сопоставьте экономию времени GPU со стоимостью фабрики.