

Распределение мощности
Распределение мощности процессоров для эффективной работы стратегий параллелизма, таких как MirroredStrategy
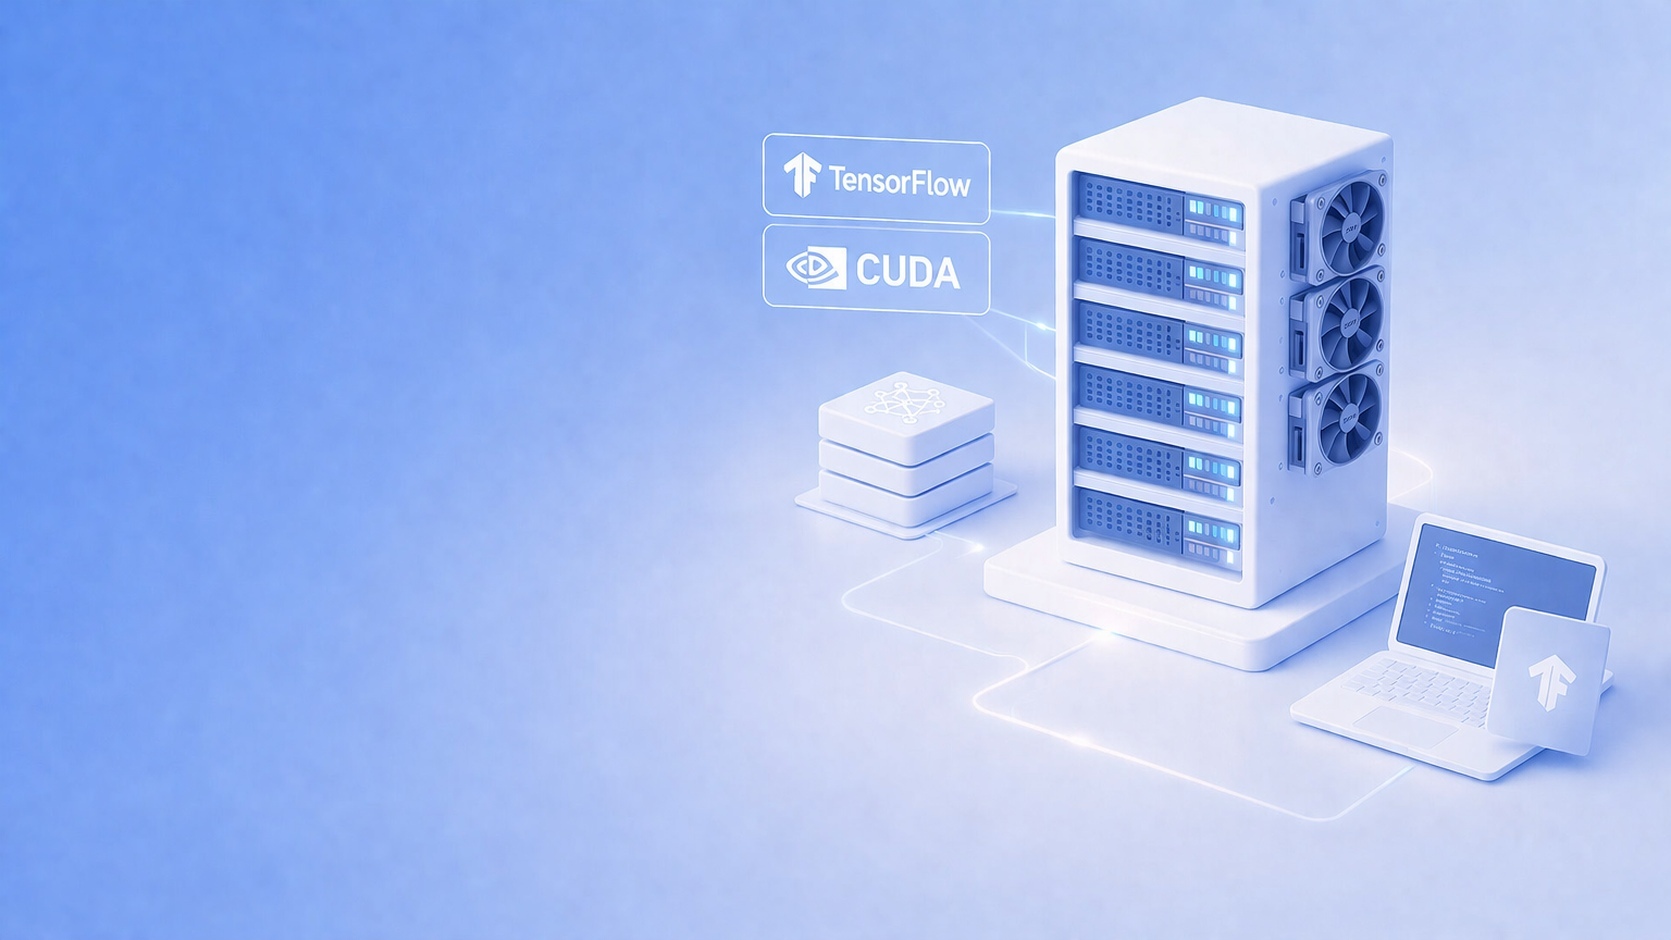
Правильный выбор ускорителей позволит вашей команде значительно сократить время обучения, исключив проблемы с нехваткой памяти или пропускной способностью шины. Мы внедрим производительное решение, которое превратит обычные серверы в мощные вычислительные узлы, полностью готовые к задачам глубокого обучения любой сложности
 В реестре

Рейтинг компании


Графический процессор с поддержкой специализированных ядер обеспечивает кратное ускорение операций свертки и умножения матриц. Наша команда поможет построить архитектуру, оптимизированную под нужды вашего ML-департамента
Распределение мощности
Распределение мощности процессоров для эффективной работы стратегий параллелизма, таких как MirroredStrategy
Ускорение операций
Обеспечение бесшовной работы с библиотеками CUDA и cuDNN для максимального ускорения тензорных операций
Высокая скорость
Реализовация высокой скорости обмена данными между узлами при использовании технологий распределенного обучения
Хранение данных
Создать надежную систему хранения, способную обеспечить бесперебойную подачу данных для конвейеров TensorFlow
Производительность и энергопотребление
Оптимизация расходов с помощью сервера с GPU, который обеспечит лучший баланс производительности и энергопотребления
Масштабируемая вычислительная мощность и полная совместимость с CUDA
Оптимизация дисковой подсистемы для ускорения обучения
Отказоустойчивость и интеллектуальное управление ресурсами
Оставьте заявку, и мы свяжемся с вами в ближайшее время

Оптимальный сервер для прототипирования и малых проектов

Мощная станция для глубокого обучения и работы с Big Data

Серверные узлы для производственных сред и инференса


Тщательный анализ требований к видеопамяти исходя из размера батчей и сложности графа модели

Точный расчет пропускной способности сети для эффективной синхронизации параметров в кластере

Оценка производительности центрального процессора для бесперебойной работы ETL-процессов

Выбрать оптимальный форм-фактор корпуса для обеспечения эффективного теплоотвода
Проверка совместимости версий cuDNN и драйверов с конкретными релизами TensorFlow
Проектирование систем бесперебойного питания для защиты результатов длительных расчетов

Создать регламенты мониторинга и оповещения о критических нагрузках на аппаратную часть
Профессиональная инсталляция и конфигурирование окружения
Масштабируемость и модернизация существующих мощностей
Регулярный аудит и мониторинг вычислительных ресурсов
Оставьте заявку, и наши инженеры проведут детальный расчет ресурсов, подберут оптимальные ускорители и настроят систему под ключ. Мы подготовим проект, который полностью соответствует вашим задачам в области ИИ, включая работу по 44-ФЗ
Библиотека CUDA позволяет TensorFlow переносить выполнение наиболее трудоемких математических операций с центрального процессора на графический. Это обеспечивает параллельную обработку данных на тысячах ядер, что ускоряет обучение моделей в десятки и сотни раз.
Для большинства задач обучения эффективнее использовать несколько видеокарт среднего или высокого сегмента, объединенных в одну систему. Это позволяет задействовать стратегии параллельного обучения и работать с моделями, которые не помещаются в память одного ускорителя.
Да, пропускная способность шины критична при передаче данных между системной памятью и GPU, а также при обмене данными между картами. Мы рекомендуем использовать серверы с поддержкой актуальных стандартов PCIe и достаточным количеством линий на каждый слот.
Для обучения простых моделей и отладки кода это возможно, но для серьезной работы в области ML отсутствие аппаратного ускорения сделает процесс крайне медленным и неэффективным. Использование GPU является обязательным условием для профессиональной разработки.
Заполните форму, и мы проведём бесплатный аудит: проверим серверы, сети и системы безопасности, определим риски и предложим план перехода на отечественное оборудование.