

Выход из облака
компания выходит из облака (Yandex Cloud, VK Cloud, Selectel) на свою инфраструктуру — облачные счета уже превысили CapEx за 12–18 месяцев
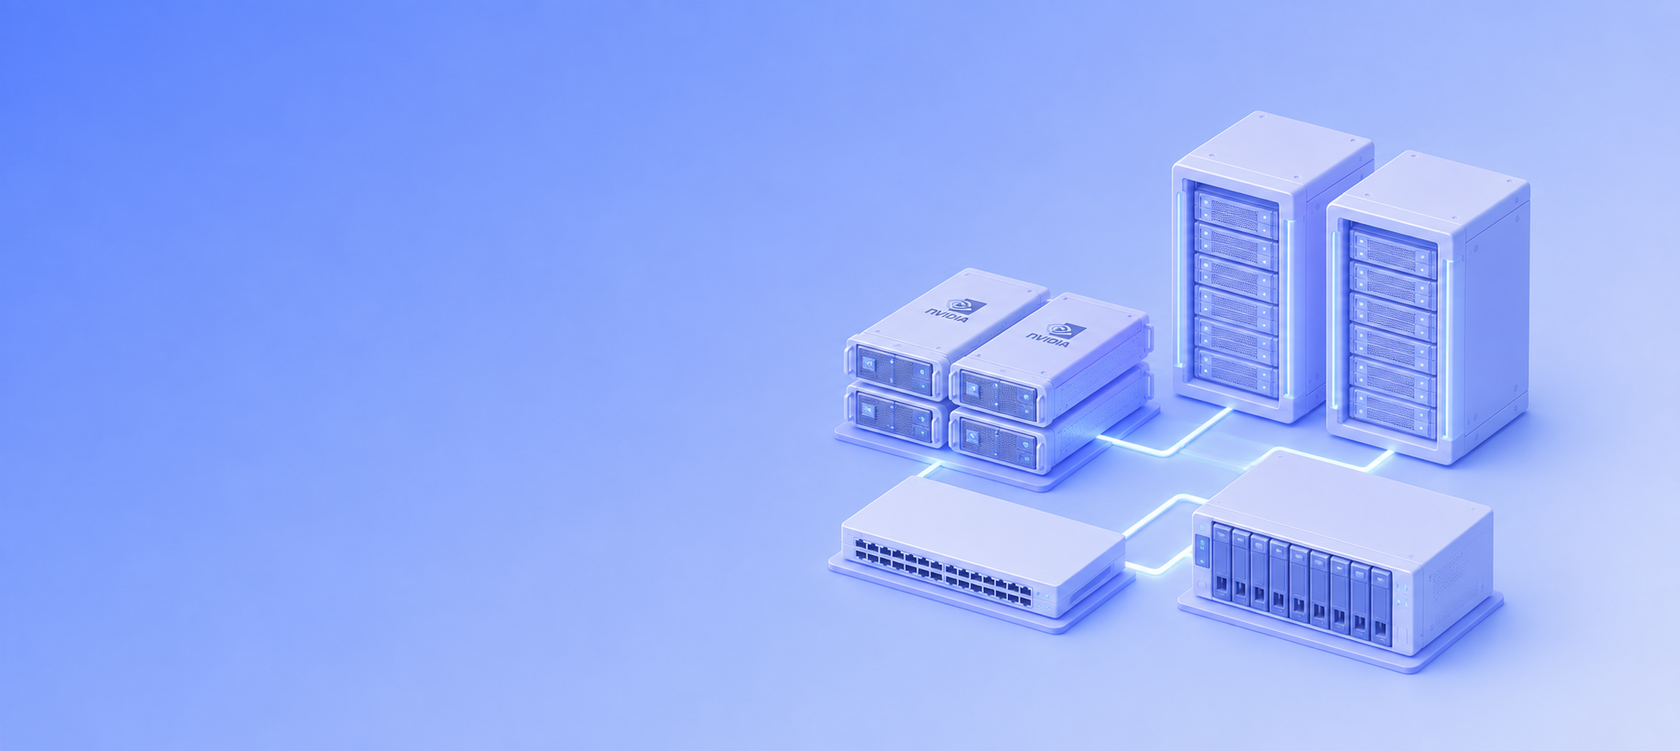
Инфраструктура для обучения ИИ-моделей — не одна коробка, а три уровня в связке: GPU-узлы H100/H200 с HBM и NVLink Switch, сетевая фабрика InfiniBand HDR 200 или NDR 400 с латентностью около 100 нс и GPUDirect RDMA, СХД под датасеты с параллельной ФС и локальным NVMe-кэшем в каждом узле
 В реестре

Рейтинг компании


Выход из облака
компания выходит из облака (Yandex Cloud, VK Cloud, Selectel) на свою инфраструктуру — облачные счета уже превысили CapEx за 12–18 месяцев
ML-платформа с нуля
строится новая внутренняя ML-платформа с нуля — 4–32 узла GPU, сеть, СХД, планировщик
Расширение GPU-кластера
расширяется существующий R&D-парк GPU-серверов до кластера с общей сетью и хранением
Закрытый контур
требования по данным (персональные, гостайна, коммерческая тайна) — обучение только в собственном ЦОД
Постоянная ML-нагрузка
отраслевая ML-платформа (банк, ритейл, промышленность) с постоянной нагрузкой и понятным горизонтом окупаемости
| Уровень | Что решает | Ключевые компоненты | Что ломает обучение при недостатке |
|---|---|---|---|
| Compute — GPU-узлы | Считает градиенты, обновляет веса | H100/H200 SXM в HGX 8-GPU, NVLink Switch внутри узла, DDR5 ECC, PCIe Gen5, локальный NVMe | Не хватает HBM → шардирование модели, слабый CPU → GPU голодает по данным |
| Network — сетевая фабрика | Связывает узлы для распределённого обучения (NCCL all-reduce) | HCA ConnectX-7, коммутаторы Quantum-2 QM9700, Fat-Tree, GPUDirect RDMA, MTU 4KB | Ethernet вместо InfiniBand → NCCL медленный → 30–50% времени обучения теряется |
| Storage — СХД под датасеты | Держит датасеты, чекпоинты, эмбеддинги | All-flash NVMe параллельная СХД (2–5 ГБ/с sustained на узел), холодный ярус S3, локальный NVMe-кэш в узле | Медленный I/O → GPU простаивают в ожидании batch, нет чекпоинт-политики → потеря 100+ часов обучения |
| Инженерка (транспарентно) | Питает и охлаждает | PDU 32/63 А, три фазы, воздух до 12 кВт стойки или DLC до 50 кВт | Стойка не тянет мощность → плотность падает, ЦОД перегревается |
| Параметр подбора | На что влияет | Что уточняем у клиента |
|---|---|---|
| Задача обучения (fine-tuning / pre-training / inference) | Тип GPU (H100 vs H200), число узлов, класс СХД, интенсивность I/O | Стек обучения, размер модели, размер датасета |
| Размер модели и датасета | HBM в узле (80 vs 141 ГБ), объём СХД (10 ТБ vs 1 ПБ), тип ФС | Целевые параметры, объём токенизированного корпуса |
| Число узлов сейчас и через 12–24 мес | Топология фабрики (Fat-Tree 1:1 vs 2:1), число коммутаторов, объём СХД | План роста |
| Интенсивность I/O (dataloader) | Полоса СХД (2–5 ГБ/с на узел), размер локального NVMe-кэша | Отношение вычисление/I/O, batch size, форматы данных (JPEG, TFRecord, parquet) |
| Условия ЦОД | Тип охлаждения (воздух vs DLC), мощность на стойку, длины трасс | Мощность стойки, готовность к DLC, план расширения |
| Планировщик задач | Slurm vs Kubernetes с device-plugin, интеграция с MLOps | Что уже используется |
| Отказоустойчивость обучения | Checkpoint-политика на СХД, зеркалирование весов | Стоимость потерянного часа обучения |
| Импортозамещение и 44-ФЗ | Compute-платформа, СХД, сеть по уровням | Тип заказчика |

Стартовая ML-платформа для R&D-команды: 2–4 узла с 8×H100 SXM HGX
На что рассчитано: R&D-команда 5–15 инженеров, fine-tuning LLM 7B–70B, эксперименты с CV, накопление датасетов

Продуктивная ML-платформа: 8–32 узла с 8×H100 SXM HGX
На что рассчитано: ML-платформа с 30+ инженерами, pre-training крупных моделей, гибрид обучение + инференс

Крупная ML-фабрика: 32–128 узлов с 8×H100/H200 SXM HGX
На что рассчитано: pre-training foundation-моделей 70B–1T параметров, отраслевые LLM, крупные R&D-центры банков и корпораций
GPUDirect Storage
Локальный NVMe-кэш
Checkpoint-производительность
Rail-optimized обвязка
Обучение команды
Оставьте заявку и мы свяжемся с вами в ближайшее время
 GPU-узлы (собранные и прошитые)
 Коммутаторы и кабели
 СХД под датасеты, объектное хранилище для холодного яруса
 Локальный NVMe-кэш в каждом узле
 Питание стойки: проект схема резервирования, расчёт мощности
 Охлаждение стойки: воздух или DLCПрограммный стек, MLOps-интеграция, тестирование
 Обучение инженеров, постпродажное сопровождение


Заявка и обследование: 3–5 дней
задача обучения, размер моделей, объём датасетов, условия ЦОД, планы роста

Расчёт комплекса: 7–10 дней
конфигурация compute, топология сети, объём и класс СХД, ярусы хранения, питание, охлаждение

Согласование, договор
по графику клиента

Поставка оборудования: 50–90 дней
GPU-узлы + HGX-платформы, коммутаторы Quantum-2, HCA ConnectX-7, СХ
Монтаж, настройка: 10–15 дней
Монтаж в стойки, коммутация питания и сети, подключение DLC при необходимости

Приёмочные тесты, сдача, обучение, документация, гарантия и постпродажное сопровождение
3–5 рабочих дня
Комплекс из серверов, сети и СХД
собираем комплекс из трёх уровней в связке, а не «сервера отдельно, сеть отдельно, СХД отдельно»

Опыт
опыт с HGX-платформами H100/H200, InfiniBand-фабриками Fat-Tree на 4–128 узлов, параллельными ФС (Lustre, GPFS, BeeGFS)
Инфраструктура
проектируем питание и охлаждение стойки — не «оборудование придёт, а куда ставить, вы разберётесь»
Вендоры и поставщики
Работаем под ТЗ, а не по прайсу «в наличии». Честно раскладываем импортозамещение по уровням. Compute (H100/H200) и сеть InfiniBand фактически NVIDIA-only, замещённой альтернативы в реестре Минпромторга нет. Compute-платформа может быть на российской (YADRO, KRAFTWAY) при совместимости с HGX

Постпродажное сопровождение
помогаем DevOps-инженерам с MLOps-стеком, обновлениями драйверов и расширением compute-парка
Пришлите задачу обучения (модели, размеры), объём датасетов, число узлов и условия ЦОД — по итогам заявки и расчёта (15–22 рабочих дня) вернёмся с проектом трёх уровней: конфигурация compute, топология сети Fat-Tree, объём и класс СХД, схема стоек с расчётом питания и охлаждения. План монтажа и сквозные приёмочные тесты (NCCL + dataloader + пилотное обучение) — после поставки оборудования, с фиксированным сроком сдачи. Для госзаказа пакет под 44-ФЗ и 223-ФЗ
Тем, что все три уровня сходятся в интеграционных точках — GPUDirect RDMA и Storage, NCCL rail-optimized, checkpoint-политика, сквозной мониторинг. Поштучная закупка не гарантирует, что кластер заработает: сервера приедут, коммутатор через полтора месяца, СХД через два, а собирать вместе будет некому.
8 узлов × 8 GPU × I/O около 500 МБ/с = около 32 ГБ/с общий пиковый. Sustained — 10–20 ГБ/с. Под это уходит all-flash параллельная файловая система с локальным NVMe-кэшем в каждом узле. Без кэша параллельная ФС «горит» под тысячами small reads от dataloader.
70B параметров × 4 байта FP32 = 280 ГБ на реплику весов, со states оптимизатора и градиентами около 1,5 ТБ. На 32 узлах шардированно около 50 ГБ на узел, полный записываемый объём около 1,5 ТБ каждые N шагов. Пик write СХД порядка 50 ГБ/с общий, чтобы checkpoint не тормозил обучение.
+20–40% по dataloader-производительности на мелких файлах (изображения, аудио, короткие токенизированные последовательности). Для больших файлов TFRecord или parquet эффект меньше, там уже CPU справляется. GDS требует поддержки со стороны СХД, поэтому закладываем совместимость на этапе выбора.
Slurm традиционен в HPC: строгая очередь, простое управление GPU-квотами, минимум оверхеда. Kubernetes с NVIDIA GPU Operator в корпоративных ML-платформах: CI/CD, MLOps-конвейеры, единый оркестратор для обучения и инференса. Часто гибрид: Slurm под тяжёлые обучения, Kubernetes под инференс и сервисы.
Базовое правило: собственный кластер 8–32 узлов окупается против облачных GPU при непрерывной загрузке от 60% за 12–24 месяца. CapEx на железо и монтаж + OpEx (питание, ЦОД, инженеры) сравнивают с почасовым облачным прайсом. R&D с рваной нагрузкой — облако дешевле, продуктивная ML-платформа с постоянной загрузкой — свой комплекс.
Заполните форму, и мы проведём бесплатный аудит: проверим серверы, сети и системы безопасности, определим риски и предложим план перехода на отечественное оборудование.