

Модель больше одного узла
Модель не помещается в один узел (даже H200 141 ГБ HBM3e), нужен tensor parallel или pipeline parallel через несколько узлов
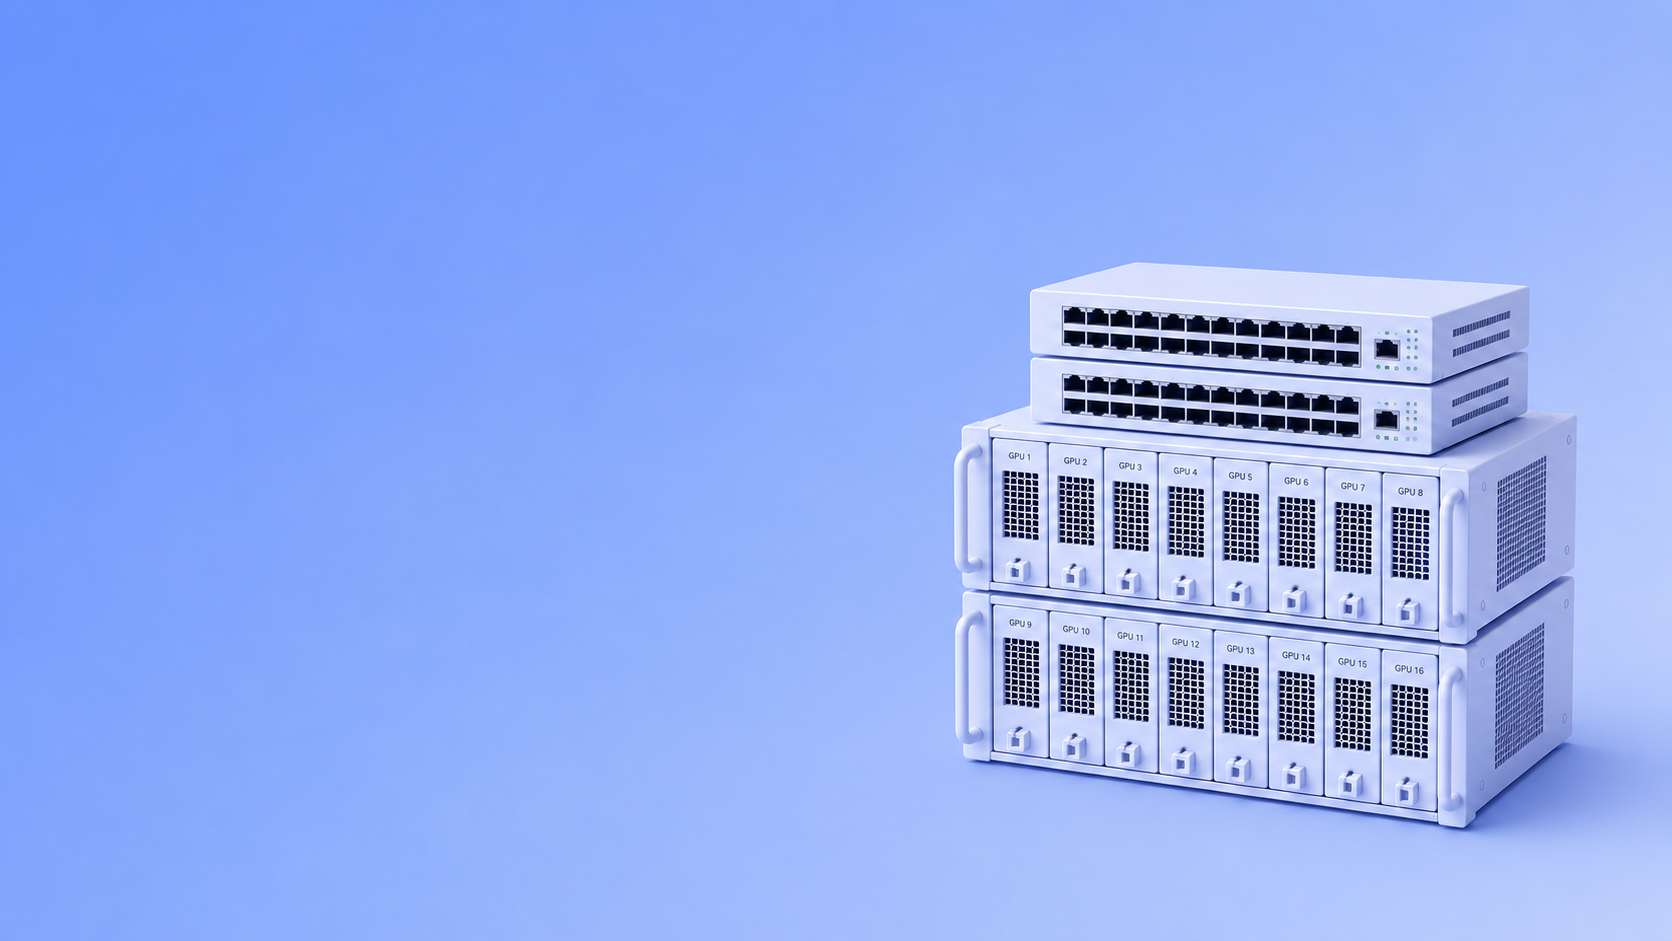
GPU-кластер для обучения нейросетей нужен, когда клиент упирается в границы одного узла: модель не помещается даже в H200 141 ГБ, батч не даёт нужной точности, а эксперимент, который должен занимать день, растягивается на неделю. Собираем связку от 2 до 128 узлов H100/H200/A100 SXM в HGX-платформах, соединённую InfiniBand-фабрикой Fat-Tree с rail-optimized routing под NCCL
 В реестре

Рейтинг компании


Модель больше одного узла
Модель не помещается в один узел (даже H200 141 ГБ HBM3e), нужен tensor parallel или pipeline parallel через несколько узлов
Ускорение R&D
Эксперимент занимает неделю на одном узле — распределив на 8 узлов, ждёте день, для итеративного R&D это критично
Общая СХД
Датасет превышает объём локального NVMe одного узла — нужна общая СХД с параллельной ФС для батчей эпох
Параллельная работа команд
Несколько ML-команд работают параллельно — один узел на всех превращается в очередь
Foundation-модели 70B+ и MoE
Целевая модель — foundation-модель 70B+ или mixture-of-experts (MoE) — один узел физически не тянет
| Подсистема | 1 узел (сервер) | Кластер (2+ узлов) |
|---|---|---|
| GPU-связь | NVLink Switch внутри узла (900 ГБ/с между 8 GPU) | NVLink внутри узла + InfiniBand между узлами (400 Гбит/с NDR) |
| Сеть | 1–2 порта Ethernet для управления | Отдельная InfiniBand-фабрика Fat-Tree + Ethernet для управления |
| Коммутаторы | Не нужны для GPU-трафика | Quantum-2 QM9700 (NDR) или Quantum QM8700 (HDR), leaf + spine |
| Хранение | Локальный NVMe в узле (2–8 ТБ) | Локальный NVMe + общая параллельная ФС (Lustre / GPFS / BeeGFS) |
| Программное | CUDA, драйверы, ML-фреймворк | Плюс NCCL с rail-optimized и MTU 4 КБ, Subnet Manager (OpenSM или UFM), Slurm/Kubernetes, checkpoint-политика |
| Планировщик | Локально запускаешь python train.py | Slurm или Kubernetes с GPU-плагином, очереди, приоритеты, отказоустойчивость |
| Мониторинг | nvidia-smi + журнал | Prometheus + DCGM Exporter + мониторинг фабрики (UFM), сквозные дашборды |
| Питание | 5–12 кВт на стойку | 20–50 кВт на плотную сборку, часто DLC |
| Параметр подбора | На что влияет | Что уточняем у клиента |
|---|---|---|
| Размер обучаемой модели | Выбор GPU (A100 40/80 vs H100 80 vs H200 141 ГБ), число узлов, тип параллелизма | Целевой размер параметров, тип модели (dense vs MoE) |
| Тип распределённого обучения | Требования к NCCL-пропускной, топология фабрики | Data-parallel, model-parallel, pipeline, tensor |
| Число узлов сейчас и через 12–24 мес | Число коммутаторов, топология, запас портов | План роста, бюджет CapEx |
| Datalayout — размер и формат датасета | Класс общей СХД, размер локального NVMe-кэша | Объём датасета, формат (JPEG, TFRecord, parquet) |
| Поколение InfiniBand | HDR 200G (для A100) vs NDR 400G (для H100/H200) | Модель GPU в узле, планы обновления |
| Условия ЦОД | Воздух (12 кВт/стойка) vs DLC (30–50 кВт) | Мощность стойки, готовность к DLC |
| Планировщик задач | Slurm (HPC-style) vs Kubernetes (cloud-native) | Что уже используется, число команд-пользователей |
| Checkpoint-политика | Требования к write-пропускной СХД, частота checkpointов | Стоимость потерянного часа обучения |
| Отказоустойчивость обучения | Дублирование Subnet Manager, hot-swap NVMe, N+N БП | SLA внутренней ML-платформы |

Стартовый кластер: 2–4 узла с 8×A100 SXM или 8×H100 SXM HGX
На что рассчитано: fine-tuning LLM 7B–70B, R&D-команда 5–15 инженеров, тестовая ML-платформа

Продуктивный кластер: 8–32 узла с 8×H100 SXM HGX
На что рассчитано: full fine-tuning LLM 30B–70B, обучение foundation-моделей до 70B, командная ML-платформа с 30+ инженерами, гибрид обучение + периодический инференс

Крупный кластер: 32–128 узлов с 8×H100/H200 SXM HGX
На что рассчитано: pre-training foundation-моделей 70B–1T параметров, отраслевые LLM, крупные R&D-центры банков и корпораций
| Подход | Что параллелится | Нагрузка на InfiniBand | Когда применим |
|---|---|---|---|
| Data-parallel (PyTorch DDP, ZeRO-1) | Батч делится между узлами, модель целиком на каждом | Умеренная (all-reduce градиентов раз в шаг) | Модель влезает в один узел (до 70B на H200) |
| ZeRO-2 / ZeRO-3 | Оптимизатор + градиенты (ZeRO-2) или + веса (ZeRO-3) шардированы | Высокая (all-gather + reduce-scatter каждый шаг) | Модель не влезает в узел, экономим память |
| Tensor-parallel | Матричные операции слоя делятся между GPU (обычно внутри узла через NVLink) | Внутри узла — NVLink Switch, между узлами — очень высокая | Крупные слои трансформера (Megatron-LM), 8 GPU в узле |
| Pipeline-parallel | Слои модели распределены по узлам конвейером | Умеренная (только на границах ступеней) | Очень глубокие модели, компенсация memory-limit |
| 3D-parallel (DP+TP+PP) | Все три оси одновременно | Смешанная, самая сложная в тюнинге | Foundation-модели 70B+ (Megatron-LM + DeepSpeed) |
 Cобранные HGX-платформы, локальный NVMe
 Коммутаторы в топологии Fat-Tree, HCA в каждом узле, кабели
 Общая СХД под датасеты
 Проект питания стойки и проект охлаждения
 Программный стек и планировщик
 Сквозные приёмочные тестыОбучение, постпродажное сопровождение
 Пакет документов под 44-ФЗ или 223-ФЗ при госзаказе


Заявка и обследование: 5–7 дней
задача обучения, целевая модель, объём датасетов, условия ЦОД, планы роста

Расчёт кластера: 10–14 дней
число и модель узлов, поколение InfiniBand и топология Fat-Tree, класс СХД, охлаждение, питание, программный стек

Согласование, договор
по графику клиента

Поставка компонентов: 45–90 дней
HGX-платформы, коммутаторы Quantum, HCA, кабели, СХД
Монтаж и настройка: 7–14 дней
Монтаж в стойки, коммутация питания и InfiniBand-фабрики, подключение DLC при необходимости

Тестирование, сдача, обучение, гарантия и постпродажное сопровождение
3–5 рабочих дней
Инфраструктура в связке
cобираем связку GPU-узлов, сетевой фабрики и СХД в интеграционных точках, а не отдельн

Опыт
опыт с Fat-Tree топологиями на 2–128 узлов, включая rail-optimized NCCL и жидкостное охлаждение DLC
Питание и охлаждение
проектируем питание и охлаждение стойки — не «оборудование придёт, а куда ставить, вы разберётесь»
Вендоры и поставщики
GPU: NVIDIA H100/H200 SXM, A100 SXM. HGX-платформы: Supermicro, Gigabyte, ASUS, Quanta, Foxconn. Коммутаторы и HCA: NVIDIA — Quantum/Quantum-2, ConnectX-6/7. Параллельная ФС: Lustre (open), IBM Spectrum Scale, BeeGFS, VAST, WEKA. Планировщики: Slurm (open), Kubernetes + NVIDIA GPU Operator

Постпродажное сопровождение
обучаем администраторов клиента, даём альтернативу по поколению InfiniBand, 44-ФЗ и 223-ФЗ, пакет документов для закупки
Пришлите задачу обучения (модель, размер параметров, датасет), целевое число узлов сейчас и через 12–24 месяца, условия ЦОД (мощность стойки, готовность к DLC) — по итогам обследования и расчёта кластера (15–21 рабочий день) вернёмся с проектом
Кластер — 2 и более GPU-узлов, соединённых отдельной InfiniBand-фабрикой Fat-Tree. Появляются коммутаторы Quantum, общая СХД с параллельной ФС, планировщик Slurm или Kubernetes, сквозной мониторинг. Один узел работает автономно, кластер живёт как единая распределённая среда обучения.
PyTorch DDP на 8 узлах ускоряет обучение примерно в 6× против одного узла — часть эффекта съедает overhead all-reduce. На 32 узлах при non-blocking Fat-Tree — около 24×. При oversubscription 2:1 масштаб на 32 узла падает до 16–18× — фабрика становится bottleneck.
Каждый GPU в узле идёт в «свой» leaf-коммутатор — снижение контенции в фабрике на 20–40% при плотной NCCL-нагрузке. Заметно на больших коллективах all-reduce в 3D-parallel обучении foundation-моделей.
Slurm традиционен в HPC — строгая очередь, простое управление GPU-квотами, минимум оверхеда. Kubernetes с NVIDIA GPU Operator в корпоративных ML-платформах: CI/CD, MLOps-конвейеры, единый оркестратор. Часто ставим гибрид: Slurm под тяжёлые обучения, Kubernetes под инференс и сервисы.
70B параметров × 4 байта FP32 = 280 ГБ весов, плюс state оптимизатора и градиенты около 840 ГБ. Шардированно на 8 узлах около 140 ГБ на узел, полный записываемый объём около 1,1 ТБ каждые N шагов. СХД под это — параллельная ФС с пиком write 30–50 ГБ/с.
Работаем по 44-ФЗ и 223-ФЗ в части поставки. GPU H100/H200/A100 фактически NVIDIA-only — замещённой альтернативы под обучение LLM в реестре Минпромторга нет. Compute-платформа может быть российской (YADRO, KRAFTWAY) при совместимости с HGX. СХД частично — RAIDIX или YADRO. CUDA/NCCL тоже NVIDIA-only.
Заполните форму, и мы проведём бесплатный аудит: проверим серверы, сети и системы безопасности, определим риски и предложим план перехода на отечественное оборудование.