

Высокая нагрузка
Регулярный поток запросов свыше 1 млн в сутки — облачные API становятся дороже CapEx на свою инфраструктуру за 12–18 месяцев
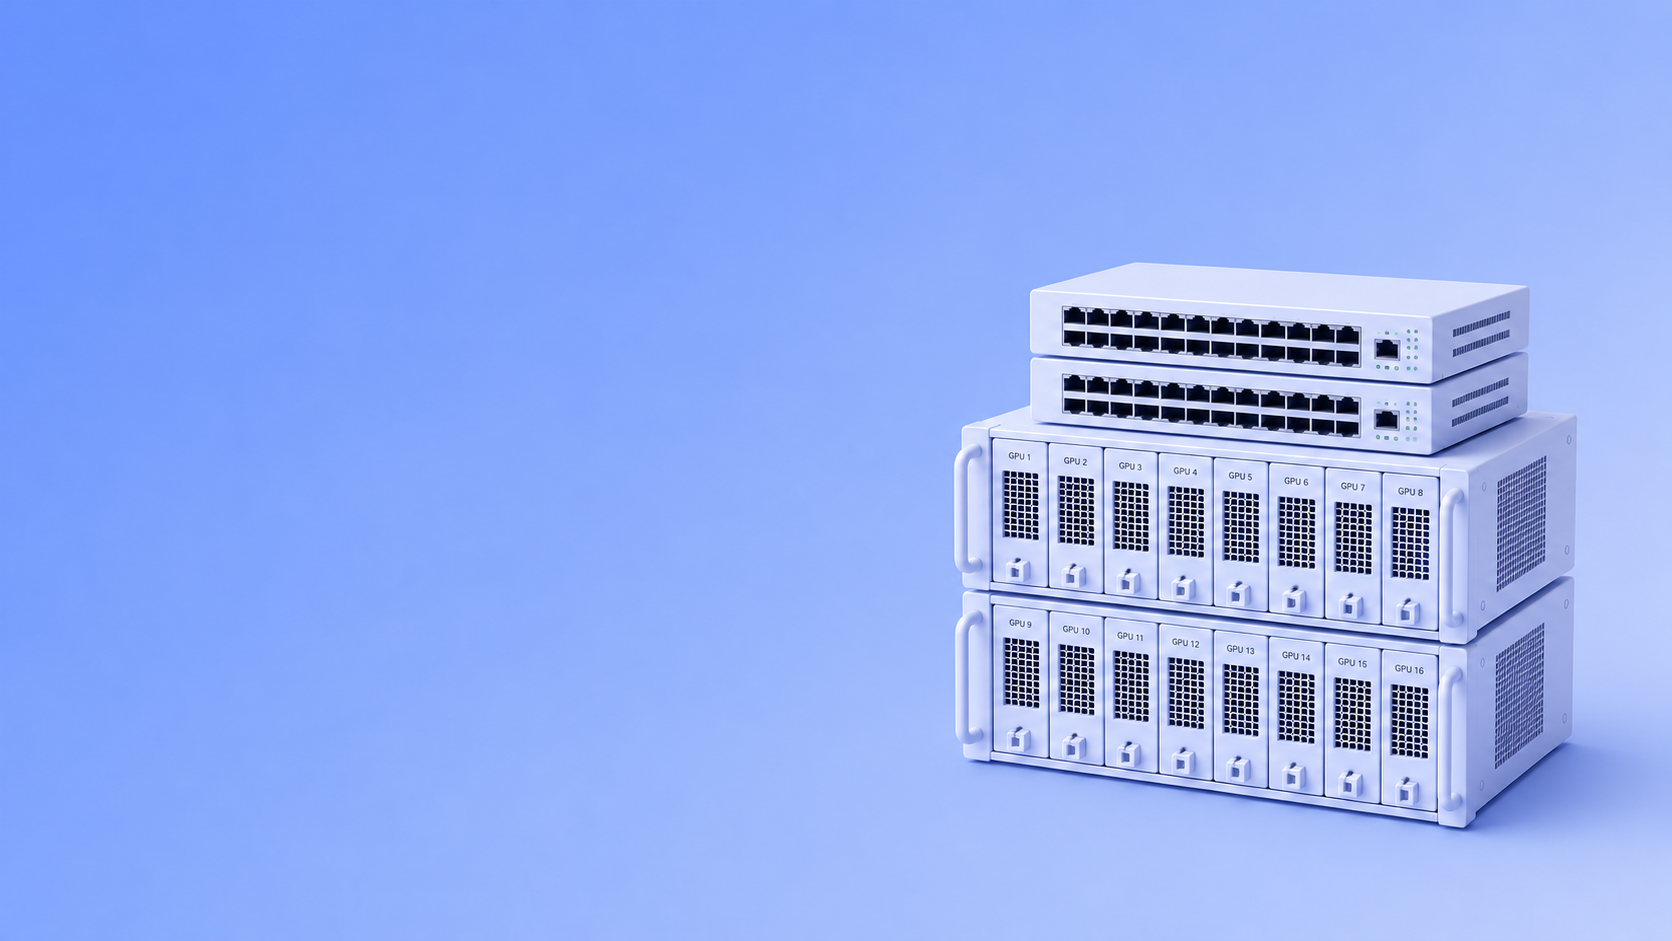
GPU-кластер для inference — связка 2–64+ узлов на L40S, A100, H100 или H200 под production-запуск LLM, CV и RAG-моделей в ЦОД клиента, когда данные не выпускаются в облако, а цена вопроса — стоимость одного запроса, а не время обучения
 В реестре

Рейтинг компании


Высокая нагрузка
Регулярный поток запросов свыше 1 млн в сутки — облачные API становятся дороже CapEx на свою инфраструктуру за 12–18 месяцев
Данные внутри контура
Данные пользователей не выпускаются в облако (персональные, коммерческая тайна, гостайна) — inference строго в контуре заказчика
Собственная модель
Кастомная fine-tuned модель — облачные API «нашей» модели не поддерживают, нужен свой сервер
Низкая задержка и строгий SLA
Строгий SLA по latency (P99 < 200 мс) — облачная задержка через интернет и очередь провайдера не подходит
Мультимодельный inference
Мультимодельный сценарий: 10+ моделей одновременно с MIG-шардированием и общим autoscaling — своё дешевле
| Параметр | Обучение (GPU-кластер для обучения) | Inference (эта страница) |
|---|---|---|
| Ключевая метрика | Время обучения, NCCL-пропускная | Latency P99, throughput req/sec, cost per query |
| Целевой GPU | H100/H200 SXM (HBM + NVLink Switch) | L40S (48 ГБ, 350 Вт) — под $/query, A100/H100 для крупных моделей |
| Форм-фактор узла | 8-GPU HGX SXM (высокая плотность) | 2×L40S PCIe (2U) или 4×A100/H100 PCIe (4U) |
| Межузловая сеть | InfiniBand NDR 400G (rail-optimized NCCL) | 25/100 GbE Ethernet чаще всего, InfiniBand не обязателен |
| Внутриузловая связь GPU | NVLink Switch критичен (all-reduce) | PCIe Gen5 хватает, NVLink только под tensor-parallel крупной модели |
| Хранение | Параллельная ФС для датасетов (Lustre/GPFS) | Локальный NVMe для кэша модели (2–4 ТБ на узел) |
| Питание стойки | 20–50 кВт (плотные HGX) | 5–12 кВт (обычно воздух хватает) |
| Планировщик | Slurm или Kubernetes с device-plugin | Kubernetes с NVIDIA GPU Operator и autoscaling обязательно |
| Программный стек | PyTorch DDP, DeepSpeed, Megatron-LM, NCCL | vLLM, TensorRT-LLM, NVIDIA Triton, TGI, ONNX Runtime |
| Multi-tenancy | Обычно нет — обучение занимает узел целиком | Часто через MIG (H100 — 7 инстансов) |
| Балансировка нагрузки | Не требуется — задача одна | Обязательно load balancer + очередь запросов |
| Сроки поставки | 90–150+ рабочих дней | 60–100 рабочих дней (проще конфигурация) |
| GPU | HBM/память | TDP | Форм-фактор | На что подходит |
|---|---|---|---|---|
| NVIDIA L4 (24 ГБ) | 24 ГБ GDDR6 | 72 Вт | PCIe HH-LP (низкопрофильный) | CV-модели, embedding, лёгкий LLM ≤ 7B, edge-inference |
| NVIDIA L40S (48 ГБ) | 48 ГБ GDDR6 | 350 Вт | PCIe 2-слот | Рабочая лошадка inference LLM 7B–13B, диффузия, TTS/STT, RAG-embedding |
| NVIDIA A100 40 ГБ | 40 ГБ HBM2e | 300–400 Вт | PCIe / SXM | LLM 13B–34B, mixed inference с фон-обучением |
| NVIDIA A100 80 ГБ | 80 ГБ HBM2e | 300–400 Вт | PCIe / SXM | LLM 34B–70B (FP16), длинный контекст embedding |
| NVIDIA H100 80 ГБ | 80 ГБ HBM3 | 350–700 Вт | PCIe / SXM | LLM 70B, MoE, FP8-inference через TensorRT-LLM |
| NVIDIA H200 141 ГБ | 141 ГБ HBM3e | 700 Вт | SXM | Крупные LLM 70B+ с длинным контекстом (32K+ токенов), RAG с большим окном |
| Метрика | Что означает | Куда влияет |
|---|---|---|
| Latency P50 / P95 / P99 | Задержка одного запроса в 50 / 95 / 99% случаев | SLA конечного пользователя, выбор batch size, continuous batching |
| Time-to-first-token (TTFT) | Задержка первого токена в LLM-ответе | Пользовательское восприятие «отзывчивости» интерфейса |
| Time-per-output-token (TPOT) | Задержка каждого следующего токена в LLM-стриме | Пропускная скорость чтения ответа пользователем |
| Throughput (req/sec) | Число обработанных запросов в секунду на узел | Число узлов в кластере, autoscaling |
| GPU utilization % | Загрузка GPU по вычислениям | Cost per query — простой равен перерасходу |
| KV-cache footprint | Объём HBM под key-value кэш LLM (растёт с длиной контекста) | Максимальное число параллельных сессий |
| Cost per 1M requests | Итоговая стоимость 1 миллиона запросов | Ключевая экономическая метрика проекта |
| Параметр подбора | На что влияет | Что уточняем у клиента |
|---|---|---|
| Размер модели и формат весов | GPU и HBM, квантизация (FP16 / FP8 / INT8 / INT4) | Параметры модели, поддерживает ли она FP8/INT8-квант |
| Целевой SLA по latency (P99) | Максимальный batch size, требования к TTFT и TPOT | SLA пользователя, строгость 100 мс vs 2 сек |
| Целевой QPS | Число inference-узлов, autoscaling-политика | Пиковая нагрузка, суточный профиль |
| Длина контекста LLM (input tokens) | KV-cache footprint в HBM, число параллельных сессий | Максимальный context window |
| Multi-tenancy | MIG-шардирование, изоляция моделей | Число моделей, требования к изоляции |
| Тип задачи (LLM / CV / embedding / TTS) | Inference-framework (vLLM / TensorRT / Triton / TGI) | Стек, который уже используется |
| Data-путь: где хранятся модели | Локальный NVMe 2–4 ТБ, CI/CD-загрузка новых версий | Частота обновления моделей, объём модели |
| Условия ЦОД | Мощность стойки, тип охлаждения | Обычно для inference хватает воздуха |
| Планы масштабирования | Kubernetes-autoscaling, свободные слоты в стойках | План роста, пиковые события |

Стартовый inference-кластер: 2–4 узла с 2×L40S PCIe (48 ГБ)
На что рассчитано: inference LLM 7B–13B (Llama-3, Mistral, Qwen), диффузионные модели, embedding для RAG, TTS/STT. Пиковая нагрузка до 100 req/sec

Продуктивный inference-кластер: 4–16 узлов с 4×A100 80 ГБ PCIe или 2×H100 SXM
На что рассчитано: продуктивный inference LLM 34B–70B, MoE, RAG с длинным контекстом, мультимодельность 5–10 моделей одновременно. Пиковая нагрузка до 5 000 req/sec

Крупный inference-кластер: 16–64+ узлов с 8×H100 SXM HGX или 4×H200 SXM
На что рассчитано: pre-training foundation-моделей 70B–1T параметров, отраслевые LLM, крупные R&D-центры банков и корпораций
 Inference-узлы: собранные серверы, локальный NVMe
 Сеть: Ethernet 25/100 GbE, опционально InfiniBand NDR
 Load balancer перед inference-узлами
 Kubernetes-платформа с NVIDIA GPU Operator
 Проект питания и охлаждения стойки
 Приёмочные тестыОбучение, постпродажное сопровождение
 Пакет документов под 44-ФЗ или 223-ФЗ при госзаказе


Заявка и уточнение: 3–5 дней
какие модели, целевой QPS, SLA по latency, планы роста

Расчёт кластера: 7–10 дней
выбор GPU (L40S / A100 / H100), число узлов, inference-framework, autoscaling-политика, сеть, СХД

Согласование, договор
по графику клиента

Поставка компонентов: 30–90 дней
серверы с GPU (L40S — 30–60 дней, H100 — 45–90 дней), сетевое оборудование
Монтаж и настройка: 3–5 дней
Монтаж в стойки, мониторинг, пилотный запуск с референсной моделью

Сдача, обучение, гарантия и постпродажное сопровождение
3–5 рабочих дней
Подбор GPU по стоимости запроса
считаем конфигурацию по стоимости запроса, а не по «топовым GPU» — выбор L40S / A100 / H100 под конкретный workload

Inference под ключ
опыт с vLLM, TensorRT-LLM, Triton, TGI — не «сервер поставили и уходим», а работающий inference-сервис
Ghjdthrf SLA
отдаём после нагрузочного теста с достижением SLA (P99), а не после включения питани
Вендоры и поставщики
GPU: NVIDIA L4/L40S/A100/H100/H200. Серверы: Supermicro, Gigabyte, Dell, HPE, Quanta. CPU: Intel Xeon Sapphire/Emerald Rapids, AMD EPYC Genoa. Сеть: Cisco, Arista, NVIDIA (Ethernet), NVIDIA Quantum-2 (InfiniBand). Inference-серверы: vLLM, NVIDIA Triton, TensorRT-LLM, HuggingFace TGI

Работа под ТЗ
работаем под ТЗ и production-workload, 44-ФЗ и 223-ФЗ, пакет документов для закупки
Пришлите модель (или их список), целевой QPS и SLA по latency (P99), длину контекста LLM и планы роста — по итогам обследования и расчёта кластера (10–15 рабочих дней) вернёмся с проектом: выбор GPU (L40S / A100 / H100 / H200), число узлов, inference-framework, Kubernetes-autoscaling с MIG
L40S 48 ГБ 350 Вт против H100 80 ГБ 700 Вт. Для LLM 7B–13B L40S даёт примерно в 2× меньше $/запрос при сопоставимой latency: дешевле, потребляет вдвое меньше, а KV-cache 48 ГБ хватает под рабочие сессии. H100 оправдан для 70B+ и MoE, где нужен HBM3 и FP8 через TensorRT-LLM.
Примерно в 2× throughput против FP16 без заметной потери качества для большинства LLM inference. Работает на H100/H200 (Transformer Engine поддерживает FP8 нативно). Требует конвертации модели под TensorRT-LLM — часть пусконаладки на нашей стороне.
Через пилот на референсной модели. Пример: если один узел L40S тянет 30 req/sec на LLM-13B при P99 менее 500 мс, то на 3 000 req/sec надо 100 узлов + запас на пик 20–30%. Точная цифра получается после нагрузочного теста — зависит от длины контекста, batch policy и квантизации.
Multi-Instance GPU шардирует одну H100 на 7 виртуальных GPU с изолированной памятью. Нужен при мультимодельности (5–10 моделей одновременно) и изоляции команд-tenants. Одна физическая H100 обслуживает 7 моделей параллельно.
Нет. Для standalone-inference хватает 25/100 GbE — межузловой трафик минимален (load balancer раскидывает запросы, модель отвечает локально). InfiniBand нужен только при tensor-parallel крупной модели (Llama-3-405B, MoE), там NCCL между узлами становится узким местом.
60–100 рабочих дней от заявки до сдачи в зависимости от масштаба и модели GPU. L40S — 30–60 дней поставки, H100 — 45–90. Плюс настройка Kubernetes с inference-сервером, пилот и нагрузочный тест до достижения SLA.
Заполните форму, и мы проведём бесплатный аудит: проверим серверы, сети и системы безопасности, определим риски и предложим план перехода на отечественное оборудование.