

Fine-tuning LLM
Fine-tuning корпоративных LLM (7B–70B) на внутренних данных, которые нельзя выносить в облако
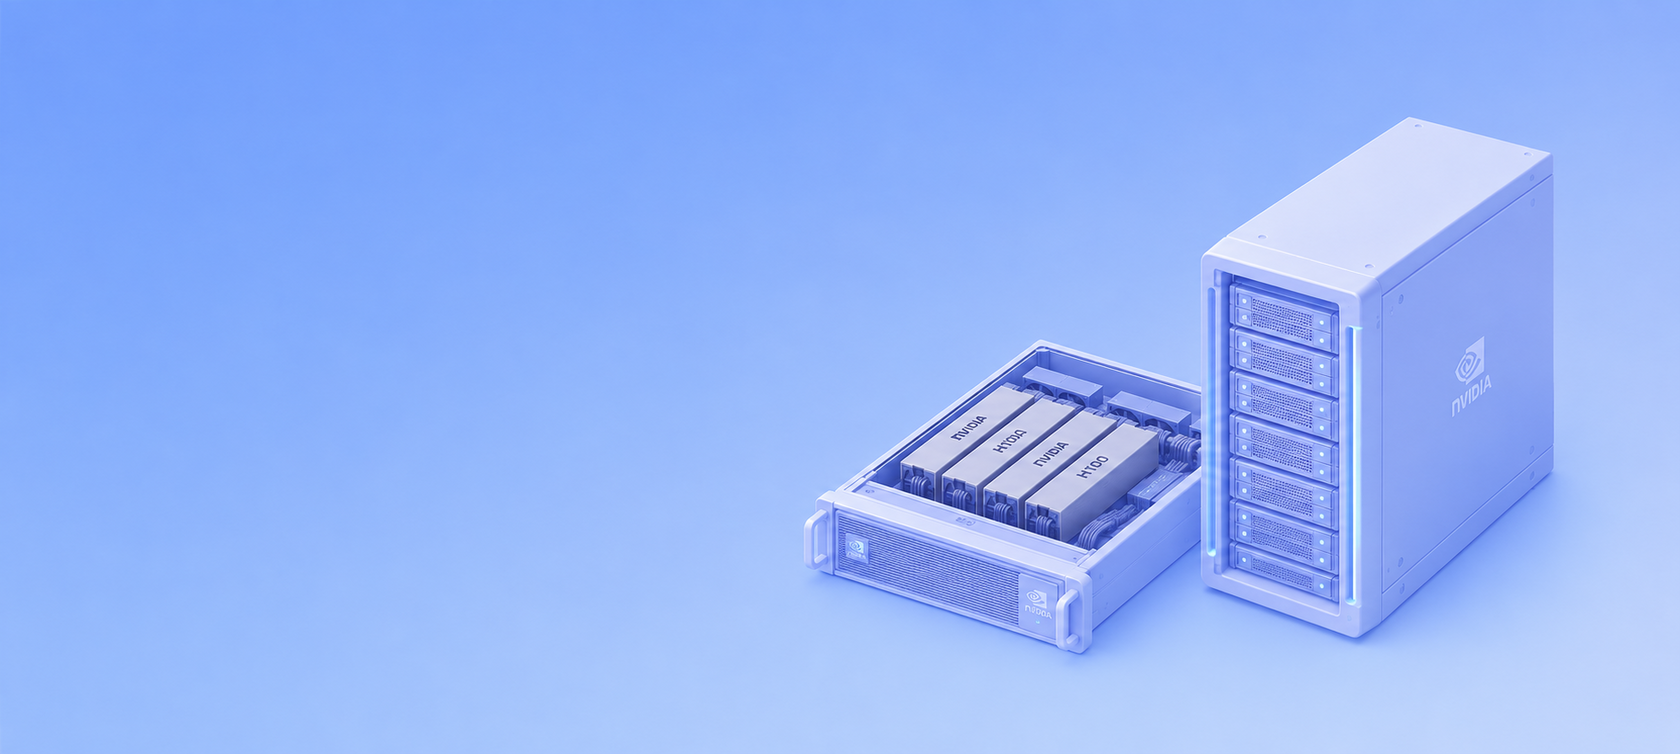
Сервер H100 или H200 под обучение ИИ-моделей у себя — задача команд, уходящих от облачных GPU или добавляющих свои мощности. Собираем узел под конкретный workload: 4 или 8 GPU H100/H200 SXM с NVLink Switch, 1–2 ТБ DDR5, NVMe-кэш под датасеты, ConnectX-7 под кластерную обвязку, питание стойки 8–14 кВт с воздухом или до 30–50 кВт с жидкостным DLC, готовый программный стек CUDA 12.x, cuDNN, NCCL и TensorRT-LLM. Собираем, прошиваем и отдаём после приёмочных NCCL-бенчмарков и референсного прогона обучения на вашей модели
 В реестре

Рейтинг компании


Fine-tuning LLM
Fine-tuning корпоративных LLM (7B–70B) на внутренних данных, которые нельзя выносить в облако
Pre-training моделей
Pre-training крупных foundation-моделей — при непрерывной загрузке окупаемость собственной инфраструктуры выше облачной
Экономика против облака
R&D-команда с постоянной нагрузкой: облачные счета уже превышают CapEx на собственный узел за 12–18 месяцев
Защищённый контур
Требования по данным (персональные данные, гостайна, коммерческая тайна) — обучение только в собственном контуре
Масштабирование в кластер
Первый узел под масштабирование в кластер, далее к нему подключается сетевая фабрика InfiniBand для GPU-кластера с ещё N узлов
| Параметр | H100 SXM5 80 ГБ | H100 PCIe 80 ГБ | H200 SXM5 141 ГБ |
|---|---|---|---|
| Тип памяти | HBM3 | HBM3 | HBM3e |
| Объём памяти | 80 ГБ | 80 ГБ | 141 ГБ |
| Пропускная память | 3,35 ТБ/с | 2 ТБ/с | 4,8 ТБ/с |
| TDP | 700 Вт | 350 Вт | 700 Вт |
| NVLink Gen4 | 900 ГБ/с (HGX-платформа, 8 GPU) | 600 ГБ/с попарно (мост) | 900 ГБ/с (HGX, 8 GPU) |
| FP8 Transformer Engine | Да | Да | Да |
| MIG (шардирование GPU) | До 7 инстансов | До 7 инстансов | До 7 инстансов |
| Оптимальная задача | Fine-tuning 7B–70B, обучение CV, mixed | Одиночные узлы, инференс, малые команды | Pre-training 70B+, LLM с длинным контекстом, RAG-инференс |
| Форм-фактор системы | 8-GPU HGX (5U–6U), 4-GPU (4U) | PCIe 4U с 4–8 картами через bridge | 8-GPU HGX (5U–6U) |
| Параметр | 4×H100 PCIe | 8×H100 SXM HGX | 8×H200 SXM HGX |
|---|---|---|---|
| Форм-фактор | 4U универсальный | 5U–6U специализированный | 5U–6U специализированный |
| Связь между GPU | PCIe Gen5 x16 (128 ГБ/с) + опц. NVLink bridge попарно | NVLink Switch Gen4 (900 ГБ/с между любыми парами) | NVLink Switch Gen4 (900 ГБ/с) |
| Всего памяти в узле | 320 ГБ HBM3 | 640 ГБ HBM3 | 1128 ГБ HBM3e |
| Питание узла | 3–4 кВт | 10–12 кВт | 10–12 кВт |
| Охлаждение | Воздух | Воздух или жидкость | Воздух или жидкость |
| Когда выбирают | R&D, инференс, малые команды, отдельные проекты | Продуктивное обучение с высокой межGPU-нагрузкой (NCCL all-reduce) | Обучение крупных моделей с длинным контекстом |

Стартовый узел для fine-tuning: 4×H100 PCIe 80 ГБ
На что рассчитано: fine-tuning LLM 7B–13B с LoRA/QLoRA, обучение CV, R&D-команда до 5 человек, тестовая ML-платформа

Продуктивный узел обучения: 8×H100 SXM HGX 640 ГБ
На что рассчитано: full fine-tuning LLM 30B–70B, обучение foundation-моделей до 70B, продуктивная ML-платформа с 10+ инженерами, первый узел кластера с готовностью к расширению до 8–16 узлов

Узел под крупные LLM: 8×H200 SXM HGX 1128 ГБ HBM3e
На что рассчитано: pre-training крупных LLM с длинным контекстом (Llama-70B+, MoE-модели, RAG-инференс), где 80 ГБ HBM3 требует шардирования между узлами, а 141 ГБ HBM3e даёт весь workload внутри одного узла
| Сценарий | Мощность стойки | Охлаждение | Комментарий |
|---|---|---|---|
| 1 узел 4×H100 PCIe | 5–7 кВт | Воздух через фронт стойки | Работает в типовом ЦОД с прецизионным кондиционером |
| 1 узел 8×H100 SXM HGX | 10–12 кВт | Воздух с горячим коридором + сплит-ряд | Верхний предел воздушного охлаждения |
| 2 узла 8×H100 SXM в одной стойке | 20–24 кВт | Жидкостное DLC обязательно | Воздух не тянет, нужен CDU и подготовка стойки |
| Стойка 4×H100 SXM (4 узла) | 40–48 кВт | DLC с закрытым контуром | ЦОД должен иметь холодный контур, чиллер или free-cooling |
| Стойка H200 плотная сборка | 30–50 кВт | DLC + резерв по чиллеру | Требует проекта под ключ |
 Сетевые адаптеры, БП с резервированием
 HGX-платформа с NVLink Switch или PCIe-шасси
 Установленная ОС, CUDA 12.x, cuDNN, NCCL, драйверы NVIDIA
 Готовый образ под запрос
 Расчёт PDU, схема подключения, резервирование
 Проектирование охлаждения: воздух или жидкостьКабельная инфраструктура: питание, сетевая обвязка
 Обучение, мониторинг, разбор инцидентов, консультации


Заявка и обследование: 3–5 дней
задача обучения, размер модели, условия ЦОД, планы роста

Расчёт конфигурации, спецификация: 7–10 дней
H100 vs H200, PCIe vs SXM, число GPU, CPU, RAM, NVMe, охлаждение, питание

Согласование, договор
по графику клиента

Поставка компонентов и HGX-платформы: 40–70 дней
специфичное оборудование, H200 — до 90 дней
Сборка и монтаж, настройка: 5–10 дней
сборка узла, прошивка, установка ОС и стека CUDA/NCCL, конфигурация под workload, подключение к питанию и сети

Сдача, обучение персонала, гарантия и постпродажное сопровождение
2–3 рабочих дня
Настройка узла под обучение
собираем и настраиваем узел под задачу обучения, а не отдаём голую железку с драйвером

Опыт
опыт с HGX-платформами H100 и H200, включая жидкостное охлаждение DLC
Проверка под нагрузкой
отдаём после приёмочных NCCL-бенчмарков и референсного прогона обучения, а не после включения питания
Вендоры и поставщики
GPU: NVIDIA H100 SXM/PCIe, H200 SXM. HGX-платформы: Supermicro, Gigabyte, ASUS, Quanta, Foxconn. CPU: Intel Xeon Sapphire/Emerald Rapids, AMD EPYC Genoa/Bergamo. Память DDR5 ECC: Samsung, Micron, SK Hynix. NVMe: Samsung, Micron, Kioxia. Сетевые адаптеры: NVIDIA ConnectX-6/7

Постпродажное сопровождение
помогаем администратору кластера с обновлениями драйверов CUDA, прошивок BMC и добавлением новых узлов по мере роста
Пришлите задачу обучения (модель, размер, датасет), условия ЦОД и планы роста — по итогам заявки и расчёта (8–12 рабочих дней) вернёмся с конфигурацией узла и планом питания и охлаждения стойки. Приёмочные NCCL-тесты и точный срок поставки после согласования и заказа HGX-платформы (для H100 — 60–90 рабочих дней от заявки до сдачи, для H200 — до 110). Пакет документов под 44-ФЗ при госзаказе
Llama-70B в FP16 требует ~140 ГБ на веса. В H100 (80 ГБ) модель не помещается на один GPU и требует model-parallel + ZeRO-3 с накладными расходами на межGPU-обмен. В H200 (141 ГБ) веса помещаются на один GPU, обучение идёт без шардирования и быстрее по wall-clock. Для 30B–65B разница нивелируется.
Всё решает NCCL all-reduce. В SXM/HGX — NVLink Switch с 900 ГБ/с между парами. Через PCIe Gen5 x16 — около 128 ГБ/с, на порядок медленнее. Для обучения LLM с частой синхронизацией градиентов оправдан SXM, для fine-tuning LoRA и одиночного инференса — PCIe.
2 × 11 кВт ≈ 22 кВт на стойку. Воздушное охлаждение с горячим коридором уже не тянет: закладываем жидкостное DLC либо разносим узлы по разным стойкам. При плотности 40+ кВт (4 узла) DLC — единственный рабочий вариант, ЦОД должен иметь холодный контур и чиллер.
Да, если сразу поставить ConnectX-7 NDR 400G. При добавлении новых узлов подключаем их к InfiniBand-фабрике на Quantum-2 QM9700, настраиваем rail-optimized routing и NCCL — распределённое обучение без пересборки первого узла.
Работаем по 44-ФЗ и 223-ФЗ в части поставки. GPU H100/H200 фактически NVIDIA-only, полностью замещённой альтернативы под обучение LLM в реестре Минпромторга нет. Compute-платформа может быть на российской при совместимости с HGX. CUDA, cuDNN, NCCL тоже NVIDIA-only.
Базовое правило: собственный 8×H100 SXM окупается против облака при непрерывной загрузке 60%+ за 12–18 месяцев (CapEx + питание + место в ЦОД vs почасовой прайс облака). R&D с рваной нагрузкой — облако дешевле, продуктивная ML-платформа с постоянной загрузкой — свой узел.
Заполните форму, и мы проведём бесплатный аудит: проверим серверы, сети и системы безопасности, определим риски и предложим план перехода на отечественное оборудование.