

Топология fat tree infiniband нужна там, где несколько GPU-серверов одновременно обмениваются большими массивами данных. Обычное дерево с одним узким верхним каналом для такой нагрузки не подходит: трафик от разных ветвей сходится и начинает конкурировать. Fat-Tree расширяет сеть к верхним уровням и создает несколько равноценных путей между узлами. При достаточном числе аплинков фабрика становится неблокирующей, поэтому коллективные операции используют доступную полосу без постоянной очереди на одном центральном соединении.
Что такое топология Fat-Tree и зачем она нужна GPU-кластеру
Топология Fat-Tree строится как многоуровневая сеть Клоза. Серверы подключаются к leaf-коммутаторам, а те соединяются со spine-уровнем. В отличие от классического дерева, пропускная способность не уменьшается по мере движения к корню. Верхняя часть получает достаточно параллельных каналов, чтобы обслуживать обмен между разными ветвями.
Для GPU-кластера это важно из-за характера нагрузки. При распределенном обучении каждый узел не только принимает запросы от одного клиента. Он синхронизирует результаты с другими участниками через коллективные операции NCCL, поэтому трафик идет сразу между множеством GPU.
GPU-серверы могут занимать 2U-8U и содержать 8-10 видеокарт. Внутри узла ускорители связаны через NVLink или NVSwitch. Между узлами данные идут через InfiniBand-адаптеры с поддержкой RDMA — это исключает лишнее копирование данных через CPU и снижает задержку синхронизации. Если верхний уровень сети имеет меньшую суммарную полосу, мощность NVIDIA H100 или A100 используется не полностью. Для некоторых задач применяют RTX 6000 Ada, но требования к топологии определяет профиль обмена, а не только тип ускорителя. Для высоконагруженных кластеров применяют платформы класса HGX/DGX с настройкой коммутации с ультранизкой задержкой.
Fat-Tree не ускоряет вычисления внутри GPU. Она создает сетевые условия, при которых разные пары узлов могут передавать данные параллельно. Поэтому топологию проектируют после оценки трафика и до выбора окончательного числа портов.
Принцип неблокирующей коммутации: как Fat-Tree убирает узкие места
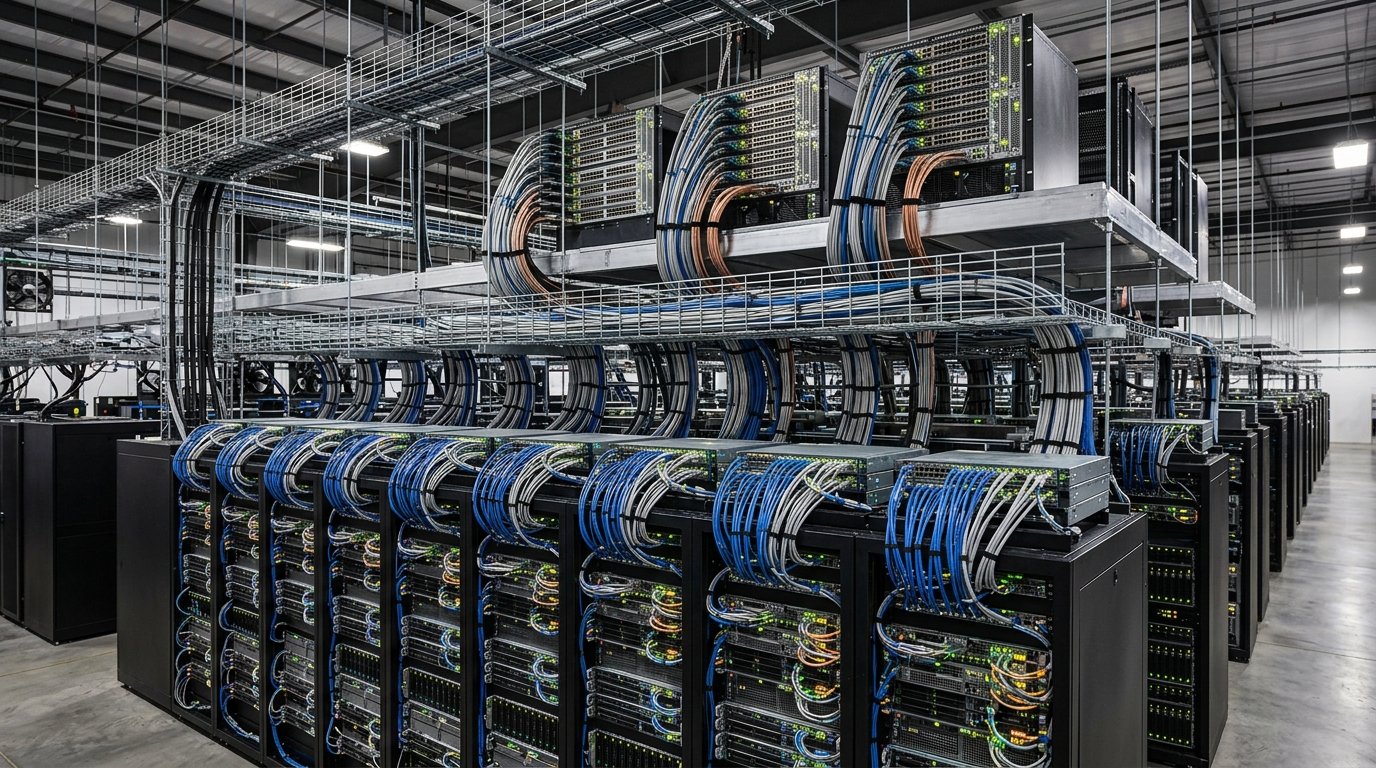
Неблокирующая коммутация означает, что сеть может обслужить одновременные передачи без внутреннего дефицита полосы. Для leaf-коммутатора это требует сопоставить суммарную скорость портов к серверам и суммарную скорость аплинков к spine. Если вниз подключено восемь каналов по 400 Гбит/с, а вверх доступны только два таких канала, все серверы не смогут одновременно передавать на полной скорости в другие ветви.
В полностью неблокирующей схеме отношение полосы вниз к полосе вверх равно 1:1. Каждый бит, который может войти в leaf со стороны серверов, имеет доступную емкость для выхода к spine. Такая фабрика дороже по числу портов и кабелей, но дает предсказуемое поведение при all-to-all трафике.
Если отношение равно 2:1, сеть имеет двукратную переподписку. Это не означает, что каждый поток всегда получает половину скорости. Ограничение проявляется, когда все нисходящие соединения одновременно используют аплинки. Для задач с локальным обменом переподписка может быть приемлемой. Для синхронизации GPU она увеличивает время коллективной операции.
Общее число портов ничего не говорит о неблокируемости, пока неизвестно, сколько разъемов отдано серверам и сколько — межкоммутаторным связям.
Уровни leaf и spine: как строится дерево коммутации
Leaf-уровень находится ближе всего к вычислительным узлам. К нему подключаются InfiniBand-адаптеры серверов. Каждый leaf обслуживает ограниченную группу портов, обычно соответствующую стойке или части ряда. Такое размещение сокращает длину кабелей к серверам и упрощает локальную диагностику.
Spine-уровень объединяет leaf-коммутаторы. Сервер с одного leaf достигает сервера на другом через один spine-коммутатор — это фиксированное число хопов, которое не зависит от того, какие именно узлы обмениваются данными. Несколько spine-коммутаторов создают параллельные пути. Адаптивная маршрутизация может распределять трафик между ними, если часть направлений загружена сильнее.
Полносвязное подключение между уровнями означает, что каждый leaf соединен с каждым spine. Коммутаторы для построения InfiniBand-фабрики выбирают с учетом этой математики: число аплинков зависит от требуемой полосы. Если leaf имеет 16 нисходящих портов и нужна схема 1:1, суммарная скорость аплинков должна соответствовать этим 16 каналам. Это можно получить несколькими физическими портами большей скорости или равным числом односкоростных соединений.
При расширении добавляют leaf для новых серверов. Если spine-уровень имеет свободные порты и достаточную коммутационную емкость, существующие узлы не приходится переключать. Поэтому запас на spine часто ценнее свободных разъемов одного leaf: он определяет предел роста всей фабрики.
Кабельный план между уровнями оформляют отдельно. Короткие соединения в стойке могут выполняться медными сборками. Для удаленных стоек применяют оптические трассы. Нельзя считать аплинк абстрактной линией на схеме: каждый путь требует совместимых портов и физического кабеля.
Rail-optimized дизайн: один InfiniBand-адаптер на GPU
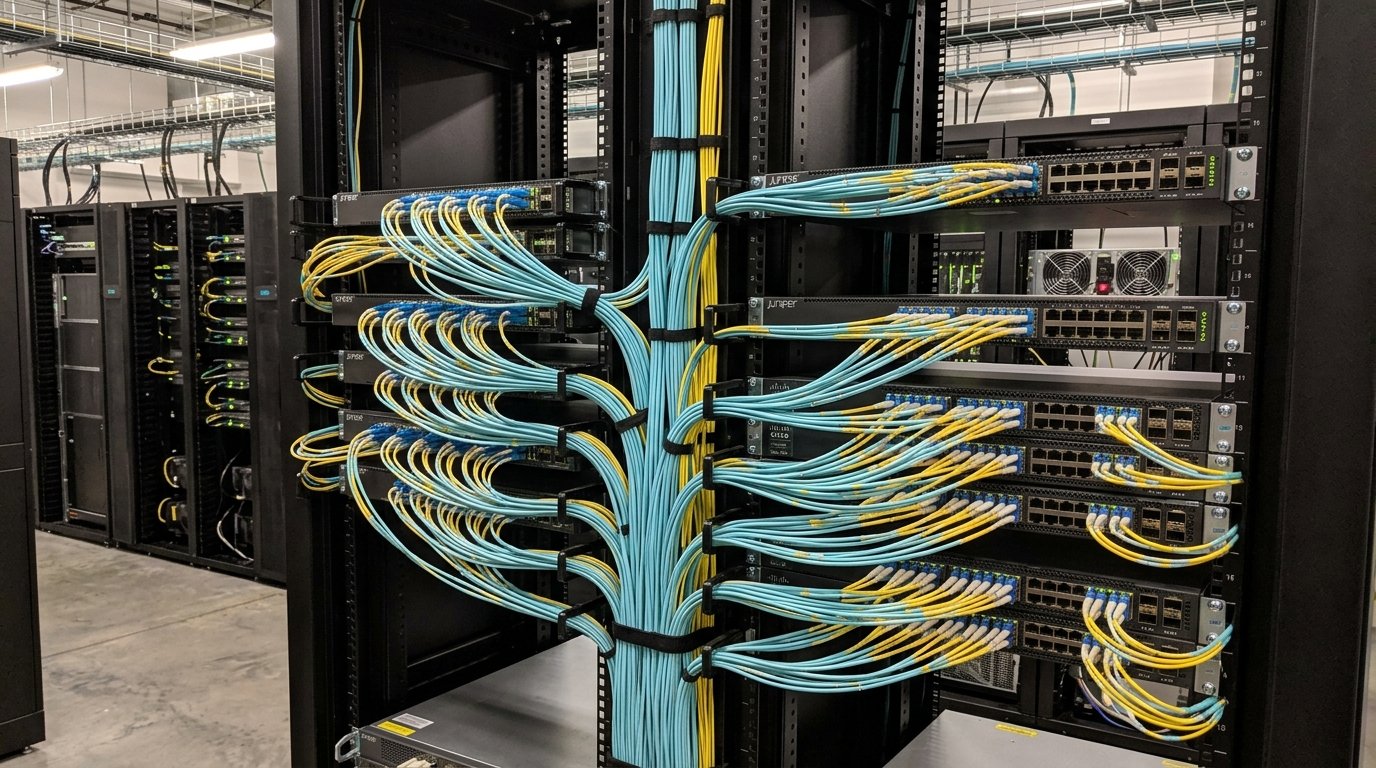
Rail-optimized дизайн дополняет Fat-Tree на уровне подключения серверов. В многокарточном узле каждому GPU соответствует отдельный InfiniBand-адаптер или независимый сетевой путь. Одноименные позиции ускорителей на разных серверах образуют параллельные рельсы.
В топологии Fat-Tree рельсы можно распределить по разным leaf-коммутаторам. Это снижает вероятность того, что неисправность одного устройства затронет все пути узла. Однако распределение должно оставаться симметричным: GPU с одинаковой ролью должны видеть сопоставимое число переходов и одинаковую скорость порта.
Подробная механика связывания GPU относится к отдельной задаче. Для расчета топологии важно следствие: сервер на восемь ускорителей может занимать восемь нисходящих портов, а не один. Если это не учесть, leaf-уровень окажется заполнен в несколько раз быстрее ожидаемого.
DAC и breakout-кабели для подключения к leaf-коммутаторам позволяют организовать короткие трассы и разбиение поддерживаемых портов. Breakout применяют только при подтвержденной совместимости режимов. Он меняет число физических соединений, но не создает дополнительную коммутационную емкость внутри устройства.
Почему трафик all-to-all при обучении моделей требует именно Fat-Tree
В клиент-серверной сети большинство потоков направлено к ограниченному числу сервисов. В распределенном обучении картина другая: каждый ранг NCCL участвует в коллективной операции. При all-reduce данные агрегируются между всеми участниками, а итог возвращается каждому. Даже если алгоритм использует кольцо или дерево, сеть переносит интенсивный межузловой трафик.
Если GPU одной стойки общаются только локально, leaf справляется без аплинков. Но обучение редко сохраняет такое разделение на каждом шаге. Параллелизм данных и модели создает связи между группами ускорителей, размещенными на разных серверах. Чем равномернее распределены потоки, тем важнее полоса spine-уровня.
NCCL выбирает маршруты с учетом доступной топологии, но библиотека не может создать физическую емкость, которой нет. При переподписке операции завершаются со скоростью загруженного участка. Остальные GPU ждут медленную ветвь, поэтому увеличение числа узлов дает все меньший прирост.
Инфраструктура для обучения нейросетей должна оцениваться по завершению реальных коллективных операций, а не только по одиночному тесту порта. Полезно измерять all-reduce на нескольких размерах сообщений и сравнивать результат при добавлении leaf-коммутаторов. Такой тест показывает, сохраняется ли масштабирование фабрики.
Как рассчитывается коэффициент переподписки портов в Fat-Tree
Коэффициент переподписки рассчитывается как отношение суммарной нисходящей полосы к суммарной восходящей полосе leaf-коммутатора:
Oversubscription = полоса downlink / полоса uplink.
Предположим, к leaf подключено 16 серверных портов NDR по 400 Гбит/с. Суммарная полоса вниз составляет 6,4 Тбит/с. Если вверх установлено 16 равных каналов, отношение равно 1:1. Если аплинков восемь, полоса вверх составляет 3,2 Тбит/с, а коэффициент — 2:1.
При смешении скоростей считают не количество портов, а гигабиты в секунду. Четыре аплинка по 400 Гбит/с равны восьми каналам по 200 Гбит/с по номинальной полосе. При этом нужно учитывать поддерживаемые режимы и фактическую коммутационную емкость устройства.
Ниже — сводная таблица для leaf с 24 нисходящими портами: как меняется коэффициент переподписки при разном числе аплинков той же скорости.
Коэффициент переподписки в Fat-Tree
| Downlink-портов (к серверам) | Uplink-портов (к spine) | Коэффициент переподписки | Когда применяют |
|---|---|---|---|
| 24 | 24 | 1:1 | Плотное распределенное обучение, all-to-all трафик |
| 24 | 12 | 2:1 | Смешанная нагрузка с частичным локальным обменом |
| 24 | 8 | 3:1 | Инференс с независимыми репликами, малый межузловой обмен |
Расчет выполняют для каждого leaf. Затем проверяют spine-уровень: он должен иметь достаточное число портов для всех подключений и не создавать новый узкий участок. Если к одному spine сходится больше трафика, чем он способен коммутировать, формальная неблокируемость leaf-уровня не спасает фабрику.
Допустимый коэффициент зависит от нагрузки. Для плотного распределенного обучения ориентиром часто служит 1:1. Для инференса с независимыми репликами может быть допустима переподписка, поскольку межузловой обмен меньше. Решение должно опираться на измеряемый профиль трафика. Проверка неблокирующей коммутации не заканчивается на leaf-уровне — spine должен обслуживать тот же трафик без потерь.
Перед утверждением Fat-Tree проверьте:
- Число downlink-портов на leaf;
- Суммарную полосу uplink к spine;
- Свободные порты и коммутационную емкость spine;
- Симметрию рельсов между leaf-коммутаторами;
- Совместимость режимов breakout и DAC-кабелей на аплинках;
- Число хопов между крайними leaf-коммутаторами;
- Запас портов на spine под будущее расширение.
Добавьте схему отказа одного аплинка и пересчитайте коэффициент в деградированном режиме. Тогда топология будет описывать не только максимальную скорость, но и поведение кластера при обслуживании или неисправности. Деградированный режим показывает, останется ли фабрика неблокирующей при плановом обслуживании одного из аплинков, если коэффициент переподписки в этом сценарии превышает целевой, потребуется резервный порт на spine.