


Минимальный отказоустойчивый кластер — три управляющих узла, два рабочих и инженер на сопровождение. Это цена входа, которую стоит посчитать до начала. Когда сервисов десятки и релизы ежедневные, она оправдана: Kubernetes держит контейнеры в нужном количестве, поднимает упавшие и наращивает копии под спрос. Ниже — устройство кластера, выбор дистрибутива и развертывание через kubeadm, базовые объекты с командами и отечественный Deckhouse. Только то, что нужно для первого живого кластера.
Что такое Kubernetes и зачем он нужен
Оркестрация контейнеров простыми словами
Поднять один контейнер несложно. Беда приходит, когда их набирается десяток: одни падают, трафик прыгает, выкатывать новые версии надо без остановки. Тут и вступает Kubernetes (сокращенно k8s) — держит контейнеры в нужном количестве, поднимает рухнувшие, раскладывает по узлам и наращивает копии под спрос. Так выглядит оркестрация: k8s ведет весь набор контейнеров как единую систему с заданным состоянием.
Когда Kubernetes нужен, а когда нет
Оркестратор — штука сильная, но непростая, и содержать его недешево. Под три сервиса с ровным трафиком он перебор: достаточно виртуалки или Docker Compose. Отдача появляется там, где сервисов десятки, выкаты частые, а нагрузка ходит волнами — и где есть инженер, который возьмет кластер на сопровождение. До выбора оркестратора полезно решить более общий вопрос — контейнеры или виртуальные машины: что выбрать для самих сервисов.
Сколько это стоит на самом деле
Цену входа стоит назвать честно.
Минимальный отказоустойчивый продакшен — это пять серверов: три управляющих узла и два рабочих. Прибавьте инженера, который умеет кластер обслуживать: это либо отдельная позиция в штате, либо заметная часть нагрузки действующего администратора. На фоне такой стоимости три-четыре сервиса с ровной нагрузкой дешевле и надежнее держать на обычной виртуализации. Оркестратор окупается, когда счет сервисов идет на десятки, релизы ежедневные, а ручное управление уже отнимает больше, чем сам кластер.
Связка с Docker и containerd
Внутри кластера контейнеры запускает не сам Kubernetes, а среда исполнения: containerd или CRI-O. Docker занял роль инструмента сборки образов; как среда выполнения внутри кластера он вытеснен более легким containerd. Образы при этом взаимозаменяемы за счет единого стандарта OCI. Независимо от выбранной среды исполнения сначала определите, какое железо нужно под Docker и контейнерные приложения.
Архитектура кластера
Кластер делится на управляющий слой и рабочие узлы. Под них подбирают серверы разной мощности: управляющим важна надежность, рабочим — ресурсы под нагрузку.
Control plane
Управляющий слой (control plane) — командный центр. Сюда входят kube-apiserver (через него проходят все распоряжения), хранилище etcd с состоянием, планировщик scheduler (выбирает узел под контейнер) и controller-manager (выравнивает фактическое состояние с заданным). Отвалился этот слой — рулить нечем, но уже запущенные приложения продолжают крутиться.
Worker nodes
Рабочие узлы (worker nodes) — место обитания самих приложений. На борту у каждого свой kubelet (исполняет указания центра), kube-proxy (заведует сетью) и среда исполнения. Растет нагрузка — досыпают узлов, в этом и заключается горизонтальное масштабирование.
CNI и сеть подов
Связь между контейнерами обеспечивает плагин CNI. Calico — зрелый плагин с поддержкой сетевых политик L3/L4 и BGP-маршрутизацией, Cilium работает на eBPF и добавляет политики уровня L7 со встроенной трассировкой трафика, Flannel закрывает только базовую связность без политик. На старте обычно ставят Calico или Cilium — они закрывают и связность, и сетевую защиту.
CSI и хранилище
Постоянные данные подключают через плагины CSI: они связывают кластер с системами хранения данных и программными хранилищами вроде Ceph или Longhorn. Это нужно для баз данных и всего, что должно пережить перезапуск контейнера.
Выбор дистрибутива Kubernetes
Vanilla Kubernetes и kubeadm
Голый upstream Kubernetes разворачивают штатным kubeadm — это норма для своих кластеров на собственном железе. Контроль полный и устройство как на ладони, зато сеть, хранилище и обновления настраивают руками.
k3s и MicroK8s
Под edge и компактные кластеры придуман k3s — урезанная сборка с идентичным API, работающая от 512 МБ памяти. MicroK8s от Canonical поднимается за минуту одной командой и хорош для разработки и тестов. Оба жертвуют сложностью ради мгновенного старта.
С чего начать новичку
Если опыта с кластером еще нет, не начинайте с боевого kubeadm на пяти серверах. Разумный путь — поднять k3s или MicroK8s на одной виртуальной машине, разобраться с подами, сервисами и манифестами на безопасном стенде. Когда придет понимание, как все устроено, разворачивают полноценный кластер через kubeadm или берут готовый Deckhouse. Так знакомство с технологией обходится без дорогих ошибок на проде.
Deckhouse от «Флант»
Deckhouse — российский enterprise-дистрибутив Kubernetes от компании «Флант», включенный в реестр отечественного ПО. Защищенная редакция Deckhouse Platform Certified Security Edition имеет сертификат ФСТЭК России № 4860 от 04.10.2024 (переоформлен 23.03.2026, действует до 04.10.2029): 4 класс защиты, 4 уровень доверия. Он автоматизирует развертывание и обслуживание кластера без ручной постустановки компонентов, дает вендорскую поддержку в России и подходит для импортозамещения серверов и инфраструктуры, включая объекты КИИ. Управляемый Kubernetes без собственного железа предлагают также Yandex Cloud, VK Cloud и MWS.
Подготовка инфраструктуры
Под боевой кластер закладывают минимум три узла control plane (для кворума etcd) и два рабочих узла. Управляющие узлы размещают на отдельных серверах или ВМ — для удобства подходит конфигурация на трех узлах, которая переживает отказ любого из них.
Сколько узлов и ресурсов
Минимум kubeadm — 2 vCPU и 2 ГБ RAM на узел, этого хватает для стенда. Для продакшена управляющий узел получает 4 vCPU, 8 ГБ RAM и SSD от 100 ГБ под etcd, рабочий начинается от 4 vCPU и 16 ГБ, а дальше ресурсы закладывают под сами приложения. Ступени рабочих узлов под разную нагрузку сведены в статье минимальные требования к серверам для Kubernetes. Кворум etcd требует нечетного числа управляющих узлов — поэтому три, а не два.
Подготовка узлов
На каждом узле проходят обязательную подготовку: гасят swap (без этого Kubernetes не стартует), правят параметры ядра через sysctl, ставят среду исполнения containerd. Пропустишь — кластер не соберется.
На практике подготовка сводится к нескольким командам, которые выполняют на каждом узле от root. Swap отключают сразу и в /etc/fstab, чтобы он не вернулся после перезагрузки. Модули overlay и br_netfilter нужны containerd и сети подов, а пересылка пакетов включается параметром ядра net.ipv4.ip_forward. Команды по порядку:
swapoff -a
sed -i '/ swap / s/^/#/' /etc/fstab
printf 'overlay\nbr_netfilter\n' > /etc/modules-load.d/k8s.conf
modprobe overlay
modprobe br_netfilter
echo 'net.ipv4.ip_forward = 1' > /etc/sysctl.d/k8s.conf
sysctl --system
Установка кластера через kubeadm
Пакеты и инициализация
На все узлы кладут пакеты kubeadm, kubelet и kubectl. Дальше на первом управляющем запускают kubeadm init — она разворачивает control plane и отдает токен для присоединения прочих узлов. Токен бережно сохраняют, он пригодится тут же.
Для отказоустойчивого кластера первый управляющий узел инициализируют с адресом балансировщика, который будет раздавать запросы к API на все три управляющих узла. Параметр --upload-certs сохраняет сертификаты в кластере, чтобы остальные управляющие узлы подключились без ручного копирования ключей. Подсеть подов должна совпадать с настройками выбранного CNI и не пересекаться с офисной сетью:
kubeadm init --control-plane-endpoint <адрес балансировщика>:6443 --upload-certs --pod-network-cidr=<подсеть подов>
Затем копируют файл доступа администратора, после этого kubectl на узле работает без дополнительных настроек:
mkdir -p $HOME/.kube
cp -i /etc/kubernetes/admin.conf $HOME/.kube/config
chown $(id -u):$(id -g) $HOME/.kube/config
В конце вывода kubeadm init печатает готовые команды kubeadm join для управляющих и рабочих узлов.
Установка CNI
Сразу после инициализации ставят сетевой плагин — Calico или Cilium. До этого момента узлы числятся неготовыми: без CNI поды не получают сеть и не запускаются. Это частый ступор новичков — забыли поставить сеть и не понимают, почему ничего не работает.
Calico ставят манифестом, который скачивают из документации проекта под нужную версию, Cilium удобнее ставить через Helm после добавления его репозитория командой helm repo add. Достаточно одного из двух вариантов. Для Calico:
kubectl apply -f calico.yaml
Для Cilium:
helm install cilium cilium/cilium --namespace kube-system
Через минуту-две поды CNI в пространстве имен kube-system переходят в статус Running, а узлы в выводе kubectl get nodes становятся Ready.
Подключение worker nodes
На рабочих узлах выполняют kubeadm join с полученным токеном — узлы присоединяются к кластеру.
Рабочий узел подключают командой из вывода kubeadm init:
kubeadm join <адрес балансировщика>:6443 --token <токен> --discovery-token-ca-cert-hash sha256:<хеш>Управляющему узлу к той же команде добавляют флаг --control-plane и ключ сертификатов, который выдал параметр --upload-certs:
kubeadm join <адрес балансировщика>:6443 --token <токен> --discovery-token-ca-cert-hash sha256:<хеш> --control-plane --certificate-key <ключ>Токен из kubeadm init действует ограниченное время (по умолчанию 24 часа). Если узел добавляют позже, новую команду подключения выдает kubeadm token create --print-join-command на управляющем узле.
Проверка готовности — команда kubectl get nodes: все узлы должны перейти в статус Ready.
Базовые объекты Kubernetes
Pod
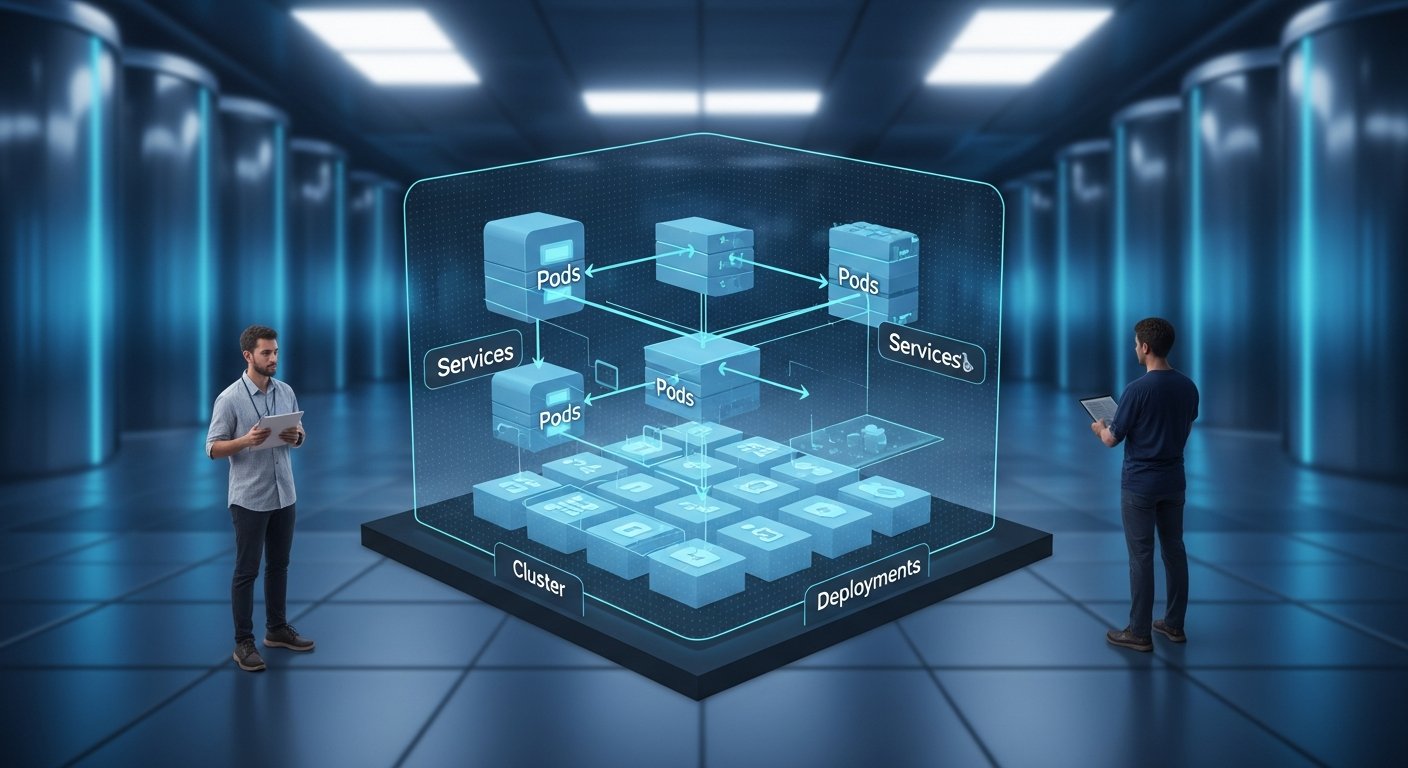
Pod — мельчайший кирпичик кластера, оболочка над одним или несколькими контейнерами с общей сетью. Вручную их почти не плодят: за это отвечают объекты рангом выше.
Deployment и ReplicaSet
Deployment задает, сколько экземпляров приложения держать и каким образом их обновлять. В глубине он рулит объектом ReplicaSet, тот стережет нужное число подов: выпал один — тут же встает свежий. Смена версии идет накатом, без паузы в обслуживании.
Service
Поды живут недолго и то и дело возрождаются с новыми адресами. Service закрепляет за ними постоянную точку входа: обращения летят на него, а он раскидывает их по живым подам. Без этого слоя до приложения было бы не дотянуться.
Как Deployment и Service работают в паре, показывает короткий манифест web.yaml из двух объектов, разделенных строкой из трех дефисов. Ключевые строки такие:
kind: Deployment — объект с именем web, строка replicas: 3 задает три копии пода, а в шаблоне пода указаны метка app: web и контейнер nginx:1.27 с портом 80.
kind: Service — объект с тем же именем, строка type: ClusterIP открывает сервис только внутри кластера, selector с меткой app: web находит поды Deployment, а port: 80 и targetPort: 80 связывают порт сервиса с портом контейнера.
Метка app: web должна совпадать в обоих объектах, иначе Service не найдет поды. Полный шаблон манифеста есть в документации Kubernetes в разделах Deployments и Service. Манифест применяют и проверяют, что поднялись три пода и сервис получил внутренний адрес:
kubectl apply -f web.yaml
kubectl get pods,svc
Ingress
Ingress разруливает входящий HTTP и HTTPS-трафик снаружи: какому домену и пути какой Service подсунуть. По сути это парадная дверь в кластер из интернета, с поддержкой TLS.
ConfigMap, Secret, Namespace
Параметры складывают в ConfigMap, а пароли и ключи — в Secret, лишь бы не вшивать их в образы. Namespace нарезает кластер на логические отсеки — так удобно разводить среды и команды.
Базы данных и stateful-нагрузки
Главная боль новичков — данные с состоянием. Контейнеры по природе одноразовы: упал под — поднялся новый и чистый. Для баз это неприемлемо, поэтому им подключают постоянные тома через PersistentVolume и плагины CSI, а сами базы разворачивают объектами StatefulSet, которые дают подам стабильные имена и привязку к хранилищу. На практике вопрос звучит иначе: стоит ли вообще держать нагруженную базу в кластере. Часто ее оставляют на отдельной выделенной машине или в управляемом сервисе, а в Kubernetes пускают только приложения без состояния — так проще и надежнее.
Управление через kubectl
Просмотр состояния
kubectl — главный рабочий инструмент. Команды get, describe и logs выводят перечень объектов, их детали и журналы контейнеров. С них стартует любой разбор неполадок.
Манифесты и apply
Объекты задают в YAML-манифестах и накатывают через kubectl apply. Подход декларативный: вы фиксируете нужное состояние, а кластер сам к нему стягивается. Манифесты держат в системе контроля версий — это и есть инфраструктура как код.
Отладка и удобные инструменты
Команда kubectl exec открывает оболочку внутри контейнера для отладки. Жизнь упрощают утилиты kubectx и kubens для быстрого переключения между кластерами и пространствами имен, а также интерфейс k9s.
Helm и шаблонизация
Что такое Helm chart
Helm — пакетный менеджер кластера. Helm chart представляет собой параметризованный шаблон набора манифестов: вместо ручного накатывания десятков YAML-файлов приложение разворачивается одной командой с нужными параметрами.
install и upgrade
Команды helm install и helm upgrade разворачивают и обновляют приложения из чартов. Большинство популярного софта — базы, мониторинг, очереди — поставляется готовыми чартами: развертывание занимает одну команду вместо сборки манифестов с нуля.
Helm против Kustomize
Альтернатива Helm — Kustomize: он не шаблонизирует, а накладывает изменения на базовые манифесты. Helm удобнее для готовых продуктов, Kustomize — для тонкой подстройки своих манифестов под разные среды.
Эксплуатация и мониторинг
Prometheus и Grafana
Де-факто стандарт наблюдения — набор kube-prometheus-stack: Prometheus копит метрики, Grafana строит дашборды, Alertmanager рассылает оповещения. Разворачивается единственным Helm-чартом.
Логирование
Логи всех контейнеров стягивают в централизованное хранилище — Loki или стек ELK. Для безопасности их пересылают и в SIEM, чтобы события не терялись на эфемерных подах.
Резервное копирование кластера
Состояние кластера и данные приложений бэкапят инструментами Velero или Kasten K10. Они умеют снимать копии вместе с подключенными томами; данные хранят на отдельном резервном хранилище — это и есть полноценное резервирование контейнерной инфраструктуры.
Сравнение дистрибутивов Kubernetes
| Дистрибутив | Назначение | Особенность |
|---|---|---|
| kubeadm | Боевые кластеры на своем железе | Полный контроль, ручная настройка |
| k3s | Edge и небольшие кластеры | Легкий, от 512 МБ памяти |
| MicroK8s | Разработка и тесты | Старт за минуту одной командой |
| Deckhouse | Корпоративный сегмент в РФ | Автоматизация и поддержка, реестр Минцифры |
Типовые ошибки
kubectl run в проде вместо манифестов
Создавать объекты разовыми командами kubectl run в боевой среде — путь к хаосу: такие изменения нигде не зафиксированы. Все описывают манифестами и хранят в системе контроля версий.
Отсутствие resource limits на подах
Подам не задают resource requests и limits — CPU и Memory. Один сервис с утечкой памяти или бесконечным циклом забирает ресурсы всего узла и кладет соседние поды. Для каждого Deployment прописывают requests (гарантия планировщика) и limits (потолок потребления) — без этого кластер не может корректно распределять нагрузку.
Игнорирование RBAC и Pod Security
Кластер без разграничения прав RBAC и политик безопасности подов — нараспашку. Эти механизмы поднимают и настраивают на старте, а не задним числом после инцидента.
Часто задаваемые вопросы (FAQ)
Что такое Kubernetes простыми словами?
Это система управления контейнерами: сам их запускает, поднимает упавшие, раскладывает по серверам и множит под нагрузку. Коротко — оркестратор контейнеров.
Чем k3s отличается от полного Kubernetes?
k3s — урезанная сборка с идентичным API, но работает от 512 МБ памяти. Берут под edge и компактные кластеры; полноценный Kubernetes на kubeadm — под крупный продакшен.
Сколько узлов нужно для production-кластера?
Не меньше трех управляющих узлов ради кворума etcd плюс два рабочих или больше. Все, что скромнее, отказоустойчивым уже не назовешь.
Что такое Pod, Deployment, Service?
Pod — оболочка над контейнерами, Deployment держит число копий и катит обновления, Service выдает приложению постоянную сетевую точку входа. Опорная тройка объектов.
Какой CNI выбрать: Calico, Cilium или Flannel?
Calico — зрелый универсал с политиками L3/L4 и BGP, Cilium — современный, с политиками L7 на eBPF, Flannel — только базовая связность без политик. Под большинство кластеров идут Calico или Cilium.
Что такое Helm и зачем он нужен?
Helm — пакетный менеджер кластера. С ним готовое приложение разворачивается из чарта одной командой, а не ручным накатом десятков манифестов.
Какие российские варианты Kubernetes есть в 2026?
Основной — Deckhouse от «Флант» в реестре Минцифры. Также управляемые сервисы Yandex Cloud, VK Cloud и MWS.
Можно ли запустить Kubernetes на одном сервере?
Да — для учебы и разработки через MicroK8s, k3s или minikube на единственной машине. Но отказоустойчивости тут нет, и в продакшен такое не пускают.
Перед тем как разворачивать кластер
Прежде чем заказывать серверы и ставить kubeadm, стоит ответить на четыре вопроса. Готова ли команда вести манифесты в Git и строить CI/CD-пайплайн под каждый сервис — без этого кластер быстро превращается в свалку ручных изменений. Есть ли выделенное хранилище под PersistentVolume — базы и очереди требуют надежного CSI-подключения с независимыми снапшотами. Решена ли судьба нагруженных баз данных — нередко их разумнее оставить на выделенной машине, а в кластер пустить только stateless-сервисы. Продумана ли стратегия резервного копирования — Velero или Kasten K10 настраивают до первого инцидента, а не после.
Соберем инфраструктуру под Kubernetes
Разворачиваете Kubernetes-кластер впервые или переезжаете на него с виртуализации? Инженеры Serverzilla подберут серверы под control plane и worker nodes, спроектируют сеть и хранилище, помогут с выбором между Deckhouse и upstream-кластером. Рассчитаем конфигурацию под задачу с запасом под рост числа сервисов. Оставьте заявку.