

Старый сервер — как старая машина: до 5 лет — обычное ТО, к 7 — серьезный ремонт, к 10 — пора подумать, не сменить ли на новую, а к 15 годам — плановый вывод из эксплуатации. В этой статье — практический разбор всех трех сценариев: когда апгрейд сервера экономически оправдан, в какой момент замена сервера дешевле модернизации, и при каких условиях утилизация сервера — единственно правильное решение.
С конкретными цифрами по EoL и EoSL, типовыми лимитами апгрейда RAM, CPU и SSD, требованиями к стиранию данных по NIST SP 800-88 и сертифицированными ФСТЭК средствами, а также регламентами вывода из эксплуатации в соответствии с ФЗ-89.
Три сценария для старого сервера
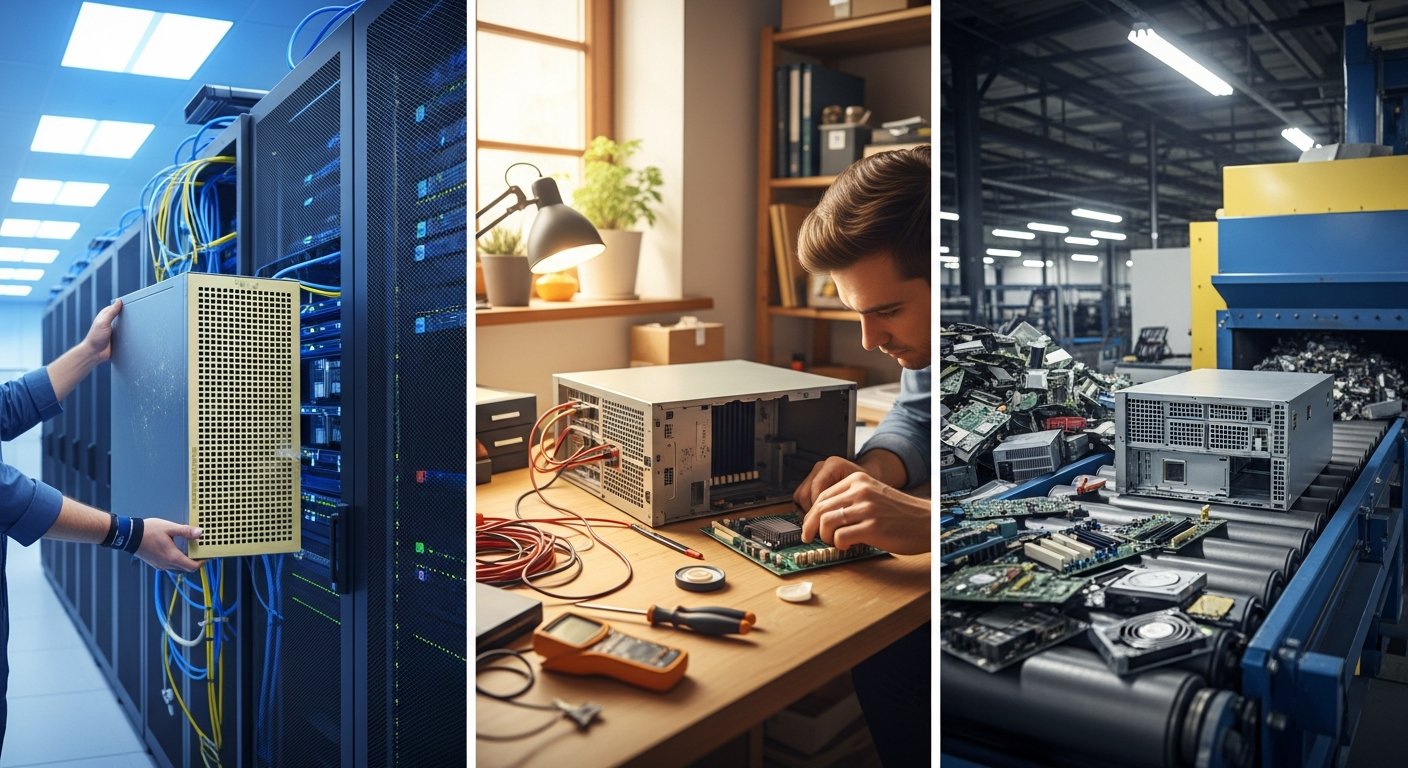
У любого старого сервера три пути дальше: модернизация, замена на новую платформу или вывод из эксплуатации. Разберем, что включает каждый.
Апгрейд: добавляем компоненты в текущую платформу
Апгрейд — самый дешевый путь: вы оставляете существующий корпус, материнскую плату, БП, шасси, но меняете отдельные компоненты. Чаще всего это RAM, диски, CPU в рамках того же сокета, сетевая карта, RAID-контроллер. Затраты ограничены ценой комплектующих и работ по установке. Главное условие — текущая платформа должна поддерживать новые компоненты по версии BIOS, микропрограмма BMC должна быть актуальной, а блок питания должен иметь запас по мощности.
Замена: новая платформа на ту же роль
Замена сервера — полный отказ от старой платформы и переезд на новое железо. Старое уходит на вторичный рынок, в резерв или сразу на утилизацию. Новое подбирается под текущую и прогнозируемую нагрузку. Сценарий применим, когда апгрейд экономически нецелесообразен (тянет половину стоимости нового сервера) или невозможен по техническим причинам (новый CPU не входит в сокет, RAM не поддерживается чипсетом, нет совместимости с современными NVMe).
Утилизация: вывод из эксплуатации и стирание данных
Утилизация — финальный этап жизненного цикла. Сервер перестает быть полезным активом, переходит в разряд отходов производства. Процесс включает формальную процедуру декомиссия (вывод из эксплуатации с актом), стирание данных на всех носителях по сертифицированным методикам, физическое уничтожение HDD/SSD в случае высокого класса конфиденциальности, передачу железа лицензированному утилизатору с актом уничтожения. Без правильной процедуры можно получить штраф по ФЗ-152 или ФЗ-187, если в утиль ушел сервер с персональными данными или элементами КИИ.
Как оценить состояние и потенциал сервера
Перед принятием решения нужна объективная картина: возраст, статус поддержки, производительность относительно нагрузки, журнал отказов. Разберем по шагам.
Возраст и статус поддержки производителя (EoL, EoSL)
EOL (End of Life) — момент, когда производитель перестает продавать модель. EoSL (End of Service Life) — момент окончания поддержки: вендор больше не выпускает прошивки, не закрывает уязвимости, не принимает заявки на гарантийный ремонт. Типовые сроки: EOL через 3–5 лет от выпуска, EoSL — через 5–7 лет. Если вашему серверу 7+ лет и EoSL прошел, у вас в инфраструктуре устаревший актив с растущими рисками. Полную картину по парку даст аудит ИТ-инфраструктуры — с реестром моделей, дат выпуска, статусов поддержки. Если заменить сервер сразу не получается, рабочие стратегии описывает статья о том, как продлить работу сервера после окончания поддержки.
Производительность относительно текущей нагрузки
Старый сервер мог 5 лет назад тянуть нагрузку с запасом, а сейчас работать на пределе. Снимите метрики: средняя загрузка CPU, объем используемой RAM, IOPS на дисках, пропускная способность сети. Если CPU стабильно выше 70%, RAM забита на 90%+ или диски в swap — это снижение производительности относительно требований. Жизненный цикл подошел к концу, нужен либо апгрейд, либо замена.
Энергоэффективность и стоимость электричества
Серверы поколения 2014–2016 годов (Xeon E5 v3/v4) потребляют 200–300 Вт на сокет под нагрузкой. Современные Xeon Scalable 5-го поколения (2024) дают примерно в 1,5–2 раза больше производительности на ватт. В дата-центре, где сервер работает 24/7, это разница в 10–20 тыс руб электричества в год на одну машину. Парк из 20 старых серверов стоит компании 200–400 тыс руб лишних расходов на электричество ежегодно — это серьезный фактор в расчете затраты на эксплуатацию.
Журнал отказов и состояние SMART/SAS-дисков
Откройте журнал событий BMC и SMART-показатели дисков. Если за последний год было несколько замен дисков, отказывал блок питания, регулярно срабатывали датчики температуры — сервер на финишной прямой. SAS-диски обычно живут 5–7 лет, SSD — 3–5 лет интенсивной эксплуатации. Если из 8 дисков уже умерли 3, остальные 5 пойдут следом в ближайшие 6–12 месяцев. Риски отказа становятся неприемлемыми для критичной нагрузки.
Когда апгрейд оправдан
Модернизация дает экономический эффект только при определенных условиях. Разберем четыре ключевых.
Платформа поддерживает нужные CPU/RAM-объемы
Первое условие — текущая материнская плата должна принимать те компоненты, которые вы хотите поставить. У Xeon E5 v3/v4 платформ потолок RAM 768–1536 ГБ на сокет, у Xeon Scalable 2–3 поколения — 4–6 ТБ. Если вы упираетесь в потолок старой платформы, апгрейд не решает проблему. CPU аналогично — нужно проверить совместимость по сокету (LGA 2011-3, LGA 3647, LGA 4189) и микроархитектуре. BIOS должен поддерживать новый процессор, иначе он не запустится.
Узкое место в одном компоненте — диск, RAM или сеть
Если профилирование показало, что 80% проблемы — медленные диски, а CPU и сеть в норме, точечный апгрейд решает все за 10–20% стоимости новой машины. Замена HDD на enterprise NVMe ускоряет 1С и БД в десятки раз. Добавление RAM закрывает проблему swap. Установка 10/25 Gb сетевой карты разгружает интерконнект. Точечный апгрейд эффективнее замены, когда узкое место одно и оно явно идентифицировано.
До списания осталось 1-2 года, апгрейд закроет это окно
Если по плану замены сервер списывается через 1–2 года, нет смысла делать полную замену сейчас. Точечный апгрейд за 100–200 тыс закроет окно до списания. Через год-два уйдет на утилизацию вместе со всем железом, новое поколение к тому моменту станет доступнее по цене и характеристикам. Это типовая ситуация для бюджетов, разнесенных по годам, и для парков с плановой ротацией.
Бюджет не позволяет полную замену прямо сейчас
Иногда деньги на замену есть только в следующем году, а нагрузка растет уже сейчас. Промежуточный апгрейд за 15–25% стоимости новой машины снимает остроту проблемы на полгода-год. После выделения нового бюджета сервер заменяется полностью. Минус подхода — двойные затраты: сначала на апгрейд, потом на замену. Плюс — равномерная финансовая нагрузка без шоковых трат.
Какие апгрейды реально дают эффект
Не все апгрейды одинаково полезны. Разберем четыре варианта по убыванию эффекта.
Замена HDD на enterprise SSD/NVMe — главный буст для 1С и БД
Если в старом сервере стоят 7200 RPM SAS HDD, замена на enterprise SSD дает прирост IOPS в 30–100 раз. Время отклика для 1С падает с секунд до десятых долей. БД на PostgreSQL начинает обрабатывать запросы в разы быстрее. Цена вопроса — 50–150 тыс рублей за пару SSD на 1,92 ТБ. Это самый выгодный по соотношению «эффект на рубль» апгрейд из всех возможных. Подбор подходящих серверов с правильной дисковой подсистемой важен для совместимости — RAID-контроллер должен поддерживать TRIM, иначе SSD деградирует за полгода.
Увеличение RAM до максимума платформы
Второй по эффекту апгрейд — память. Если сервер с 64 ГБ RAM работает в swap, доведение до 256–512 ГБ снимает проблему мгновенно. ECC RDIMM 32 ГБ стоит 8–15 тыс рублей, заполнение всех слотов до 8×32 = 256 ГБ — 60–120 тыс. Для виртуализации и баз данных эффект кратный: одна VM перестает свопиться, новая VM влезает на ту же машину. Главное — проверить, какой тип RDIMM поддерживается (DDR4 vs DDR5, ECC vs не-ECC) и какой максимум на сокет.
Замена CPU в рамках того же сокета и микроархитектуры
CPU можно поменять только на процессоры с тем же сокетом и совместимой микроархитектурой. Например, на платформе LGA 3647 (Xeon Scalable 1–2 поколения) можно поставить более высокую модель — с большим числом ядер или с увеличенной частотой. На Xeon E5 v3/v4 (LGA 2011-3) есть выбор внутри поколения. Эффект обычно 30–50% производительности — не как от полной замены, но заметно. Проверяйте список совместимости в документации производителя и обновляйте BIOS до версии, поддерживающей новый CPU.
Установка 10/25 Gb сетевых карт и быстрого RAID-контроллера
Если сервер стоит в 10 Gb или 25 Gb инфраструктуре, а сам подключен через 1 Gb — это явное узкое место. Установка карты Intel X550-T2 (10 Gb) или Mellanox ConnectX-4 (25 Gb) стоит 25–60 тыс рублей и снимает ограничение. Аналогично для дисковой подсистемы — современный RAID-контроллер с BBU и кэшем 4 ГБ удваивает производительность массива. Главное — проверить совместимость с BIOS и микропрограмма должна корректно распознавать новые устройства.
Когда замена дешевле и проще апгрейда
В ряде ситуаций замена сервера выходит дешевле, чем точечный апгрейд. Разберем четыре триггера.
Сервер старше 7 лет, апгрейд тянет половину стоимости новой машины
Когда сложили в Excel стоимость нужного апгрейда (RAM + SSD + CPU + контроллер + работы) и получили 400 тыс при цене новой машины 800 тыс — точно проще менять. К тому же новая машина даст еще 5–7 лет жизненного цикла, а апгрейд закроет максимум 2–3 года до того же EoSL. Это типовая ситуация для серверов старше 8–10 лет.
Новые поколения CPU дают 2-3× производительности при том же TDP
Производительность процессоров на ватт за последние 10 лет выросла в 4–5 раз. Один новый сервер на Xeon Scalable 5 закрывает задачи двух-трех старых на Xeon E5 v4. Это значит, что замена 6 старых серверов на 2 новых не только освобождает место в стойке, но и экономит 60–70% электричества при той же производительности. Подбор замены под задачу с учетом регуляторики удобно начинать с импортозамещения серверов — там сразу есть Yadro VeGa-S, Аквариус AQ750, Sitronics S-Series под основные сценарии.
Старая платформа не сертифицирована под ФСТЭК / реестр
Для значимых объектов КИИ постановление Правительства № 1912 от 14.11.2023 требует до 01.01.2030 перейти на преимущественное применение доверенных программно-аппаратных комплексов, а статус конкретной модели проверяют по записи в реестре российской промышленной продукции. Старые HPE ProLiant Gen8/Gen9 и Dell PowerEdge R730 в этом реестре не состоят, поэтому на таких объектах их планируют к замене, и апгрейд этого не исправит. В ГИС сертификат ФСТЭК нужен средствам защиты информации, а не самому серверу. Это категоричный случай: либо меняем, либо выводим систему из значимого контура.
Гарантия производителя истекла, запасных частей нет
После EoSL производитель не поставляет запчасти. Если в инфраструктуре произойдет отказ материнской платы или специфического контроллера, замена будет искаться на серых рынках или у б/у-перепродавцов. Совместимость и качество таких компонентов непредсказуемы. Взвесить, стоит ли брать замену на вторичном рынке, помогает разбор «б/у серверы или новые: риски и выгода». Когда вендор ушел из РФ полностью (как это случилось с HPE, Dell, Lenovo в 2022 году), ситуация еще хуже — официальная поддержка недоступна вообще. Замена на актуальное российское железо с реальной гарантией — единственный надежный путь.
Когда стоит сразу утилизировать
Иногда сервер не подлежит ни апгрейду, ни замене на ту же роль — только утилизации. Разберем такие случаи.
Серверы старше 10 лет, EOL и EoSL прошли
Серверы старше 10 лет — однозначные кандидаты на утилизацию. EOL прошел давно, EoSL прошел давно, прошивки не обновляются, уязвимости не закрываются, БП и материнки на грани отказа. Электричества потребляют непомерно, производительности дают в разы меньше современных. Даже как тестовый стенд держать такие машины невыгодно — современный десктоп с i7 будет быстрее старого Xeon E5-2620 v3.
Многочисленные отказы дисков, БП, материнской платы
Если за последний год было 5+ отказов в одном сервере — это критическая масса. Дальше будут отказы материнской платы, BMC, бэкплейна, что эквивалентно полной потере железа. Замена этих компонентов сравнима с покупкой нового сервера. Затраты на бесконечный ремонт превышают цену замены, и при этом риски отказа не уменьшаются, а растут. Однозначная утилизация с заменой на новое.
Несоответствие требованиям регулятора по защите
Регуляторика меняется. То, что 5 лет назад проходило аттестацию, сейчас не проходит. С 01.03.2026 приказ ФСТЭК № 117 обязателен для ГИС и иных информационных систем госорганов, ГУП и госучреждений, коммерческих компаний вне этих систем он не касается. Если старый сервер в такой системе не позволяет выполнить требуемые меры защиты, его выводят из контура и заменяют. Для оценки регуляторных рисков полезен аудит безопасности с проверкой соответствия современным требованиям.
Перевод инфраструктуры на новые платформы и виртуализацию
Когда компания делает технологический скачок — переезд на гиперконвергентную инфраструктуру, контейнеризацию, новый гипервизор — старые серверы часто просто не вписываются в новую архитектуру. Они не поддерживают нужные функции (Intel TDX, AMD SEV, RDMA), не совместимы с новой сетью 25/100 Gb, не имеют PCIe 4.0/5.0 для NVMe-кластеров. В таких миграциях массовая утилизация старого парка — нормальная часть проекта.
Правильная утилизация: данные и железо
Утилизация — это не «выкинуть на свалку». Это формальная процедура с двумя обязательными этапами: стирание данных и физическая утилизация железа.
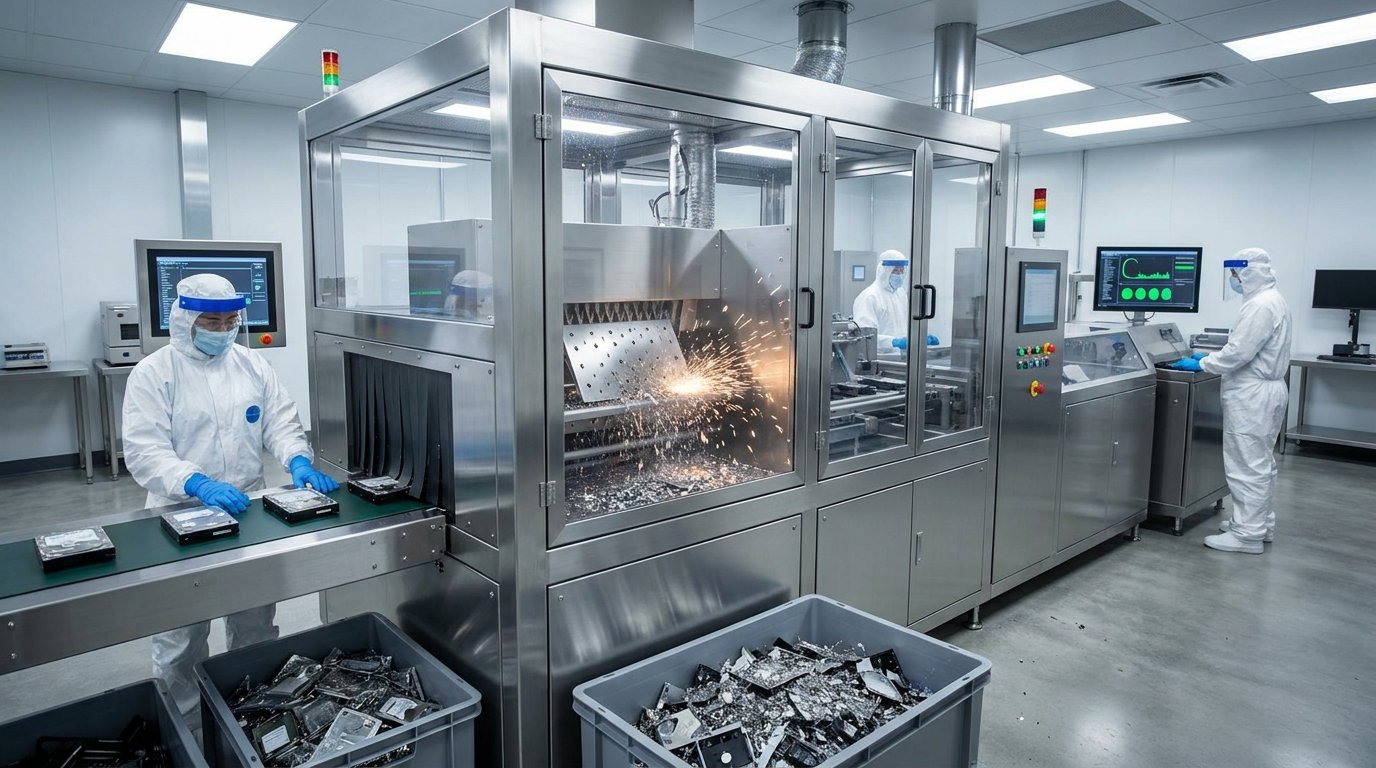
Стирание носителей по NIST SP 800-88 и сертифицированными средствами
Носители стирают по NIST SP 800-88 Rev. 2 (2025) или сертифицированными ФСТЭК средствами гарантированного уничтожения информации. NIST выделяет три уровня: Clear (стандартное затирание), Purge (криптографическое стирание, secure erase) и Destroy (физическое уничтожение). Для HDD с интерфейсом SATA подходит ATA Secure Erase через hdparm, для SSD и NVMe нужны криптографическое стирание или команда sanitize (nvme-cli sanitize либо вендорские утилиты). Утилита DBAN годится только для HDD: на SSD из-за внутреннего перераспределения блоков она не гарантирует удаления данных.
Физическое уничтожение HDD/SSD при высоком классе данных
Для значимых объектов КИИ, ГИС класса К1, ИСПДн уровня 1 одного программного стирания недостаточно — нужно физическое уничтожение носителей. Способы: промышленный шреддер, превращающий диск в стружку, размагничивание HDD сильным магнитным полем (для SSD неэффективно), термическое уничтожение. Процедура оформляется актом с участием комиссии, диски нумеруются и фиксируются в реестре до и после процедуры.
Утилизация металлолома и редкоземельных элементов
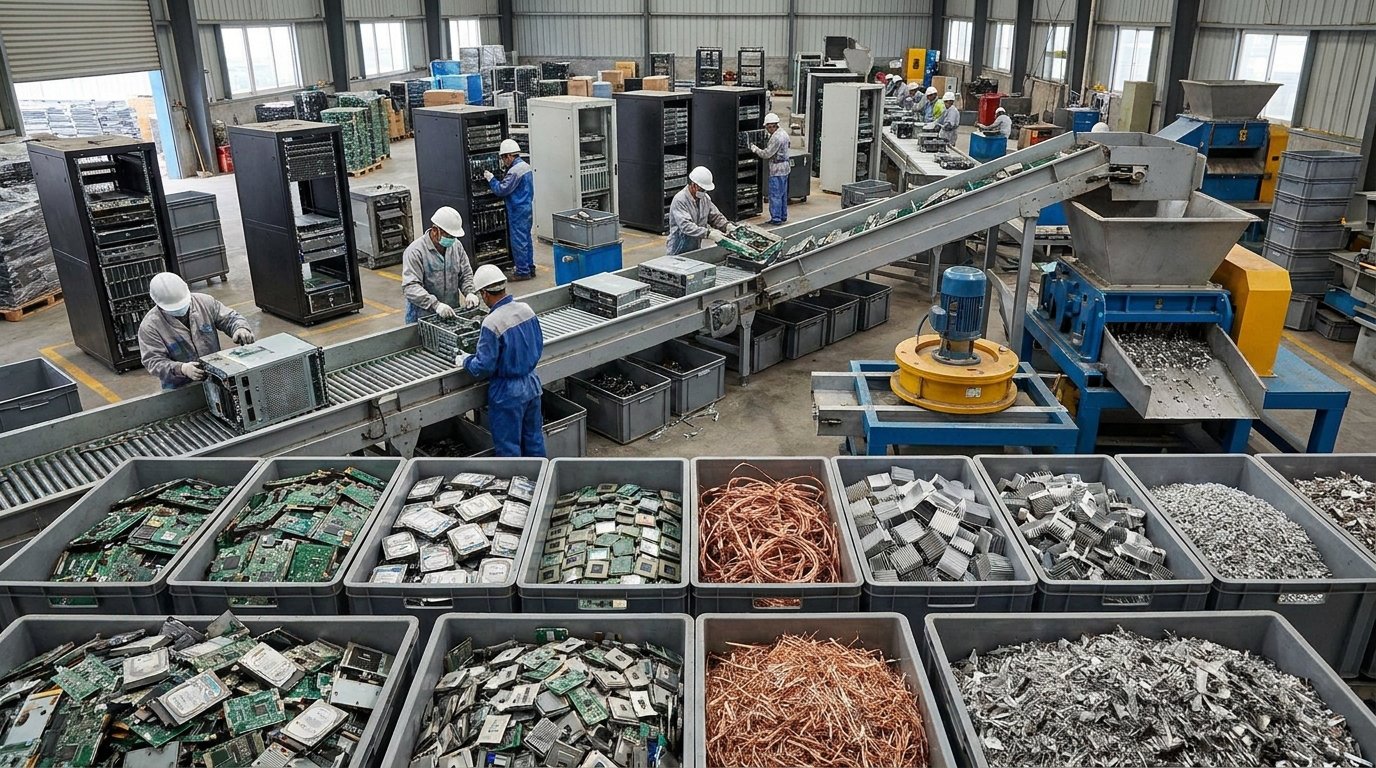
После стирания данных железо передается лицензированному утилизатору. По ФЗ-89 от 24.06.1998 «Об отходах производства и потребления» лицензия нужна исполнителю работ с отходами I–IV классов опасности. Владелец оборудования заключает договор с лицензиатом и хранит договор и акты, а для отходов V класса лицензия не требуется. Утилизатор разбирает сервер на металлолом (медь, алюминий, сталь), извлекает драгоценные металлы из плат (золото в контактах, серебро в пайке) и редкоземельные элементы. Часть стоимости возвращается компании-владельцу как плата за вторсырье — обычно 5–15% от первоначальной цены сервера.
Списание сервера: документы и учет
Финальный этап — документы и бухгалтерский учет. Порядок такой.
- Решение комиссии и акт о списании. Комиссия фиксирует, что сервер непригоден или больше не нужен, и оформляет акт по форме ОС-4 или по форме из учетной политики компании.
- Прекращение признания основного средства. По ФСБУ 6/2020 сервер перестает числиться основным средством, его остаточная стоимость списывается.
- Оприходование годных деталей и лома. Если после разборки остаются годные детали (диски, память, блоки питания) или металлолом, их приходуют по стоимости возможной реализации. Так решается частый вопрос, приходуется ли сервер в утиль: сам сервер списывают, а то, что от него осталось и имеет ценность, ставят на учет.
- Учет драгоценных металлов. Драгметаллы из плат учитываются и сдаются организациям, которые стоят на специальном учете.
- Документы от утилизатора. Утилизатор выдает акт приема-передачи и акт утилизации. Вместе с ними хранят акт стирания данных с указанием метода и средства стирания и акт физического уничтожения носителей, если оно проводилось.
Как выстроить регламент в компании
Однократная утилизация — это легко. Системный процесс на парк из 50+ серверов — отдельная задача. Разберем четыре элемента регламента.
Реестр серверов с возрастом, EOL и ролями
Заведите таблицу со всеми серверами: модель, серийный номер, дата ввода в эксплуатацию, дата EOL и EoSL, текущая роль, критичность, кто отвечает. Без такого реестра вы не знаете, у каких серверов истек жизненный цикл и какие пора менять. Обновляйте реестр раз в квартал — добавляйте новые поступления, отмечайте утилизированные, корректируйте даты EoSL по обновлениям от вендора.
Триггеры: возраст 5/7/10 лет и порог отказов
Установите формальные триггеры для пересмотра судьбы сервера. 5 лет — плановый аудит компонентов и возможный точечный апгрейд. 7 лет — рассмотрение замены, обновление статуса в реестре. 10 лет — обязательная утилизация, если сервер еще не выведен. Плюс триггер по числу отказов: 3+ отказа за год — внеплановый пересмотр. Триггеры избавляют от субъективности — решение принимается по объективным критериям.
Бюджетирование апгрейдов и замен по годам
Зная парк и его возрастной профиль, можно планировать бюджет на годы вперед. Если в следующем году предстоит заменить 8 серверов, заложите бюджет в текущем. Если через два года — 12 серверов, готовьтесь сейчас. Параллельно стоит пересмотреть расходы на содержание оставшегося парка, и здесь пригодится разбор того, как снизить затраты на обслуживание серверов. Без такого планирования замены идут авральными темпами, переплачиваешь за срочность и логистику. С планированием — равномерная нагрузка на бюджет и понятный горизонт.
Регулярные ревизии вместе с аудитом ИТ-инфраструктуры
Раз в год проводите формальную ревизию парка: какие серверы реально нужны, какие можно вывести из эксплуатации досрочно, какие пора апгрейдить. Лучше совмещать с общим аудитом инфраструктуры — заодно обновляется CMDB, проверяется регуляторное соответствие, выявляются неиспользуемые мощности. Это снижает TCO парка на 15–25% за счет отказа от ненужных машин и оптимизации загрузки оставшихся.
Типовые ошибки
В управлении жизненным циклом серверов есть несколько типовых ошибок, которые повторяются у большинства команд.
Бесконечный апгрейд железа, которому давно пора на пенсию
Самая частая ошибка — добавлять RAM в Xeon E5 v3 пятилетней давности «потому что разъемы пустые», менять диски в сервере 2014 года, ставить новый RAID-контроллер в платформу, которая EoSL прошла. По бухгалтерии каждый шаг обоснован — деталь дешевая. По экономике это путь в никуда: суммарные вложения за 3 года превышают цену новой машины, при этом производительность остается на уровне 2014 года.
Замена без анализа причин: новая железка с теми же проблемами
Вторая ошибка — взять новый сервер по той же спецификации без анализа причин проблем. Если старый тормозил из-за HDD, новый с такими же HDD будет тормозить так же. Если упирался в сеть 1 Gb, нужна замена с минимум 10 Gb. Перед заменой делается профилирование нагрузки: где было узкое место, что должно решиться, как проверить. Подбор замены с учетом этих требований дает реальный эффект, а не просто новую железку.
Утилизация без сертифицированного стирания и риск утечки
Третья ошибка — отдать старый сервер в утиль без стирания данных или со стандартным форматированием. Любой энтузиаст с парой утилит восстановит большую часть данных с такого диска. Если на сервере были персональные данные клиентов, банковская информация, документы по госконтрактам — утечка может стоить компании штрафа по ФЗ-152, проблем с ФСТЭК и репутационного удара. Сертифицированное стирание стоит 500–2000 рублей за диск, штраф за утечку — миллионы.
Сравнительная таблица: апгрейд vs замена vs утилизация
| Параметр | Апгрейд | Замена | Утилизация |
|---|---|---|---|
| Возраст сервера | 3–6 лет | 6–9 лет | 10+ лет |
| Состояние компонентов | Большинство исправно | Узкое место в платформе | Множественные отказы |
| Регуляторное соответствие | Сохраняется | Восстанавливается | Невозможно |
| Затраты | 10–30% от цены нового | 100% | Стоимость стирания + утилизации |
| Эффект на производительность | Точечный, до 2× | Кардинальный, 2–4× | Освобождение ресурсов |
| Жизненный цикл после процедуры | +1–3 года | +5–7 лет | Завершен |
| Налоговый эффект | Доамортизация по компонентам | Новая амортизация на новый ОС | Списание остаточной стоимости |
| Когда применять | Точечное узкое место, бюджет ограничен | Многоплановое устаревание | EoSL прошел, отказы, регулятор |
Стоит ли модернизировать или заменить ваш сервер? Наши инженеры проведут технический аудит, оценят остаточный ресурс и подскажут подходящий путь — апгрейд под точечную задачу, плановая замена или вывод из эксплуатации. Закажите подбор сервера под задачу — на выходе будет понятный план с экономикой по каждому варианту.
Часто задаваемые вопросы (FAQ)
Когда апгрейд сервера выгоднее замены?
Когда стоимость нужного апгрейда не превышает 25–30% цены новой машины, узкое место одно и явно идентифицировано, текущая платформа поддерживает целевые компоненты по BIOS и совместимости, а до плановой замены остается 2+ года. Если хотя бы одно из условий нарушено — замена выгоднее. При апгрейде серверу 7+ лет посчитайте суммарные расходы за горизонт эксплуатации с учетом электричества — часто оказывается, что замена с амортизацией 5 лет дешевле в долгую.
Сколько лет в среднем живет серверная платформа?
Стандартный жизненный цикл серверной платформы — 7–10 лет. Из них первые 3 года — гарантия производителя по умолчанию, до 5–7 лет — расширенная гарантия за плату, дальше эксплуатация на свой страх и риск. EOL обычно наступает через 3–5 лет от выпуска модели, EoSL — через 5–7 лет. После EoSL производитель не обновляет прошивки и не закрывает уязвимости — сервер становится регуляторно небезопасным.
Что такое EoL и EoSL у серверов?
EOL (End of Life) — момент, когда производитель прекращает продажи модели. После EOL новые машины этой модели не выпускаются, но поддержка ранее проданных продолжается. EoSL (End of Service Life) — момент полного прекращения поддержки: нет прошивок, нет гарантийного ремонта, нет запчастей через официальные каналы. После EoSL сервер технически работает, но регуляторно и сервисно перестает считаться поддерживаемым.
Можно ли поставить SSD в старый сервер с RAID-контроллером?
Можно, но с оговорками. Старый RAID-контроллер должен поддерживать SSD (большинство контроллеров после 2014 года поддерживают), иметь актуальную микропрограмма с TRIM, и иметь достаточную полосу пропускания PCIe. Если контроллер старше 2014 года или не поддерживает TRIM — SSD деградирует за 6–12 месяцев из-за отсутствия очистки блоков. В таком случае меняйте сразу и контроллер на современный с TRIM и BBU.
Сколько RAM можно добавить в Xeon E5 / Scalable / EPYC?
Xeon E5 v3/v4 (LGA 2011-3, 2014–2016): до 768 ГБ на сокет с RDIMM, до 1,5 ТБ с LRDIMM. Xeon Scalable 1–3 поколения (LGA 3647, 2017–2021): до 4–6 ТБ на сокет. Xeon Scalable 4–5 поколения (LGA 4677, 2023–2024): до 8–12 ТБ. AMD EPYC Rome/Milan (SP3, 2019–2021): до 4 ТБ. AMD EPYC Genoa/Bergamo (SP5, 2022+): до 6 ТБ. Точный максимум зависит от платформы — смотрите спецификацию материнской платы.
Как правильно стереть данные перед утилизацией?
Для HDD — ATA Secure Erase через hdparm, стирание по NIST SP 800-88 или сертифицированным ФСТЭК средством гарантированного уничтожения информации. Для SSD/NVMe — secure erase через nvme-cli sanitize или вендорские утилиты, которые сбрасывают шифровальный ключ контроллера. Для значимых объектов КИИ и ГИС класса К1 — обязательное физическое уничтожение (шреддер, размагничивание) после программного стирания. Процедура оформляется актом с подписями комиссии.
Что делать, если производитель ушел из РФ?
Если вендор покинул рынок и официальная поддержка недоступна, есть три варианта. Первый — продержаться на запасах запчастей с серого рынка до плановой замены через 1–2 года. Второй — миграция на российские платформы Yadro, Аквариус, Sitronics, Бештау, Гравитон. Третий — переход на услугу managed-инфраструктуры у российского провайдера с заменой парка под ключ. Для значимых объектов второй и третий варианты обязательны по регуляторике.
Можно ли продать старые серверы вторично?
Да, рынок вторичных серверов в РФ активен. Серверы 5–7 лет продаются за 15–30% первоначальной цены при условии исправной работы и комплектности. Серверы 7–10 лет — 5–15%, часто на запчасти. Старше 10 лет — почти всегда на металлолом через утилизатора. Перед продажей обязательно стереть все данные по сертифицированной методике и оформить акт стирания — иначе риск утечки и штрафа по ФЗ-152.
Итоги
Решение по старому серверу принимается по понятному алгоритму. До 5 лет — обычная эксплуатация без вопросов. От 5 до 7 лет — точечный апгрейд по узкому месту: SSD вместо HDD, добавление RAM, замена CPU в рамках сокета. От 7 до 9 лет — полная замена платформы, особенно если регуляторика требует сертифицированного железа или новые поколения дают кратный прирост производительности. От 10 лет — утилизация со стиранием данных по NIST SP 800-88 или сертифицированными ФСТЭК средствами и передача лицензированному утилизатору по ФЗ-89. Системный подход с реестром серверов, триггерами по возрасту и плановым бюджетом снижает TCO парка на 15–25% и устраняет авральные замены. Главное — не путать сценарии: бесконечный апгрейд старого железа и замена без анализа причин стоят компании дороже планового цикла обновления.