

Вопрос, как связать GPU-серверы в кластер, встает после выбора вычислительных узлов и общей топологии. Главная задача — дать каждому ускорителю предсказуемый межузловой путь, а не просто подключить сервер одним быстрым кабелем. В многокарточной системе общий порт становится точкой конкуренции: несколько GPU одновременно передают данные синхронизации и делят одну полосу. Rail-optimized дизайн устраняет этот перекос за счет отдельного сетевого пути на каждый GPU и симметричного соответствия между ускорителями и адаптерами.
Что значит связать GPU-серверы физически и логически
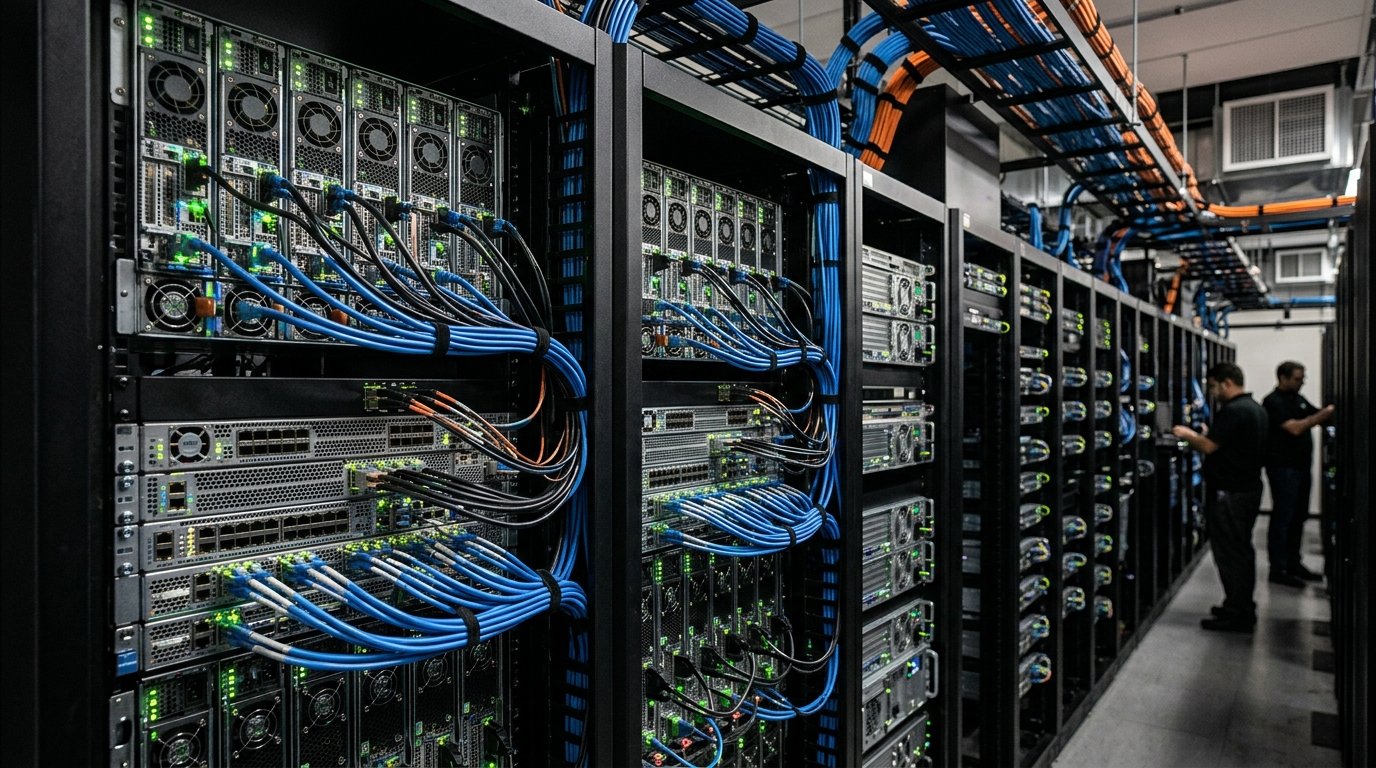
Физическая связь начинается с адаптеров и портов коммутатора. Каждый путь замыкает кабель и должен иметь понятные конечные точки. В монтажной ведомости указывают слот адаптера в сервере и номер порта на коммутаторе. Такой уровень отвечает на вопрос, куда подключен кабель и какой режим соединения поднялся.
Логическая связь описывает, как программный стек видит устройства. Сюда входят адреса интерфейсов и RDMA-устройства. Отдельно задается соответствие между GPU и сетевыми адаптерами. Расположение адаптера относительно сокета GPU тоже влияет на задержку (подробнее — дальше в тексте).
Внутри одного узла карты обмениваются данными через PCIe. Прямые связи строятся на NVLink или NVSwitch. Между узлами используются InfiniBand-адаптеры. Это две разные плоскости. Сервер с NVLink для связи GPU внутри узла не получает межсерверный канал автоматически: для него все равно нужны сетевые карты и внешняя фабрика.
Подключение считается законченным для GPU-кластера, когда совпадают физическая карта портов и логическая карта устройств. Инженер должен видеть, какой GPU использует конкретный HCA и через какой коммутатор проходит трафик. Без такого соответствия диагностика превращается в поиск случайных различий между одинаковыми на вид серверами.
Почему один InfiniBand-адаптер нужен на каждый GPU
Восьмикарточный сервер может отправлять трафик всех GPU через один адаптер. Такая схема технически работает, однако полоса порта делится между восемью источниками. Когда NCCL запускает коллективную операцию, карты одновременно передают данные и конкурируют за очередь. В результате одна быстрая сетевая карта не равна восьми независимым путям.
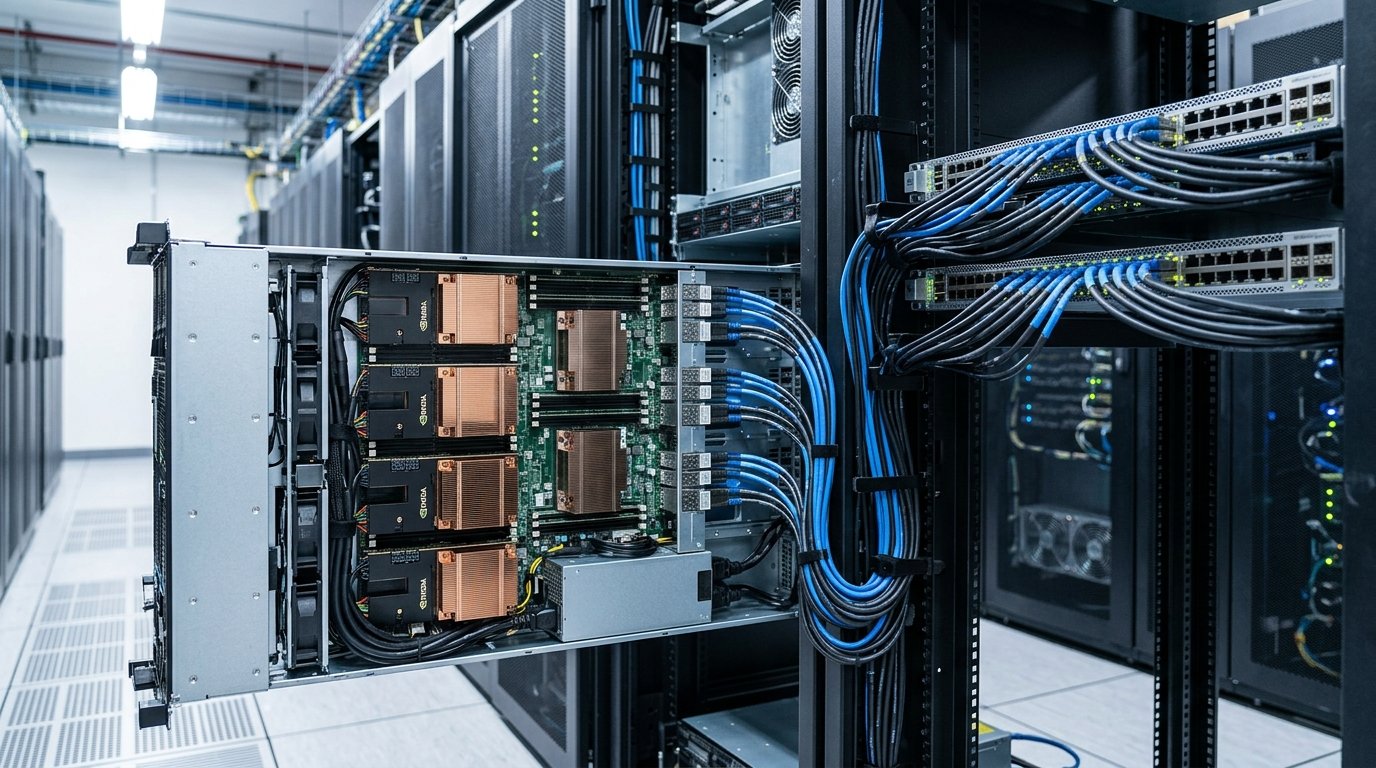
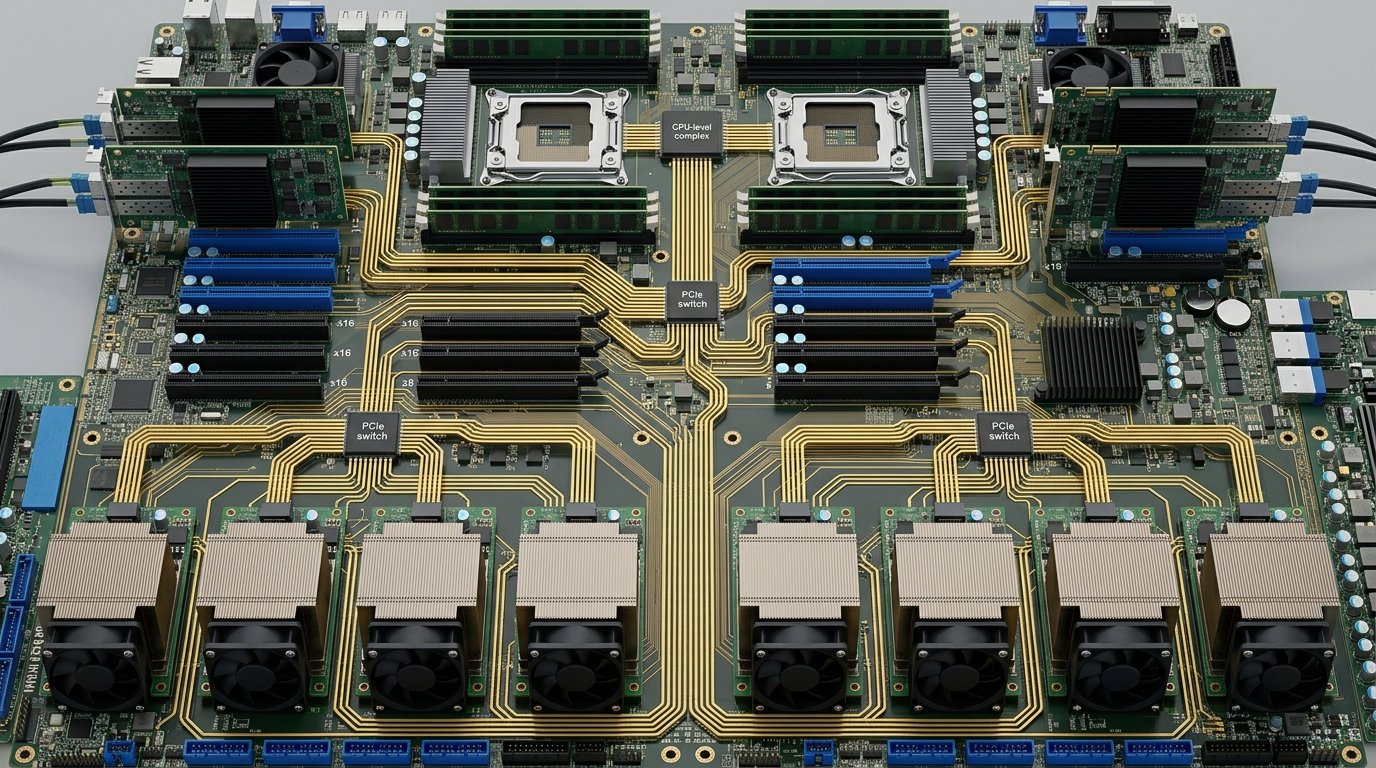
Rail-optimized подход масштабирует число независимых сетевых путей вместе с числом ускорителей. В восьмикарточном узле можно спроектировать восемь сетевых подключений, и на практике это восемь отдельных физических адаптеров, а не один многопортовый: каждый адаптер должен сидеть на том же PCIe-коммутаторе, что и его GPU, а разделение портов одного адаптера между разными ускорителями эту локальность разрушает. Одноименные позиции GPU на разных серверах получают симметричные пути, что уменьшает локальную конкуренцию и упрощает распределение трафика.
Сетевые карты для ИИ-инфраструктуры с поддержкой RDMA должны быть расположены рядом с соответствующими GPU с точки зрения PCIe-топологии. Расположение адаптера относительно сокета GPU тоже имеет значение (см. ниже). Поэтому одного правила по количеству карт недостаточно: нужно проверить локальность GPU, HCA и их PCIe-путь.
Не каждое приложение требует максимального числа адаптеров. Решение зависит от объема межузлового обмена и бюджета. Но если выбрана схема с меньшим числом сетевых путей, ограничение нужно зафиксировать расчетом. Иначе производительность будет сравниваться с rail-optimized конфигурацией, которой физически нет.
Как работает rail-optimized дизайн сети
Рельс объединяет однотипные позиции GPU на разных узлах. Условно GPU0 каждого сервера передает данные через первый адаптер, GPU1 — через второй. Коммутаторы или группы портов образуют параллельные плоскости. NCCL получает несколько независимых путей и может распределять коллективную операцию между ними.
В четырех узлах по восемь GPU можно построить восемь рельсов. Каждый рельс содержит по одному сетевому подключению от каждого сервера, поэтому на стороне узлов получается 32 межузловых подключения. В rail-optimized дизайне это восемь отдельных физических адаптеров на сервер, а не многопортовые карты: разделение портов между рельсами нарушает симметрию путей, на которой строится вся схема. Этот расчет показывает механику связи, но не заменяет проект топологии коммутаторов.
Соотношение GPU и InfiniBand-адаптеров в rail-optimized конфигурации
Число GPU на сервере |
Число InfiniBand-адаптеров (rail-optimized) |
Число независимых рельсов |
Типичный сценарий |
|---|---|---|---|
1 |
1 |
1 |
Единичный сервер, инференс без кластера |
2 |
2 |
2 |
Компактный узел, тестовый стенд |
4 |
4 |
4 |
Средний узел обучения или инференса |
8 |
8 |
8 |
Узел уровня DGX, полная rail-optimized схема |
Ключевое свойство — одинаковая пропускная способность путей. Самый медленный рельс определяет время всей коллективной операции — остальные ее просто ждут. Поэтому проверяют режим порта и ошибки линии. Также сравнивают маршрут и число переходов через коммутаторы.
Rail-дизайн не означает, что один GPU может общаться только с одноименной картой другого сервера. Коллективная библиотека строит обмен между всеми участниками. Рельсы нужны, чтобы трафик входил в фабрику параллельно и не сходился в один локальный адаптер.
Что происходит без прямого соединения GPU-GPU между узлами
Без GPUDirect RDMA данные проходят через оперативную память сервера. GPU копирует буфер в host memory, после чего сетевой адаптер отправляет его на другой узел. Там процесс выполняется в обратном направлении. Дополнительные копирования занимают шину PCIe и требуют участия CPU.
Если все ускорители используют один адаптер, к промежуточным копированиям добавляется конкуренция за порт. Пиковая скорость может выглядеть высокой в одиночном тесте, но при одновременной работе восьми GPU каждому достается только часть полосы. Рост числа карт перестает давать пропорциональное ускорение.
Еще одна проблема — несимметричная PCIe-топология. GPU может находиться на одном сокете, а сетевой адаптер — на другом. Тогда трафик пересекает межпроцессорное соединение. Это увеличивает задержку и создает внутреннее узкое место, которое не видно в спецификации внешней сети.
Прямое межузловое соединение в данном контексте не означает отдельный кабель от каждой GPU к GPU другого сервера. Физически GPU обращается к своему адаптеру, а фабрика доставляет данные на нужный узел. Устранить эту лишнюю копию позволяет отдельный механизм — о нем дальше.
Роль RDMA и GPUDirect при передаче данных между узлами
RDMA позволяет сетевому адаптеру читать или записывать зарегистрированные области памяти с минимальным участием ядра ОС. Это сокращает программный путь и нагрузку на CPU. GPUDirect RDMA расширяет модель на память GPU: адаптер получает прямой доступ к видеобуферу через поддерживаемый PCIe-путь.
NCCL использует доступные транспорты для операций all-reduce и all-gather. При all-reduce каждый участник передает локальные данные, после чего все получают агрегированный результат. Такие операции чувствительны к медленному рангу: если один путь задерживается, завершение ожидают остальные GPU. Именно эта синхронизация градиентов между узлами определяет скорость обучения, поэтому узкое место в сети сводит на нет вложения в сами GPU.
Сетевые карты для серверов должны поддерживаться драйвером RDMA и выбранной версией ОС. Для GPUDirect требуется совместимый драйвер NVIDIA. Нужен также модуль прямого доступа к памяти GPU: без совместимого драйвера адаптер откатится на путь через host memory, даже если InfiniBand-порт поднят и работает исправно.
Поднятый интерфейс RDMA сам по себе не гарантирует, что приложение использует прямой путь к памяти GPU — от этого зависит, будет ли рост числа карт давать пропорциональное ускорение или упрется в промежуточные копирования.
Как проверить, что узлы связаны корректно
Проверка связности проходит по семи шагам — от инвентаризации устройств до документирования эталонных результатов.
- Инвентаризация устройств. На каждом сервере видны все GPU и все InfiniBand-адаптеры, их число сверено с проектом.
- PCIe-топология. Для каждого GPU определен ближайший сетевой адаптер, связь не проходит через лишний процессорный сокет.
- Менеджер подсети. Subnet manager фабрики активен, конфликта нескольких мастеров нет — иначе порты не получат LID и связь не поднимется.
- Состояние портов. Все соединения подняты в расчетном режиме, счетчики ошибок не растут под нагрузкой. Кабель на пониженной скорости делает рельс асимметричным.
- Парные RDMA-тесты. Задержка и пропускная способность сравнены между выбранными адаптерами для одинаковых рельсов — существенное отличие указывает на кабель или порт.
- Тест NCCL на всех GPU. Размеры сообщений близки к рабочей модели, важна не только суммарная полоса, но и масштабирование при добавлении узлов. Просадка при переходе с одного сервера на два — повод проверить интерфейсы и GPUDirect RDMA.
- Документирование. Карта соответствий GPU, адаптер, порт и рельс вместе с эталонными результатами тестов и версиями драйверов превращает схему подключения в проверяемую конфигурацию.
Связывание узлов можно считать завершенным только тогда, когда результат тестов воспроизводится: повторный прогон NCCL после перезагрузки или замены кабеля должен давать те же цифры, что зафиксированы при вводе в эксплуатацию. Если показатели плывут от запуска к запуску при неизменном железе, это признак не сети, а конфигурации — конкурирующего процесса на шине PCIe или неверно закрепленного адаптера за GPU. Проверку стоит повторять после каждого добавления узлов в кластер: растущая фабрика меняет число промежуточных коммутаторов и нагрузку на существующие рельсы, поэтому старые эталонные цифры перестают быть ориентиром для новой конфигурации.