

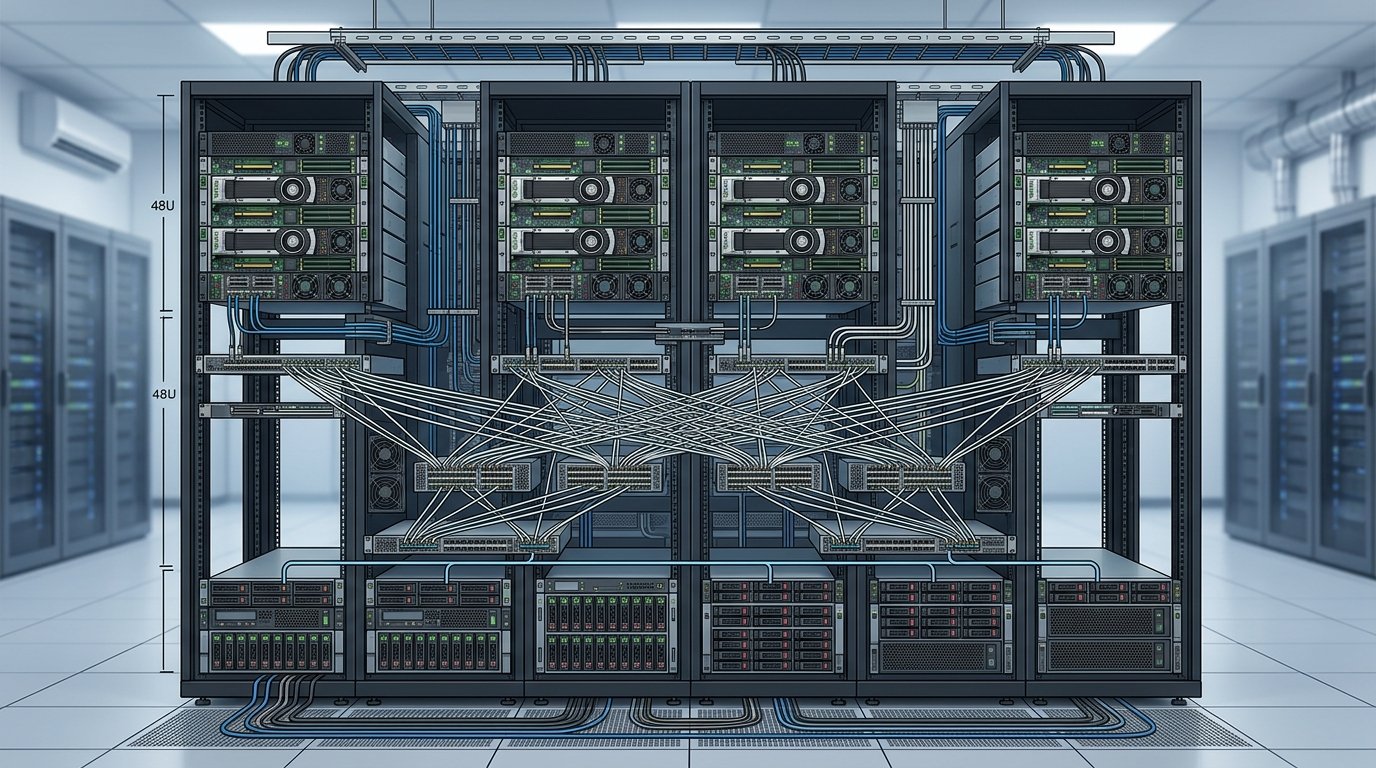
GPU кластер InfiniBand архитектура объединяет вычислительные узлы с сетевой фабрикой. Отдельный контур обслуживает данные. Расчет учитывает порты и кабельную схему, а будущие аплинки фиксируют резервом. Проект начинается с профиля задач: обучение или инференс определяют объем межузлового обмена и требования к хранилищу. Затем компоненты сводят в единую схему, где для каждого соединения известны скорость и назначение. Резерв позволяет проверить спецификацию до закупки и монтажа.
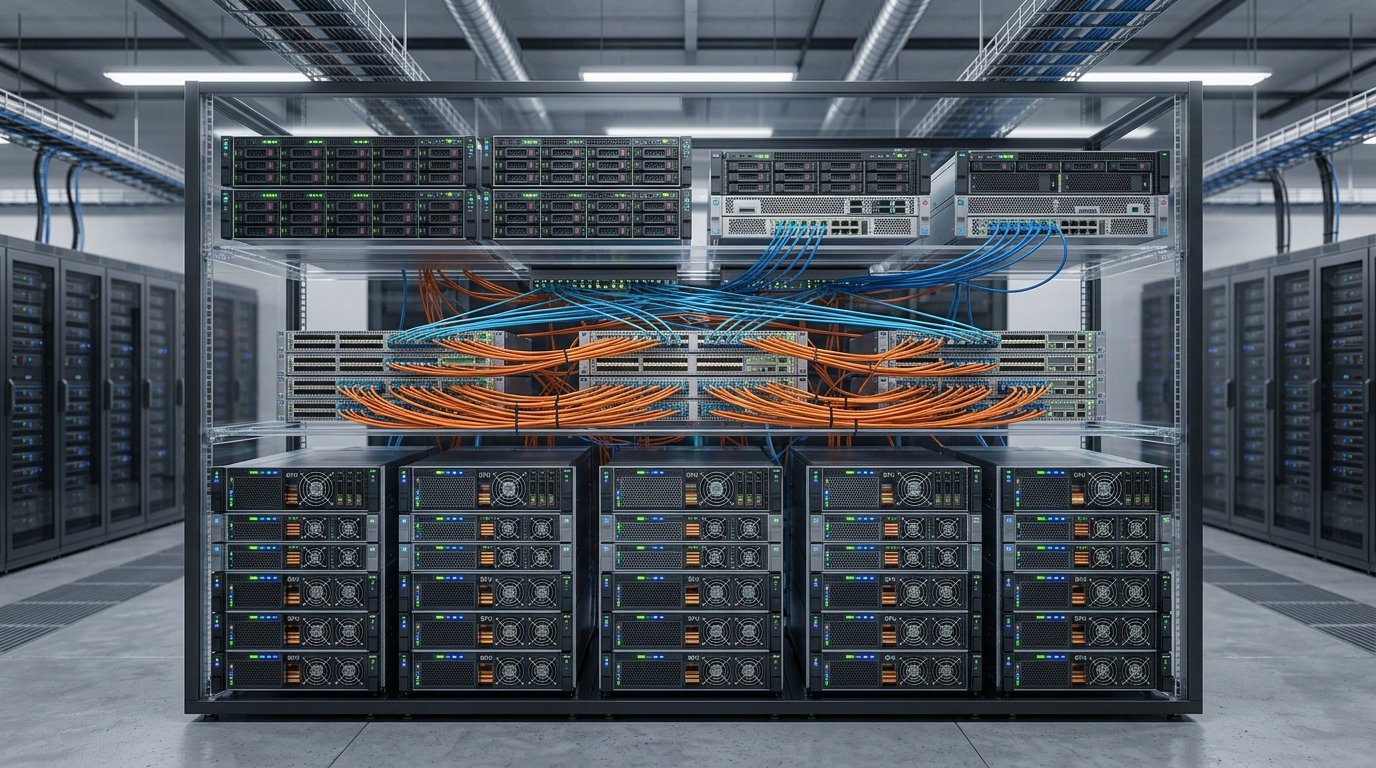
Компоненты GPU-кластера InfiniBand
Компонент |
Что за железо |
Пропускная способность / объем |
|---|---|---|
GPU-серверы |
Стоечный сервер (шасси) 2U-8U, 8-10 ускорителей NVIDIA H100 или A100, связь GPU внутри узла — NVLink или NVSwitch |
До 900 ГБ/с NVLink между GPU узла |
InfiniBand-адаптеры |
Сетевые карты с поддержкой RDMA, в rail-optimized схеме — по адаптеру на каждый GPU |
HDR — 200 Гбит/с, NDR — 400 Гбит/с на порт |
Коммутаторы |
Leaf-уровень для серверов, spine-уровень для связи leaf-коммутаторов в fat-tree |
От единиц до десятков портов на leaf-устройство, аплинки — отдельно |
Кабели |
DAC-сборки и breakout-кабели внутри стойки, оптика между удаленными стойками |
Равна порту адаптера и коммутатора |
Хранилище |
Отдельная сеть для датасетов и контрольных точек, опционально — GPUDirect Storage |
По последовательной пропускной способности и числу клиентов |
Управляющая сеть |
Контур для SSH, мониторинга и развертывания, изолирован от вычислительной фабрики |
Не входит в расчет портов и полосы фабрики |
Из чего состоит архитектура GPU-кластера на InfiniBand
Архитектура InfiniBand-кластера делится на вычислительный и коммуникационный контуры. Первый выполняет операции модели, второй переносит результаты между узлами. Отдельно работает контур хранения и управления. Смешивать эти роли в одной схеме без явных границ нежелательно: служебный трафик может быть небольшим, а синхронизация GPU при распределенном обучении создает кратковременные пики, близкие к полной загрузке фабрики.
Оборудование для ИИ-инфраструктуры подбирают как согласованный набор. Производительность отдельного сервера еще не показывает скорость кластера. Если сеть или хранилище не успевает выдавать данные, часть времени ускорители простаивают. Поэтому спецификация должна содержать не только модели узлов, но и карту всех соединений.
Вычислительные узлы: серверы с GPU
Вычислительный узел — стоечный сервер (шасси) форм-фактора 2U-8U с 8-10 видеокартами, рассчитанный на прямое охлаждение GPU и повышенную нагрузку по питанию. Для задач ИИ применяются NVIDIA H100 и A100. Для отдельных рабочих нагрузок подходит RTX 6000 Ada. Внутри сервера ускорители связываются через NVLink или NVSwitch, чтобы обмениваться данными без выхода в межузловую сеть.
Кроме GPU, узлу нужны процессоры и оперативная память для подготовки данных. Важен также локальный SSD-контур для кеша и временных файлов. Эти компоненты рассчитывают по профилю приложения. Избыточный CPU не компенсирует нехватку видеопамяти, а быстрый локальный накопитель не решает проблему синхронизации между серверами.
Из чего состоит сетевая фабрика кластера
Между узлами данные идут через InfiniBand-адаптеры (сетевые карты с поддержкой RDMA) и коммутаторы. Для задач с прямым доступом к памяти используется RDMA, а GPUDirect RDMA сокращает путь между памятью GPU разных серверов. Поколения HDR и NDR дают разные режимы порта, но в архитектурной схеме важна не одна цифра, а суммарная полоса между всеми участниками коллективной операции.
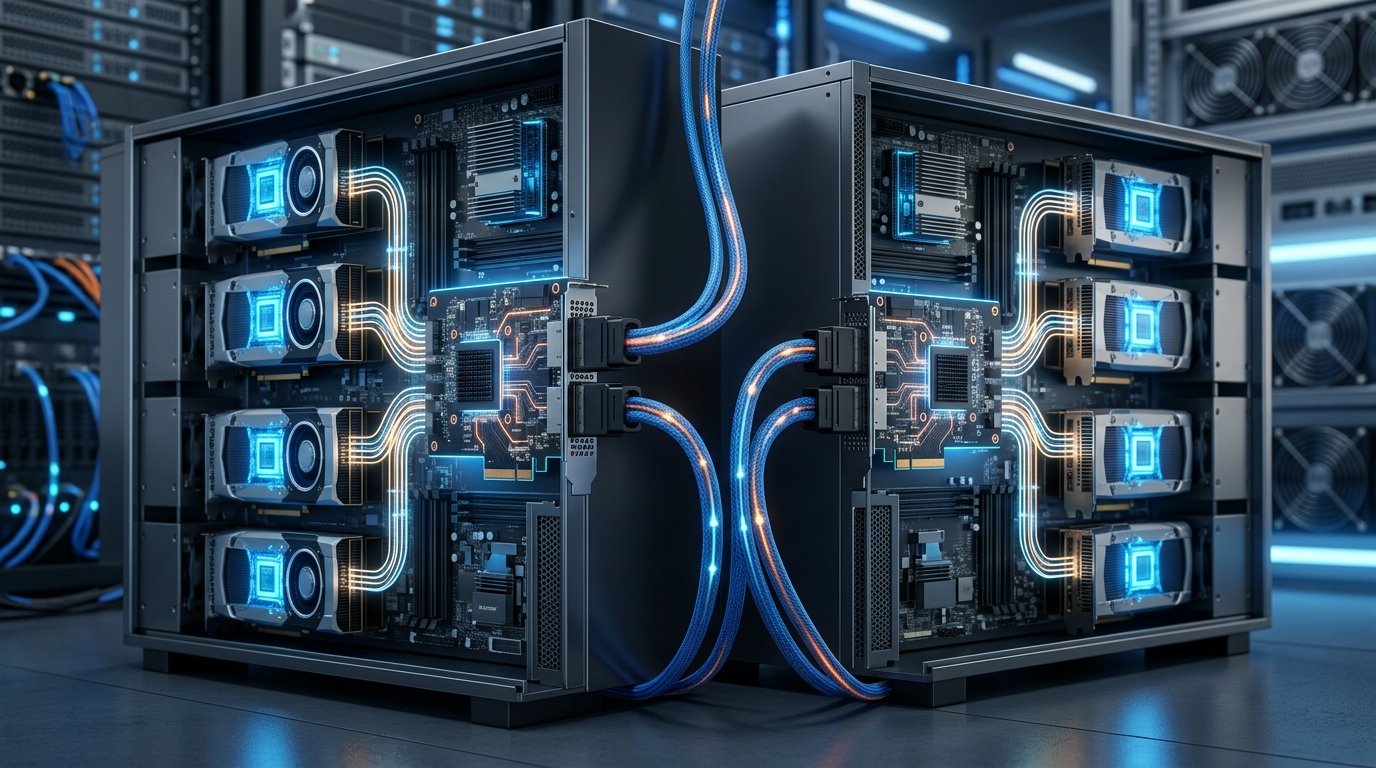
В rail-optimized варианте количество адаптеров связано с числом GPU. Этот принцип здесь нужен как основа расчета, а не как отдельная инструкция по подключению. Если в узле восемь ускорителей, схема может предусматривать восемь сетевых путей. Каждый путь занимает порт коммутатора и требует отдельного кабеля.
Хранилище и оркестрация — второй контур архитектуры
Датасеты и контрольные точки должны поступать к узлам без длительных пауз. Хранилище выбирают по последовательной пропускной способности и числу параллельных клиентов. Оно может подключаться отдельной сетью, чтобы операции чтения не конкурировали с синхронизацией градиентов. Для части задач полезен GPUDirect Storage, однако его применение требует совместимого программного стека.
Оркестрация распределяет задания и следит за состоянием узлов. Контейнеры Docker фиксируют окружение, а фреймворки PyTorch или TensorFlow запускают вычисления. NCCL отвечает за коллективные операции между GPU. Управляющая сеть при этом остается отдельной: через нее работают SSH и сервисы мониторинга и развертывания.
Топология сети: от простой схемы к fat-tree
Топология GPU-кластера до примерно восьми узлов может ограничиваться одним коммутатором. Все адаптеры подключаются к нему напрямую, поэтому схема проста в расчете и диагностике. Ограничением становится число портов: часть емкости желательно сохранить под резерв или подключение следующей группы серверов.
При росте до 16 узлов и более обычно применяют fat-tree. На leaf-уровне находятся соединения с серверами, а spine-уровень объединяет листовые коммутаторы. Цель — предоставить сопоставимую полосу между любыми группами узлов. Коммутаторы для InfiniBand-фабрики в такой архитектуре считаются по нисходящим портам и аплинкам, а не только по общему числу разъемов.
Non-blocking fabric означает, что суммарная полоса вверх от leaf-уровня не меньше полосы вниз к серверам. Если аплинков меньше, возникает переподписка. Она допустима для нагрузок с редким межузловым обменом, но коллективные операции GPU используют сеть одновременно и быстро проявляют дефицит.
Пример расчета: кластер на 4 узла по 8 GPU
4 узла × 8 GPU = 32 GPU → 32 InfiniBand-адаптера → минимум 32 порта leaf-уровня.
Это расчет rail-optimized варианта, где один сетевой путь выделен каждому GPU. Он задает базовую сетевую емкость GPU-кластера до выбора моделей оборудования и не утверждает, что любая модель приложения требует именно такой схемы, но показывает связь между числом ускорителей и сетевой емкостью. В качестве отправной точки для вычислительных узлов можно рассматривать конфигурацию сервера на 8 GPU для корпоративных ИИ-задач, после чего проверять ее под конкретную модель и режим обучения.
Сколько адаптеров и портов коммутатора нужно
Если выбран один коммутатор, из 32 сетевых подключений каждому нужен минимум один порт leaf-уровня. Практическая спецификация должна иметь запас: отдельные порты могут потребоваться для тестового узла или сервисного оборудования. При переходе к fat-tree часть портов leaf-коммутаторов уйдет на аплинки.
Если используется два leaf-коммутатора, подключения распределяют симметрично. Например, каждый обслуживает половину сетевых путей. Затем рассчитывают связи со spine-уровнем. Переподписка здесь считается так же, как в общей схеме fat-tree выше — по соотношению портов вниз и аплинков.
Сколько кабелей и какой пропускной способности закладывать
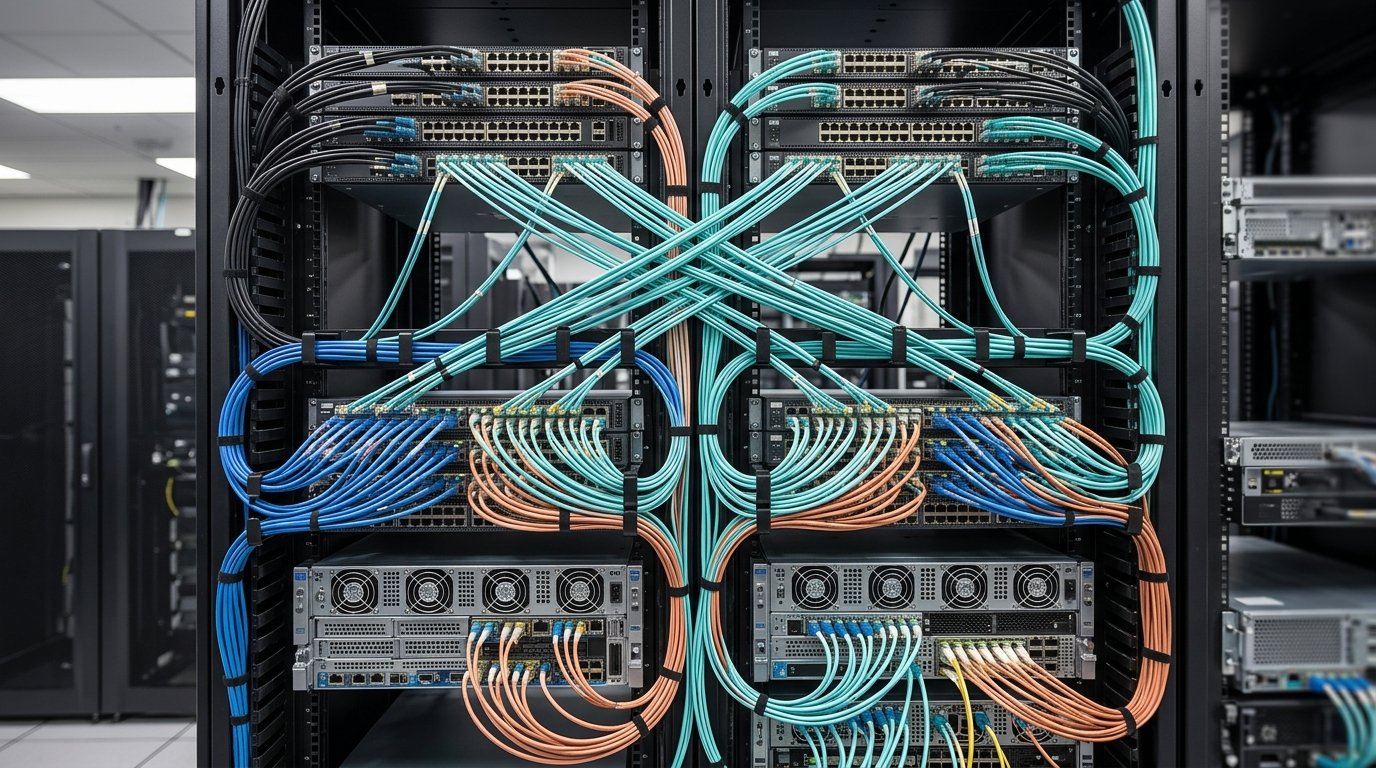
Каждое из 32 подключений — это один физический кабель. Для коротких трасс внутри стойки применяют DAC-сборки, включая breakout-кабели. Между удаленными стойками используют оптику. В ведомости кабелей указывают обе точки подключения и длину, чтобы не смешивать логическую схему с монтажным планом.
Скорость канала должна соответствовать адаптеру и порту коммутатора. HDR поддерживает до 200 Гбит/с, NDR — до 400 Гбит/с. Смешение поколений возможно только при заранее понятном режиме работы. В противном случае часть фабрики будет ограничена медленным звеном.
Числовой расчет дополняет существующий материал о сборке GPU-кластера из нескольких серверов: там компоненты описаны обзорно. Здесь формула показывает связь между GPU и адаптерами, а портовая емкость рассчитана отдельно.
Последовательность проектирования: от требований к готовой схеме
- Зафиксируйте модель нагрузки: определите число GPU и объем памяти на узел, оцените частоту коллективных операций. Затем выберите уровень связи внутри сервера и межузловой транспорт.
- Постройте логическую схему: дайте каждому GPU сетевой путь, на схеме покажите адаптер и порт коммутатора. После этого подсчитайте нисходящие соединения и зарезервируйте аплинки.
- Составьте физический план: разместите узлы по стойкам, измерьте кабельные трассы и проверьте питание. Плотный GPU-сервер выделяет больше тепла и повышает энергопотребление стойки по сравнению с обычным сервером того же форм-фактора, поэтому размещение нельзя отделять от охлаждения площадки. Если поток воздуха от сервера идет против общей вентиляции зала, оборудование перегревается и снижает частоту работы — это стоит сверить до монтажа, а не после первого прогрева.
- Сформируйте программный контур: сверьте версии драйверов NVIDIA и CUDA до включения нагрузки, а не после — несогласованные версии часто становятся причиной сбоев при первом запуске. Проверьте NCCL и RDMA-стек. Только после этого спецификация становится полной: она описывает оборудование и соединения, а среда запуска фиксируется отдельной матрицей.
Как масштабировать архитектуру при росте числа узлов
Вам проще масштабировать архитектуру, если целевой предел определен заранее. Коммутатор с заполненными портами не оставляет места даже для одного дополнительного сервера, значит, в первой закупке полезно резервировать емкость под следующий этап, но не покупать неиспользуемую фабрику без плана.
При переходе от одного коммутатора к fat-tree меняется не только число устройств. Появляются аплинки и spine-уровень. Кабельная система усложняется, а Subnet Manager должен видеть всю фабрику. Заранее предусмотренные места для будущих leaf-коммутаторов избавляют от полной перекоммутации.
Хранилище масштабируют независимо от вычислительных узлов. Рост GPU увеличивает как потребление данных, так и объем контрольных точек. Если сеть хранения остается прежней, загрузка датасета может стать новым ограничением после устранения межузлового узкого места.
Типичные архитектурные ошибки при проектировании кластера
- Считать только серверы и GPU. В итоговый бюджет не попадают сетевые адаптеры и трансиверы. Отдельно забывают про кабели. После этого сеть упрощают уже во время закупки, и расчетная производительность перестает соответствовать проекту.
- Использовать один высокоскоростной порт на весь многокарточный узел без оценки конкуренции. Такая схема может работать, но ее полоса делится между ускорителями. Для связных задач это снижает эффективность масштабирования.
- Выбирать топологию без профиля трафика. Простое дерево с высокой переподпиской подходит не каждой нагрузке. All-reduce создает одновременный обмен и требует достаточной полосы между уровнями.
- Не отделять вычислительную фабрику от управляющей сети. Служебные операции и пользовательский доступ не должны влиять на измерение производительности InfiniBand. Раздельные контуры упрощают мониторинг и поиск неисправностей.
Перед утверждением проекта проверьте:
- Формулу числа адаптеров;
- Карту портов;
- Ведомость кабелей;
- Запас аплинков;
- Программную матрицу;
- Разделение вычислительной фабрики и управляющей сети.
Если каждый пункт связан с исходным требованием, архитектуру можно переводить в закупочную спецификацию. Если связь потеряна, дополнительная мощность одного компонента не гарантирует ускорения всего GPU-кластера.