

Что такое RDMA, нужно понять до обсуждения сетевых карт и коммутаторов для GPU-кластера. Этот механизм позволяет сетевому адаптеру передавать данные в память удаленного узла без обычной цепочки копирований через ядро операционной системы. CPU реже участвует в обработке пакетов, а приложение получает более короткий и предсказуемый путь обмена. Для распределенного обучения это означает, что синхронизация между серверами меньше задерживает GPU и лучше использует пропускную способность межузловой сети.
Что такое RDMA простыми словами: прямой доступ к памяти в обход CPU
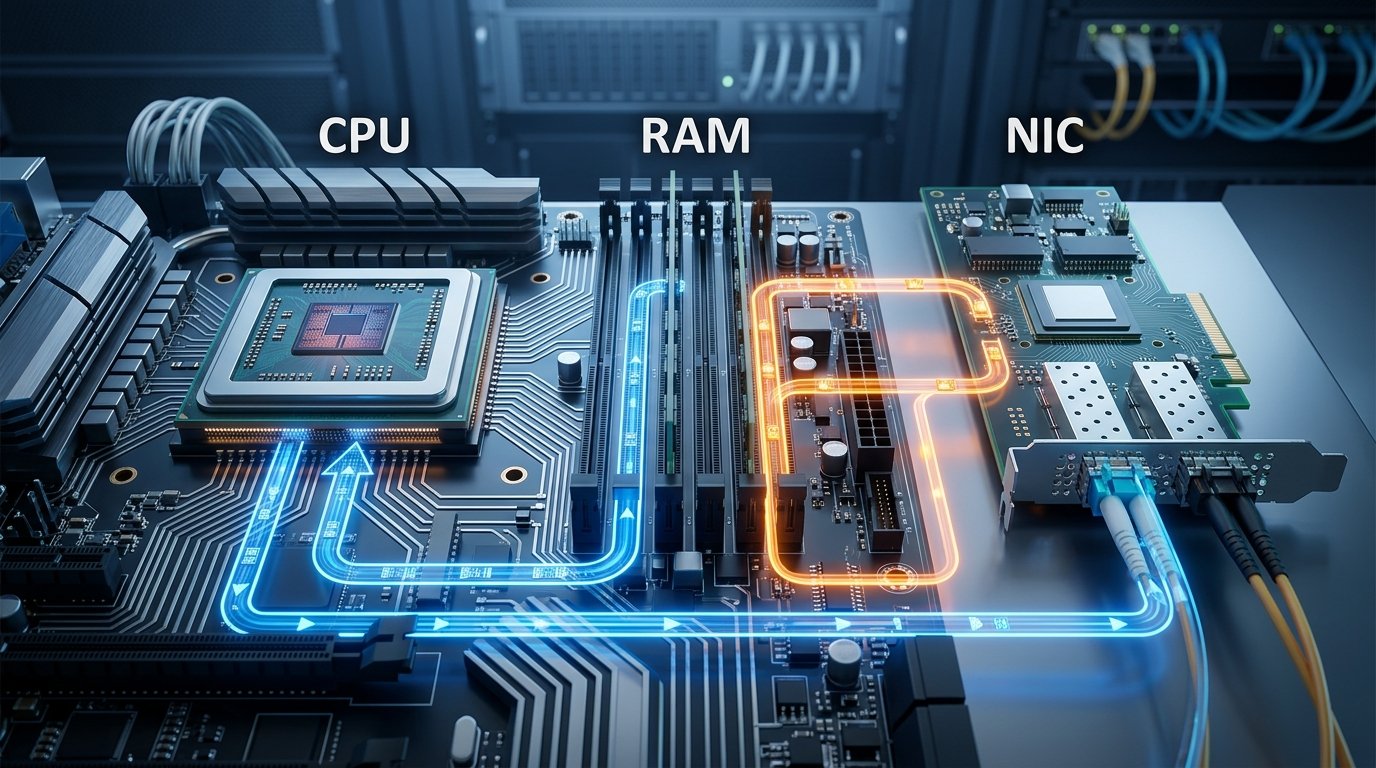
В обычной сетевой передаче данные проходят через несколько программных уровней. Приложение обращается к системному вызову, после чего ядро обрабатывает буферы. CPU участвует в копировании и управлении очередями. Каждый переход добавляет работу и задержку. При интенсивном обмене эти операции повторяются настолько часто, что процессор тратит заметную часть времени не на задачу приложения, а на обслуживание сети.
RDMA, или Remote Direct Memory Access, переносит основную работу на сетевой адаптер. Приложение заранее регистрирует область памяти, после чего удаленное устройство может читать из нее или записывать в нее по согласованным правилам. Передача остается контролируемой: доступ разрешен только к зарегистрированному буферу и требует корректных ключей доступа — своего рода пропуска, который действует только на эту область памяти и не подходит для любой другой. Разница заключается не в отмене защиты памяти, а в устранении лишних переходов по стеку ОС на каждом сообщении.
Такой подход часто называют zero-copy, хотя буквально полное отсутствие копирований зависит от конкретной реализации. Практический смысл термина — данные не должны несколько раз перемещаться между пользовательским буфером и памятью ядра. Адаптеры для ИИ-инфраструктуры обрабатывают очереди обмена аппаратно и снижают нагрузку на CPU. Освободившиеся процессорные ресурсы остаются доступными для подготовки данных и управления вычислительным заданием.
Так выглядит разница по ключевым параметрам:
Сравнение обычной передачи и RDMA
| Параметр | Обычная передача данных | RDMA |
|---|---|---|
| Роль CPU | Копирует данные и управляет очередями на каждом этапе | Сетевой адаптер обращается к памяти напрямую, CPU разгружен |
| Путь данных | Через системный вызов и буферы ядра ОС | По заранее зарегистрированному буферу приложения |
| Копирования | Несколько копирований между буфером приложения и памятью ядра | Близко к zero-copy, но зависит от конкретной реализации |
| Задержка | Растет с интенсивностью обмена из-за повторяющихся переходов по стеку ОС | Короче и предсказуемее |
Чем RDMA отличается от InfiniBand: протокол и транспорт — не одно и то же
RDMA — это протокол прямого доступа к памяти и модель обмена, а не сеть. InfiniBand — это транспорт: сетевая фабрика, через которую передаются сообщения. Из-за этого утверждение «кластер использует RDMA» еще не отвечает на вопрос о физической сети, а фраза «установлен InfiniBand» не раскрывает, какие программные интерфейсы применяет приложение.
InfiniBand изначально создавался с поддержкой удаленного доступа к памяти. Он включает адаптеры и коммутаторы, а также собственные механизмы управления фабрикой. RDMA поверх него получает согласованную транспортную среду с контролем потоков и маршрутизацией. Но сам принцип прямого доступа не привязан только к этой технологии: его можно реализовать и поверх Ethernet.
Разграничение полезно при разговоре с интегратором. В техническом задании отдельно фиксируют требования к механизму RDMA и к сети, которая его переносит. Иначе две разные задачи сливаются в один термин, а совместимость драйверов и коммутаторов остается неявной. Для GPU-кластера это особенно опасно, поскольку ошибка проявится не при обычной проверке доступности узла, а под нагрузкой коллективных операций.
Чем RDMA поверх InfiniBand отличается от RDMA поверх Ethernet (RoCE)
RDMA over Converged Ethernet (RoCE) переносит операции прямого доступа к памяти через Ethernet. При первом упоминании важна полная расшифровка: аббревиатура RoCE без контекста также встречается в финансовой терминологии. В сетевой инфраструктуре обычно обсуждают RoCE v2, где трафик маршрутизируется по IP и может проходить между сегментами.
Главное различие находится не в API приложения, а в свойствах транспорта. InfiniBand представляет собой специализированную фабрику, где управление потоками и маршрутизация проектировались для высокопроизводительного обмена. RoCE использует Ethernet-инфраструктуру и требует аккуратной настройки потерь — в частности, очередей и приоритетов. Если сеть допускает перегрузку и отбрасывание пакетов, задержка может стать менее предсказуемой, даже когда номинальная скорость порта выглядит достаточной.
Преимущество RoCE — возможность строить единую Ethernet-среду и использовать знакомые операционные процессы. Преимущество InfiniBand — более цельная модель специализированной фабрики. Выбор зависит от компетенций команды и масштаба кластера. Серверные сетевые адаптеры с поддержкой RDMA нужно сопоставлять по скорости и режиму транспорта, а также проверять версии драйверов и требования к коммутаторам.
Ключевые различия между транспортами — в таблице:
Различия InfiniBand и RoCE
| Параметр | InfiniBand | RoCE |
|---|---|---|
| Транспортная среда | Специализированная фабрика, спроектированная для высокопроизводительного обмена | Существующая Ethernet-инфраструктура |
| Маршрутизация | Собственные механизмы управления фабрикой, заложенные в архитектуру | RoCE v2 маршрутизируется по IP и проходит между сегментами |
| Настройка | Управление потоками спроектировано изначально | Требует аккуратной настройки потерь, очередей и приоритетов |
| Преимущество | Более цельная модель специализированной фабрики | Единая Ethernet-среда и знакомые операционные процессы |
GPUDirect RDMA: прямой обмен данными между GPU без участия CPU
Классический RDMA сокращает путь между памятью серверов. GPUDirect RDMA идет дальше и позволяет сетевому устройству обращаться непосредственно к памяти GPU. Без этой технологии данные сначала копируются из видеопамяти в оперативную память узла, после чего сетевой адаптер отправляет их на другой сервер. На принимающей стороне цепочка выполняется в обратном порядке.
При прямом пути промежуточный буфер в памяти CPU не требуется для каждой передачи. Это уменьшает число копирований и снижает нагрузку на шину между процессором и ускорителями. Эффект особенно заметен, когда обмен состоит из крупных массивов градиентов и повторяется на каждом шаге обучения. При этом GPUDirect RDMA не заменяет сетевую фабрику: он оптимизирует доступ к памяти, а физическая передача по-прежнему зависит от InfiniBand или корректно настроенного RoCE.
Внутри одного сервера GPU могут быть связаны через NVLink или NVSwitch. Между серверами действует другой уровень соединения, где участвуют сетевые адаптеры. В результате подбор сервера с объединением GPU через NVLink и RDMA требует согласовать обе плоскости. Быстрая локальная шина не компенсирует медленную межузловую сеть, а широкая фабрика не устранит ограничения внутри узла.
Зачем RDMA нужен при распределенном обучении нейросетей
При распределенном обучении каждый GPU вычисляет локальные результаты, после чего участники должны синхронизировать параметры. Библиотека NCCL выполняет коллективные операции, включая all-reduce. В такой операции данные от всех рангов агрегируются, а итог становится доступен каждому участнику. Пока обмен не завершен, следующий шаг вычислений часто не может продолжаться.
RDMA сокращает программную задержку на пути сообщения и освобождает CPU от обработки каждого пакета. Это важно не только для одной крупной передачи. Рабочая нагрузка состоит из множества операций разного размера, поэтому стабильная латентность влияет на общий темп задания. Если один узел регулярно завершает обмен позже, остальные ускорители ожидают его, и эффективность масштабирования падает.
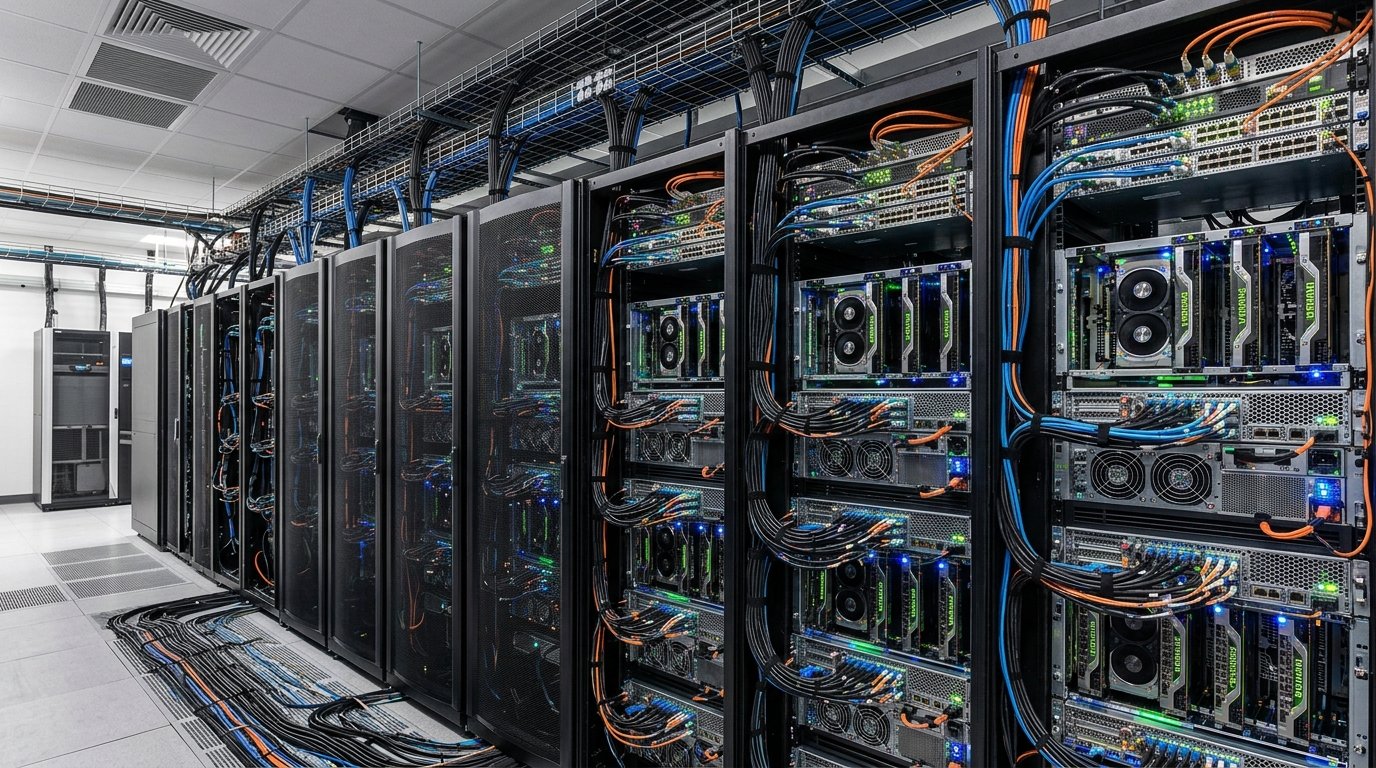
С ростом числа ускорителей объем сетевого обмена увеличивается, поэтому платформы класса HGX или DGX настраивают вместе с коммуникационным стеком с самого начала. Характерный пример — GPU-серверы на 2U-8U с 8-10 видеокартами NVIDIA H100, A100 или (для отдельных задач) RTX 6000 Ada, где нагрузка на сеть растет быстрее, чем на один узел. Драйверы NVIDIA и CUDA обеспечивают работу устройств, а NCCL выбирает доступные пути между GPU.
Где чаще применяют RDMA поверх InfiniBand, а где RoCE
InfiniBand обычно выбирают для выделенных HPC- и GPU-кластеров, где фабрика создается как самостоятельная среда. Команда получает единый набор механизмов управления и может проектировать сеть под коллективные операции. Этот подход удобен, когда узлы плотно взаимодействуют и стоимость простоя GPU выше, чем экономия на унификации транспорта.
RoCE чаще рассматривают в дата-центрах с развитой Ethernet-экспертизой. Он позволяет использовать маршрутизируемую IP-сеть — но именно та аккуратная настройка потерь, о которой шла речь выше, здесь становится постоянной эксплуатационной задачей, а не разовой настройкой при вводе в строй. Для небольшой тестовой системы такой вариант может быть проще организационно. Для крупного кластера его качество определяется не наличием надписи RDMA на адаптере, а поведением всей фабрики под одновременным трафиком.
Оба варианта нуждаются в согласованном программном стеке. Перед вводом в эксплуатацию проверяют:
- Версию драйвера RDMA;
- Версию CUDA;
- Результаты тестирования коллективных операций NCCL на реальных размерах сообщений.
Синтетическая пропускная способность одного канала не показывает, как сеть поведет себя при синхронизации десятков GPU.
Перед выбором транспорта полезно ответить на два вопроса. Первый — строится ли отдельная вычислительная фабрика или RDMA должно войти в существующий Ethernet. Второй — кто будет поддерживать настройки перегрузок и маршрутизации после ввода в эксплуатацию. Эти ответы определяют не только начальную конфигурацию, но и предсказуемость сети при масштабировании кластера. Если ответ на оба вопроса пока не готов, разумно закладывать в проект поддержку обоих сценариев на уровне выбора сетевых адаптеров — переход с RoCE на InfiniBand постфактум почти всегда означает замену адаптеров и коммутаторов, а не только перенастройку.